AI 原生系列 · 智能体化设计
Visionboard:把 Life GPS 重建成智能体驱动的路线图,人类站在循环之上
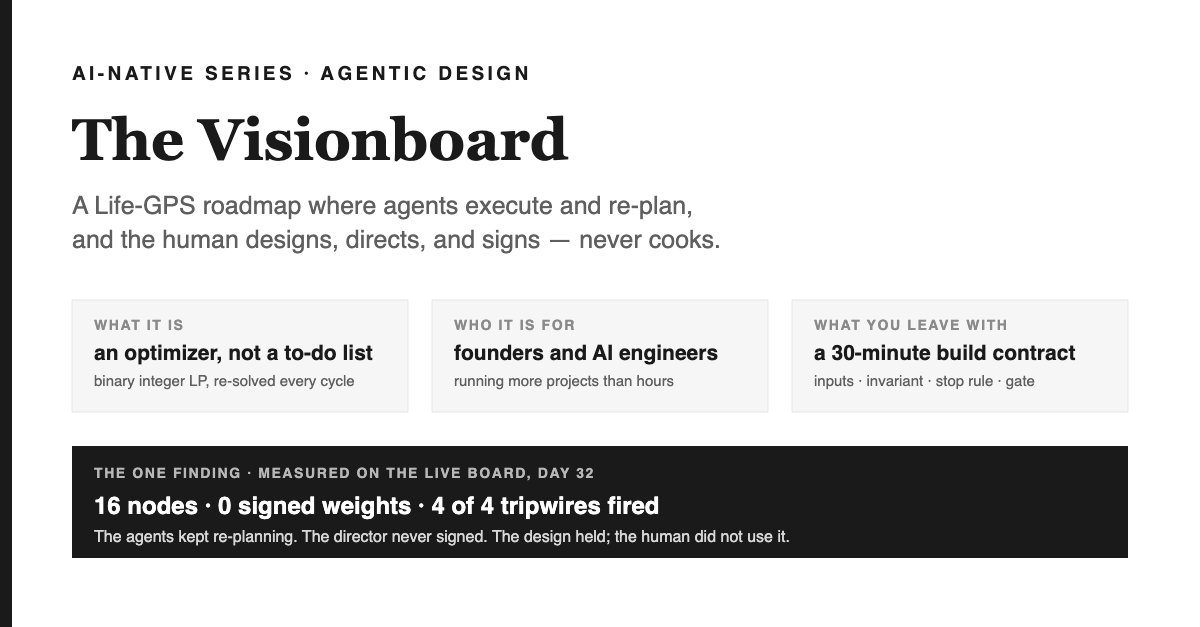
一分钟速览——读完你能带走什么
这是什么。 一篇关于 Visionboard 的设计手记:我把自己 2019 年做的 Life GPS(一个能在现实变卦时重新规划你这一周的求解器)彻底重建,让 AI 智能体来做提议、执行与汇报,由求解器挑出最优的下一步,人类则站在循环之上,只负责设计与指挥。没有任何一项是由机器签字的。
为什么重要。 对一个项目比时间还多的创始人或工程师来说,这就是「一块只会讨好你的仪表盘」和「一件如实告诉你胜算的仪器」之间的差别。对学生而言,这是「智能体的人类监督」究竟意味着什么的最干净的小样本——它是代码,不是口号。文中附上了这块实盘看板自己给出的读数,包括它撞见自己的主人整月缺席的那一次。
你可以做什么。 用下面的契约花30分钟搭出这个循环,任何领域都行;跑一遍退出测试;然后做一件整套设计都指望着的事——签下一个权重——赶在下一次周复盘之前。
The Visionboard — 系列脉络
- 《Visionboard》:把 Life GPS 重建成智能体驱动的路线图,人类站在循环之上 本集
- Life GPS,2019 → 2026:初代规划器做对了什么,又是什么杀死了它 第 2 集
- 一个人的 Life GPS:每日的导演时刻,以及智能体不得涉足之处 第 3 集
- 一个小团队的 Life GPS:角色而非个人,负载作为求解器里的约束条件 第 4 集
- Visionboard 看板:什么变了,什么没变,以及三个自带证伪条件的未来 第 5 集
《Visionboard》是什么、写给谁看、这个系列为何存在
《Visionboard》是我这个作品集网站里的一个私密页面,我在这里掌舵自己的各项事业。它撑着三条长周期赛道——收入、研究、关系——外加一张由十六个项目组成、为这三条赛道供血的关系图,以及一个求解器:每次页面加载,它都会重新算出接下来最该做的三件事。AI 智能体负责提出数字、动手干活、填报告卡。而我,只被允许做三件事:写目标、签一个数字,以及在某条预先登记的假设被打破时重写目标。
它脱胎于 Life GPS,一款我在2019年4月用 R 写的规划器,那年春天我在一篇 Medium 文章 里描述过它:你给它一堆带权重、下限和上限的任务,它就把你这一周打包成一个二进制整数规划问题;等你汇报说周二一切都乱了,它就把过去冻住,把剩下的部分重新求解一遍。2026年7月我用 Python 把它重写了一遍,并在那篇 公司级文章 里承认:我造出来的其实是一个控制循环,却把它当成了待办清单。
这篇承认引出了整个系列要回答的问题。一旦执行者不再是你本人,而是一群智能体,设计上必须改变什么,才能让人类继续掌权,既不沦为瓶颈,判断力这门手艺也不会悄悄烂掉?第1篇讲的是设计本身,以及它的第一次实测。第2到第5篇依次讲2019年的起源、单人版、小团队版,以及最终的记分牌。
这篇文章同时写给三种读者:想要具体操作手柄的 AI 工程师,想要一份运营契约的创业者,以及想要一张明天就能自己重跑一遍的图的、有天赋的高中生。这张图马上就来,它是一间厨房。
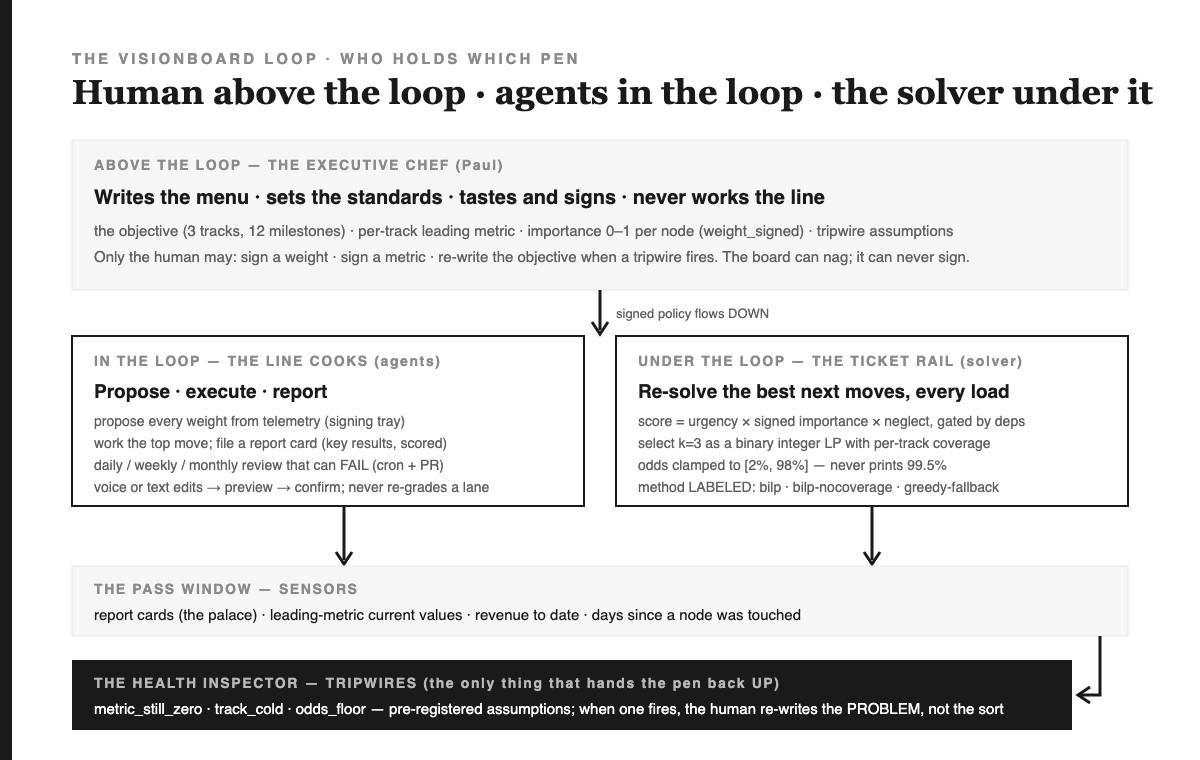
一张图撑起整个系列:从不下厨的行政总厨
想象一下厨房里那道分水岭:过了这道岭,你就不再是个厨子了。家庭厨师自己设计菜式、自己下厨。线厨(line cook)只管照单执行。而一位掌管一家餐厅、乃至一整条连锁店的主厨(executive chef),只写菜单、定标准、尝味道、签字放行。如果晚上八点主厨还在灶台边忙活,那这家餐厅其实没有主厨。
Visionboard 就是这样一间厨房——主厨被故意挡在灶台之外。下面这张对照表一一对应,每一行都能在真实代码里找到出处。
| 厨房 | Visionboard 对应项 | 谁执笔签字 |
|---|---|---|
| 菜单 | 目标:三条赛道,十二个里程碑(content/goals.json) | 人类 |
| 每道菜的标准 | 每条赛道一个领先指标,配一个每周增量目标 | 人类签字,智能体提议 |
| 尝味道、签字放行 | weight_signed: true 作用于某个节点——重要度取值 0 到 1,0.5 为中性 | 仅限人类 |
| 出票轨道 | resolveMoves(),见 lib/gps.mjs——重新求解出的前三步行动 | 求解器 |
| 线厨 | 智能体:提议权重、执行头号行动、提交报告卡 | 智能体 |
| 传菜窗口 | 报告卡(档案库)与指标读数——也就是传感器 | 智能体负责写,人类负责读 |
| 健康检查员 | checkTripwires() ——那些能把笔重新交回人类手上的预先注册假设 | 代码触发,人类重写 |
| 厨师给自己的菜打分 | 把卡片在评分通道之间移动——被拒绝,执行者是VisionboardAgent | 没有人 |
记住这幅画面。下面每一条设计规则,首先都是一条厨房规则。
研究的四种时间尺度:300年、30年、30个月、30天
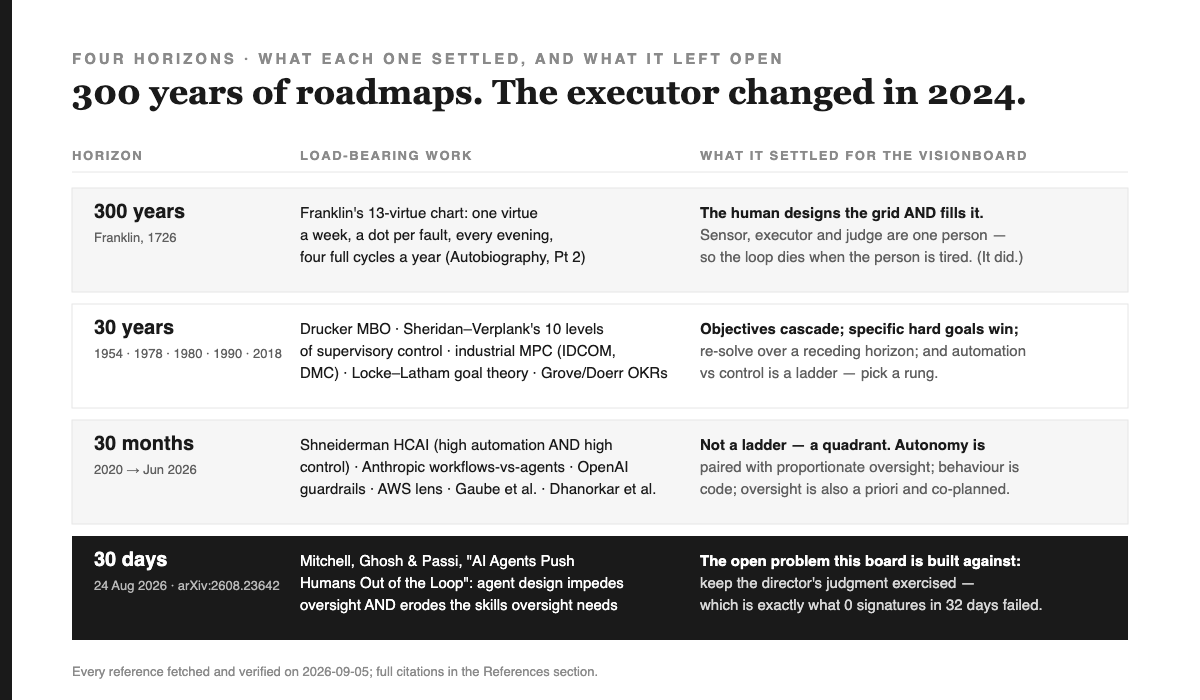
[EVIDENCE]300年。 Benjamin Franklin 的十三美德表,构思于1726年归途的航行中,记述在他《自传》的第二部分——自传——是我能找到的最古老的、四要素齐备的个人控制回路:一张设计好的表格、每晚一次的传感器读数(每犯一次错点一个点)、一个执行者,以及一个裁判。这四者是同一个人。他自己说,这个回路一年能跑满四轮,然后——用他自己的话说——就渐渐荒废了。这是第一个发现,而且已经有三个世纪之久:当传感器、执行者和裁判是同一个疲惫的人时,回路会随着这个人注意力的消散而消散。
[EVIDENCE]30年。 有四件事被确立下来。Drucker(1954)让目标层层下沉,并让执行者参与制定目标。Sheridan 与 Verplank(1978)画出了从完全手动到完全自主的十级阶梯,如今每一张“自主程度”图表都还在照搬它。工业界的模型预测控制(Richalet 等人 1978;Cutler 与 Ramaker 1980)让“每个周期都重新求解剩余时间窗”成了炼油厂稀松平常的周二日常——这正是 Life GPS 对一周所做的事。Locke 与 Latham(1990)证明,在有反馈和承诺的前提下,具体而有难度的目标在几十项任务中都胜过“尽力而为”。Grove、以及后来的 Doerr,把这一发现变成了带有固定复盘节奏的 OKR。
[EVIDENCE]30个月。 阶梯变成了象限。Shneiderman(2020)主张自动化程度与人类控制力是两条独立的轴,好的系统在两个轴上都应该得分高。Anthropic 的《构建高效智能体》(2024年12月)划出了工作流与智能体之间的界线:前者由代码决定路径,后者由模型决定路径。OpenAI 的实践指南(2025)叠加了护栏机制,在高后果动作前设置了人工审批的暂停点。AWS 的 Agentic AI Lens 逐字陈述了 Visionboard 所依据的原则:"Human review depth scales with the consequence of the action, by design rather than by reaction."(中译:人类审查的深度应随行动后果的大小而变化,这应当是设计使然,而非事后反应。) 2026年有两篇论文把「监督」从一句口号变成了一个可实操的对象:Gaube 与十九位合著者为它给出了定义和架构;Dhanorkar、Passi 与 Vorvoreanu 访谈了十七位开发者,发现监督"not only reactive and retrospective, as portrayed in existing research, but also preventative and proactive."(中译:不仅是现有研究中所描绘的被动、回顾式的,也是预防性和主动性的。) 他们归纳出的四种形式——事前控制、共同规划、实时监控、事后审查——恰好对应 Visionboard 允许人类做的四件事。
[EVIDENCE]30天。 2026年8月24日,Mitchell、Ghosh 与 Passi 发表了这块看板所依据的论文。他们的核心论点是:"Not only do current approaches to AI agent design impede effective human oversight, but the cognitive capacities required for it are also themselves degraded by extended use of AI systems."(中译:当前的 AI 智能体设计方式不仅妨碍了有效的人类监督,长期使用 AI 系统还会削弱监督所需的认知能力本身。) 这句话值得读两遍。它的意思是:「循环之上的人类」并非一个稳定的位置;如果设计本身不逼着人做出判断,这个位置就会被侵蚀。记住这一点,因为在实测案例里,这块看板在第一个月就精确地测量到了这种侵蚀——而那个人类,就是我。
设计:七条规则,每一条都钉死在强制执行它的代码上
规则一:拆解为受限的智能体,给人类留下仍能实施治理的最小接口
[DESIGN]四个角色,四种权限范围。提议智能体(proposer) 读取遥测数据,在签署托盘里为每个权重提出建议。执行智能体(executor) 执行排名第一的行动并提交报告卡。审查智能体(reviewer) 按 cron 定时运行(每日 UTC 13:47、每周一、每月第一天),并开启一个可能失败的 pull request。引导智能体(steering agent (components/VisionboardAgent.tsx)接收口头或文字形式的修改指令,返回一份 diff 和一个按钮。这四个智能体都无权签署。这一原则,正是 AWS 所强调的「明确权限范围、明确限制」,被套用到了一人公司之上。
规则二:选择是求解器的活儿,而且求解器要交代自己是怎么解出来的
[DEF]每个项目节点都会得到一个分数:赛道紧迫度(随里程碑临近而上升)乘以已签署的重要性,再乘以一个「疏忽加成」(有价值但正在冷却的节点会被提上来),并受依赖关系的约束。接下来,排名前三并不是简单排序得出的,而是一个二元整数规划问题:在最多选三项的前提下最大化总分,并且每条有临近里程碑的赛道至少分到一个行动。正是这条覆盖率约束,才使得第32天的这三个行动横跨了全部三条赛道。输出结果上会标注所用的方法——bilp, bilp-nocoverage 覆盖度不可行时 greedy-fallback 求解器抛出异常时——这样读者永远不会把退路误认成最优解。
规则三:未签名的数字只是提议,而提议没有任何权力
[DESIGN]这正是 求解器那篇文章 里的接缝契约,如今被压缩成一行代码来强制执行:只有当 weight_signed 为真时,节点的重要性才会乘入它的分数。未签名时,乘数恒为 1。人类给出的数字介于 0 到 1 之间,0.5 代表正常,系数就是这个数字除以 0.5,任何人一眼就能核对这道算术。输出会列出每一个未签名的节点。把未签名的权重喂给优化器,正是猜测悄悄洗白成权威的方式;解法必须是结构性的,而不是一句提醒。
规则四:仪表盘不许讨好
[DESIGN]胜算由所需速度与实际观测速度对比算出,并被限制在 2% 到 98% 的区间内。看板永远不可能打印出 99.5%。没有数值指标的赛道会显示 null ,并附文字「尚无法测量」,绝不会编造一个数字。一个尚在规划阶段的节点,能得到的建议永远只能是「先把它立起来」。以上每一条,都是仪表盘本来会欣然去做、而这套设计偏偏拒绝去做的事。
规则五:自主权与相称的监督按后果配对
[DESIGN]把每个动作按其后果映射。重新求解移动方案代价为零、随时可撤销,所以求解器每次加载都独自完成。提议一个权重在被签署之前不会改变任何东西,所以由智能体独自完成。编辑图结构(依赖关系、里程碑、状态)是可逆的,但有后果,所以要先预览、再确认。签署一个权重或一项指标会决定优化器接下来几周的行为,所以只能由人类完成。给报告卡重新打分永远不被允许,因为分数本该出自独立评分者之手,自己给自己打的分毫无价值。这最后一项拒绝,在引导智能体里有专属的报错信息,也是我在整个设计里最引以为傲的一行。
规则六:唯有触发的绊线,才能把笔重新交还给人类
[DESIGN]求解器只重新求解资源分配,从不重写问题本身。唯有被触发的绊线才能做到这一点,而绊线本质是数据:一条命名清楚的假设、一个机器可核验的条件,以及「把笔交还给策略负责人」这个动作。目前存在三种类型:某个先行指标在 N 天后仍为零、某条赛道带里程碑却十四天内没有任何报告卡、胜算长期卡在诚实下限上。健康检查员不下厨,检查员只管开罚单,菜单还是得由主厨重写。
规则七:行为即代码,审查可以失败
[DESIGN]目标、绊线、权重和指标都存放在受版本控制的 JSON 文件里。智能体的编辑词汇表是带类型校验、配有测试文件的联合类型。审查节奏是一个工作流:跑起来就开一个 pull request,跑不动就开一个 issue。用 Dhanorkar 等人的说法,这就是把「事前控制」与「事后审查」直接嵌入底层基础设施,于是人类的监控负担成了例外路径,而非默认路径。
实测案例:第 32 天的实时看板
[MEASURED]计划于 2026 年 8 月 4 日启动,共设三条赛道:90 天内营收做到 $1M;一项研究赌注(自我改进的智能体化系统及其在质量管理系统中的应用);以及一条关系赛道,包含每日反思「例行安排」、每周门徒辅导与每月一次讲座。十六个项目节点,每个都带有介于 0.5 到 1 之间的建议重要性。四条绊线(tripwire)已预注册。智能体提出了三个先导指标,每个都标注「需要决策」,并写明了具体待决问题:哪个报价先定价;这项研究赌注是否作为排行榜提交项;现有的学员批次(cohort)是否算作第一期。
第 32 天,求解器报告:财务胜算 2%,已触底,因为该里程碑每天需要约 $17,500 的进度,而观测到的实际速度是每天 $0。研究与关系赛道的胜算:null,无法测量,因为没有指标被签署。四条绊线全部触发:营收指标超过十四天期限仍为零;研究指标仍未被测量;关系赛道已经冷却,而里程碑还有 57 天;胜算触底。十六个节点中有十三个带着权重,一旦被签署就会左右求解器的判断。没有一个被签署。
再看传感器——这次读的是生产环境的账本,而不是我笔记本电脑上的数据:账本里共有 211 张报告卡,其中 37 张是计划启动之后新填报的,最新一张是 8 月 30 日的。这 37 张里,每一张落在的节点,其主赛道都是财务类。研究和关系这两条赛道,整整一个月里一张报告卡都没收到——这正是「冷赛道」绊线触发的条件。厨房里只有一个工位还在不停出餐。检查员写了四张罚单,可循环之上没有一个人读过它们。
更正,2026-09-07。 上文这段的最初发布版本曾说,最新一张报告卡的日期是 8 月 4 日,且该数据源从第 0 天起就已沉寂。那其实只是我笔记本电脑视角下看到的看板——我的笔记本电脑读不到私有账本;生产环境的看板可以,现在展示的数字,正是它读到的结果。核心论点——零签署、四条绊线全部触发——并未因此改变。这处错误被保留在页面上,而不是被悄悄抹去,因为本系列的规矩是:仪表不得讨好任何人,它的作者也不例外。
这能证明什么、不能证明什么,说清楚:它不能证明求解器错了——它打印出的每一个数字,都是对它所掌握数据的诚实读数。但它确实以最不讨喜的方式,证明了这套设计自身的论点:「循环之上的人类」是一个必须持续去占据的位置,而不是一劳永逸的身份。 Mitchell、Ghosh 和 Passi 在 8 月就预言了这种失败模式。看板在 9 月把它记录了下来。我造了一个签署按钮,却整整 32 天没有按下去——这大概是验证一篇论文最昂贵的方式了。
[OPEN]尚未解决的是修法。有两个候选方案,各带一个可证伪的判据,将是第 5 篇的任务:把「签署」变成页面第一件要求你做的事(一个 Level-0 级别的可见入口,而不是藏在底部的一个托盘);以及让「沉默的传感器」变得不可能存在(一个连续七天没产出报告卡的数据源,本身就应该触发一条绊线)。如果这两项上线一个月后,签署数依旧是零,那问题就不出在界面上了。
30 分钟内搭出来:这份契约
你不需要我的代码,你需要的是这个骨架。任何领域,只要有几个长周期目标、少量项目、以及某种证据数据源,就足够了。
INPUTS
  tracks[]     : {id, milestones[{days, target?}], leading_metric{name, current, signed}}
  nodes[]      : {id, tracks[], weight 0..1, weight_signed, deps[], status planned|active}
  cards[]      : {repo, created_at, key_results[{text, score}]}   # the sensor
  tripwires[]  : {id, type, track, params, assumption, action}
OUTPUTS
  moves[k]     : {id, score, why, next}     with method ∈ {bilp, bilp-nocoverage, greedy-fallback}
  status[]     : {track, odds ∈ [0.02,0.98] | null, to_raise}
  tripwires[]  : {id, fired, why}
INVARIANTS (the tests you write first)
  unsigned weight ⇒ multiplier == 1          # no signature, no coefficient
  no metric      ⇒ odds == null              # never an invented number
  every track with a milestone and a candidate gets ≥1 move, or the method says it could not
  the agent can propose, edit-with-confirm, report; it can never set weight_signed or move a grade
STOP RULE
  a fired tripwire stops the allocation loop and asks a human to re-write the objective
CI THRESHOLD
  all invariants pass; a selftest re-introduces each violation and proves the gate exits 1
DELIBERATELY MISSING
  any forecast beyond observed velocity; any autonomous signature; any re-grade
选一个能从测试里调用的求解器(PuLP 配 CBC,或者像本看板这样用的某个 JavaScript LP 包)。让打分函数保持纯粹。把人类给出的数字放进一个受版本控制的文件里,并让系数是一个人类肉眼就能核验的除法。
同一个故事,五种退出路径
| 读者 | 本集交给你的决定 | 唯一要做的事 |
|---|---|---|
| 学生 | 对稀缺预算做分配,「优化」才是正确的框架,而不是「遍历」 | 为你自己的一周重新实现这份 30 分钟契约;先让「未签署权重」的测试跑通 |
| 工程师 | 监督是一份接口契约,不是一场评审会议 | 找到你的智能体系统里那个「授予权限」的字段;把它设为仅限人类操作,并给每一个兜底方案打上标签 |
| 创始人 | 一个如实报出「2%」的仪表,比一个永远显示绿色的仪表更有价值 | 本周为每条赛道签署一个领先指标;并在旁边写下它的证伪条件 |
| 高管 | 自主权应当按行动的后果大小来授予,而不是按团队的热情高低 | 把你的智能体的所有行动按可逆性列一遍;把不可逆的那些挪到签名之后 |
| 投资人 | 创始人自己的仪表在「告发」他自己,这对仪表本身来说反而是个好迹象 | 要求看绊线触发日志,而不是路线图 |
范式、反范式,与运行机制
范式。 先签名,再赋权重。先限幅,再打印结果。给方法署名。把假设预先登记下来,交给代码去检验。先预览,后确认。让审查可以大声地失败。
反范式。 一个用未签名系数来计算胜算的仪表盘。一个滚动到折叠线以下才看得到的提案托盘。一个「人类闸门」,却把每个动作都批准成了条件反射。一个可以在三条赛道里的两条上保持沉默、却没人察觉的传感器——这正是我上线的那个版本。
运行机制。 权限只经由签名向下流动;证据只经由传感器向上流动;二者在一个可审计的求解器里相遇——因为它的输入都经过签署,它的方法也都被明确标注。
第一性原理,一句话说完。 一个由智能体驱动的路线图,能保持诚实的时限,恰好等于「机器唯一做不了的事」仍然是「授予权限」这件事本身的时限。
退出测试
当你能不往回翻页、就答出以下三题时,才可以结束本集。
- 一个未签名的权重,其乘数是多少?为什么是这个数? (恰好是1,这样一来,不签名就等于什么都不会改变)
- 说出求解器把笔交还给人类的唯一路径。 (触发一次绊线)
- 在第 32 天,看板呈现的结果里,哪一部分是设计的缺陷,哪一部分是负责人的缺陷?
现实任务
先拿我自己开刀:本系列的规矩是,每一篇文章都必须改动那块活的看板或它的数据。在下一次周复盘之前,我要签下一个先导指标——财务那一项——并附上它的失败判据:连续三周环比增速低于 12%,说明是报价错了,不是努力不够。第 5 集会汇报我到底做没做。
轮到你了:挑一件你正在“监督”的事,找出授予它权力的那个字段。如果一台机器能设定那个字段,你就不是站在循环之上——你只是个摆设。
接下来读这些
本篇是《The Visionboard》系列第 1 集。文中的论断按类别标注——定义、设计选择、证据、测量、待解问题——厨房这个比喻可以用来引出论断,但绝不能充当论断的证据本身。本系列的资料来源与实时测量数据都记录在代码仓库中的docs/plans/2026-09-06-visionboard-research-dossier.md;文章只能引用该文件里已有的内容。
参考文献
- Paul Wu,《Life GPS》 ——代码仓库 github.com/wjlgatech/life_GPS(于 2019-04-25 用 R 语言创建;Python 重写版于 2026-07-06 推送)。2019 年那篇 Medium 文章的链接可在其 README 中找到;Medium 仅面向浏览器提供访问。验证于 2026-09-06。
- Benjamin Franklin,《The Autobiography of Benjamin Franklin》,第二部分——十三条美德与每周记录表。公共领域,Project Gutenberg #20203.
- Peter F. Drucker,The Practice of Management,Harper,1954——目标管理与自我控制。
- Thomas B. Sheridan and William L. Verplank,Human and Computer Control of Undersea Teleoperators,MIT Man-Machine Systems Laboratory,1978——自动化十级量表。
- J. Richalet, A. Rault, J. L. Testud, J. Papon,"Model predictive heuristic control: Applications to industrial processes"(中译:模型预测启发式控制:在工业过程中的应用),Automatica 14(5),1978;C. R. Cutler and B. L. Ramaker,"Dynamic matrix control — a computer control algorithm"(中译:动态矩阵控制——一种计算机控制算法),Joint Automatic Control Conference,1980。
- Edwin A. Locke and Gary P. Latham,A Theory of Goal Setting and Task Performance,Prentice Hall,1990。
- Andrew S. Grove,High Output Management,1983;John Doerr,Measure What Matters,Portfolio,2018。
- Ben Shneiderman,"Human-Centered Artificial Intelligence: Reliable, Safe & Trustworthy"(中译:以人为本的人工智能:可靠、安全且可信),International Journal of Human–Computer Interaction, 2020; arXiv:2002.04087.
- Anthropic,Building Effective Agents,2024年12月。anthropic.com/engineering/building-effective-agents.
- OpenAI,A practical guide to building agents, 2025. PDF.
- AWS Well-Architected Framework,Agentic AI Lens — Design principles. docs.aws.amazon.com。逐字引用;抓取于2026-09-05。
- Susanne Gaube 等(20位作者),"Keeping an Eye on AI: A Framework for Effective Human Oversight of AI Systems," arXiv:2605.16278,提交于2026-04-09。抓取于2026-09-05。
- Shipi Dhanorkar, Samir Passi, Mihaela Vorvoreanu, "Human oversight of agentic systems in practice: Examining the oversight work, challenges, and heuristics of developers using software agents," arXiv:2606.05391,提交于2026-06-03。逐字引用;抓取于2026-09-05。
- Margaret Mitchell, Avijit Ghosh, Samir Passi, "AI Agents Push Humans Out of the Loop," arXiv:2608.23642,v1版2026-08-24,v2版2026-09-02。逐字引用;抓取于2026-09-05。
- Sayash Kapoor, Benedikt Stroebl, Zachary S. Siegel, Nitya Nadgir, Arvind Narayanan, "AI Agents That Matter," arXiv:2407.01502,2024年——智能体评测必须把成本与准确率放在一起权衡。
- 欧盟《人工智能法案》,第14条——人类监督; 实施时间表:附件三高风险义务自 2027 年 12 月 2 日起适用。抓取于 2026-09-05。
- 本仓库:
lib/gps.mjs(打分、BILP 选择、赔率限幅、tripwire),packages/core/src/goal-edits.ts(智能体的类型化编辑词汇表),components/VisionboardAgent.tsx(预览→确认;拒绝自我评分),content/goals.json(目标、第 32 天状态),.github/workflows/visionboard-review.yml(可以失败的审查)。测量于 2026-09-05,在已提交数据上运行生产环境求解器得出。