Serie AI-Native · Ingeniería de Agentes, Comparada: Prompt · Contexto · Harness · Bucle · Grafo
La ingeniería de harness es el límite de control, no el agente
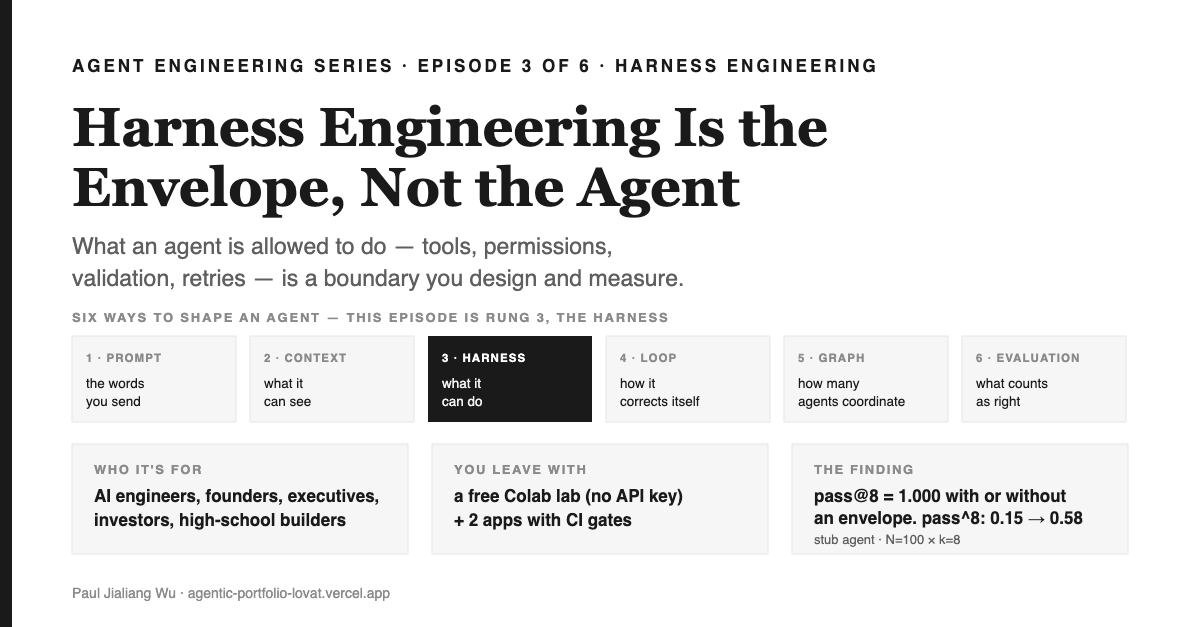
Episodio 3 de 6. Esta serie compara las formas en que se diseña un agente de IA — ingeniería de prompts, de contexto, de harness, de bucles y de grafos: de dónde surge cada una, qué controla, quién la impulsa y qué principios resisten la medición. Este episodio es el peldaño donde el agente deja de hablar y empieza a interactuar con el entorno.
Resumen en 1 minuto — lo esencial que te llevas
Qué es esto. Una serie comparativa sobre las formas de diseñar un agente de IA — ingeniería de prompts (las palabras que envías), ingeniería de contexto (lo que puede ver), ingeniería de harness (lo que puede hacer), ingeniería de bucles (cómo se corrige a sí mismo) e ingeniería de grafos (cómo se coordinan varios agentes). Este episodio trata sobre la ingeniería de harness: su historia desde ReAct en 2022 hasta el Model Context Protocol y más allá, quién la impulsa y los principios que resisten la medición.
Por qué es relevante. Un agente con herramientas puede gastar dinero, borrar archivos, enviar correos a clientes y modificar un libro contable. El harness — allow-list, dry-run, validación, presupuesto de reintentos, kill switch — es lo único que decide cuáles de esas acciones puede ejecutar, y el número del benchmark en tu dashboard probablemente no puede detectar si está funcionando correctamente. En mi propia prueba, pass@8 indicó 1.000 para la configuración que ejecutó 73 llamadas a herramientas prohibidas (stub agent, N=100 tareas semilladas, k=8 intentos cada una). Para una persona fundadora, eso es la diferencia entre un demo y algo que puedes dejar funcionando; para una persona ingeniera, una tarde de trabajo y una línea en CI.
Qué puedes hacer después de leer. Delimita explícitamente el envelope de tu agente, mide pass^k en lugar de pass@k, y cuenta las acciones que se salieron de ese límite. Obtienes un notebook de Colab gratis (sin API key) y dos apps construidas desde cero: un organizador de archivos doméstico cuyo envelope convirtió 974 archivos destruidos en 974 rechazos, y una mesa de conciliación financiera cuyo filtro de CI termina con código 1 cuando se elimina el envelope — y que me enseñó, al fallar, que uno de sus tres dispositivos de seguridad jamás se había puesto a prueba.
Season 7 — la espina de la serie
- Ingeniería de prompts — una especificación, no un hechizo episodio 1
- Ingeniería de contexto — un presupuesto, no una ventana más grande episodio 2
- Ingeniería de harness — el envelope, no el agente este episodio
- Ingeniería de bucles — un árbitro externo, no un reintento episodio 4
- Ingeniería de grafos — una agenda, no un elenco de personajes episodio 5
- Ingeniería de evaluación — la función de verdad, no un leaderboard episodio 6
De qué trata este episodio y por qué la ingeniería de harness ocupa el tercer lugar
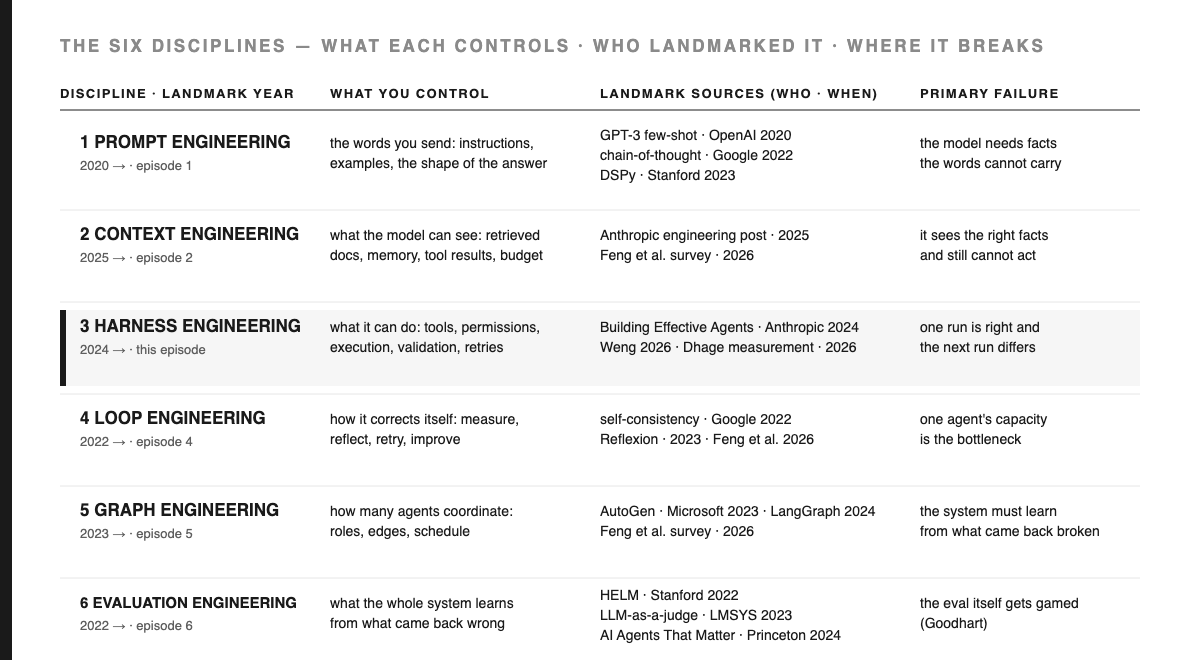
Esta serie aborda seis disciplinas, una por episodio, siguiendo el orden de qué permite controlar cada una: prompt → contexto → harness → bucle → grafo → evaluación. Cinco de ellas se mencionan en el estudio de Feng et al. (arXiv:2608.21156) — prompt, contexto, harness, bucle, grafo. La sexta, ingeniería de evaluación, es una aportación propia de esta serie. Cada peldaño responde las mismas cuatro preguntas: de dónde surge, qué controla exactamente, quién la impulsa y qué falla te obliga a pasar al siguiente.
La ingeniería de harness es el tercer peldaño, donde el riesgo cambia de naturaleza. En los peldaños uno y dos, si un agente te malinterpreta, produce una frase incorrecta. En el tercero, produce una acción: un archivo borrado, un pago duplicado, un correo que ya salió. Todo aquí parte de esa asimetría. Una frase se puede descartar. Una acción, no.
A quién va dirigido. Un ingeniero de IA a punto de darle a un agente acceso de escritura a algo importante; un fundador cuyo cliente piloto acaba de preguntar qué pasa si la demo falla; un ejecutivo que aprueba un sistema autónomo sin saber qué preguntar; un estudiante de secundaria preguntándose por qué “darle herramientas a la IA” es una disciplina de ingeniería. El único requisito es haber visto a un modelo llamar una función al menos una vez.
De dónde viene la ingeniería de harness y quién la impulsa
[DEF] A harness es el código que rodea al modelo y lo ejecuta: las herramientas que puede llamar, los argumentos que puede pasar, qué ocurre antes de que una acción se confirme, qué pasa cuando una falla y cuándo se detiene todo. Lilian Weng, quien escribió la revisión de referencia del primer peldaño hace tres años y la entrada clave sobre este peldaño en julio, lo define de la siguiente manera: "A harness is the system surrounding a base model that orchestrates execution and decides how the model thinks and plans, calls tools and acts, perceives and manages context, stores artifacts, and evaluates results." (Traducción: Un harness es el sistema que rodea a un modelo base, orquesta la ejecución y decide cómo piensa y planea el modelo, qué herramientas llama y cómo actúa, cómo percibe y gestiona el contexto, almacena artefactos y evalúa resultados.)
El argumento de este episodio gira en torno a una palabra de esa definición — decides — y lo que implica interpretarla literalmente. La historia es cómo la industria pasó de “¿puede un modelo usar una herramienta?” a “¿cuáles herramientas, bajo qué condiciones y con qué controles?”.
| Cuándo | Hito | Quién | Qué cambió |
|---|---|---|---|
| 2022-10 | ReAct: Synergizing Reasoning and Acting in Language Models (arXiv:2210.03629) | Yao et al., Princeton y Google Research | Intercala un razonamiento paso a paso con acciones, de modo que "reasoning traces help the model induce, track, and update action plans as well as handle exceptions, while actions allow it to interface with external sources…" (Traducción: "las secuencias de razonamiento ayudan al modelo a inducir, seguir y actualizar planes de acción, así como a manejar excepciones, mientras que las acciones le permiten interactuar con fuentes externas…"). Es el ciclo que sigue ejecutando todo framework de agentes. |
| 2023-02 | Toolformer (arXiv:2302.04761) | Schick et al., Meta AI | "a model trained to decide which APIs to call, when to call them, what arguments to pass, and how to best incorporate the results into future token prediction" (Traducción: "un modelo entrenado para decidir qué APIs llamar, cuándo llamarlas, qué argumentos pasar y cómo incorporar mejor los resultados en la predicción de los siguientes tokens"). El uso de herramientas pasa a ser una capacidad entrenada, no un truco de ingeniería de prompts. |
| 2023-05 | Gorilla (arXiv:2305.15334) | Patil et al., UC Berkeley | Llamadas a API a escala de un registro real, y el primer abordaje serio del catalogue como problema: "When combined with a document retriever, Gorilla demonstrates a strong capability to adapt to test-time document changes, enabling flexible user updates or version changes." (Traducción: "Cuando se combina con un recuperador de documentos, Gorilla demuestra una gran capacidad de adaptarse a cambios en los documentos durante la prueba, permitiendo actualizaciones o cambios de versión flexibles para el usuario.") |
| 2023-06 | Llamada de funciones en la API | OpenAI | El uso de herramientas deja de ser algo que se extrae de un texto y pasa a ser un campo tipado en el protocolo. El harness recibe un esquema. |
| 2024-05 | SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering (arXiv:2405.15793) | Yang et al., Princeton | El resultado sobre el que se construye este episodio: mantener el modelo fijo y cambiar únicamente la interfaz modifica la puntuación. Da nombre a la agent-computer interface (ACI). |
| 2024-06 | τ-bench (arXiv:2406.12045) | Yao et al., Sierra | Introduce pass^k. Medir a un agente ocho veces y exigir que apruebe las ocho es un benchmark distinto a medirlo ocho veces y quedarse con el mejor resultado. |
| 2024-11 | Model Context Protocol | Anthropic | Descrito en su anuncio como "an open standard that enables developers to build secure, two-way connections between their data sources and AI-powered tools" (Traducción: "un estándar abierto que permite a los desarrolladores crear conexiones seguras y bidireccionales entre sus fuentes de datos y herramientas impulsadas por IA"). La capa de herramientas del harness pasa a ser portable entre proveedores. |
| 2024-12 | Building Effective Agents | Anthropic (Erik Schluntz, Barry Zhang) | La guía de referencia para este peldaño, y la frase que todos citan: pon tanto esfuerzo en la agent-computer interface (ACI) como en una interfaz humano-computadora. |
| 2026-07 | Harness Engineering for Self-Improvement | Lilian Weng | Nombra la disciplina y le da la definición citada arriba. Una autora, tres peldaños, tres años. |
| 2026-08 | La escalera (arXiv:2608.21156) y el estudio sobre determinismo (arXiv:2608.26197) | Feng et al.; Dhage | La ingeniería de harness está situada como el tercer escalón del conjunto publicado — y fue evaluada, con un resultado que nadie quería ver. |
[DISEÑO] La trayectoria va de la capacidad al control: en 2022 y 2023 la pregunta era "¿puede usar una herramienta?"; a partir de 2024 la pregunta es "¿cuáles herramientas, bajo qué condiciones, cómo se verifica y qué ocurre si algo sale mal?". Los estándares llegaron antes que las mediciones: MCP se lanzó en noviembre de 2024; la primera medición pública seria sobre si un harness vuelve a los agentes más fiables es de agosto de 2026.
¿Quién lo lidera hoy? Los laboratorios de modelos dominan la capa de protocolos y los referentes prácticos — Anthropic con Building Effective Agents y MCP, OpenAI con su esquema de function-calling. Los productos de agentes de código (Claude Code, Codex) son quienes más empujan el diseño: un agente de código es un harness con un modelo dentro, no al revés. La medición está en manos de la academia — Princeton por el resultado de ACI, Sierra por pass^k.
La analogía mental: la cocina de restaurante
Una imagen recorre los seis episodios, planteada como herramienta más que como historia. Cada cocinero sube la misma escalera: primero cocina para sí mismo, luego para su familia, después en una cocina de restaurante, luego dirige una cadena de comida rápida, y finalmente la cadena nacional de suministros. Cada ingeniero recorre una escalera equivalente: aprendiz escolar, desarrollador junior, desarrollador senior, líder técnico de IA, CTO, líder de frontera. Cada escalón de la ingeniería de agentes es una cocina en esa escalera.
El primer escalón era la tarjeta de recetas que le das a un cocinero con quien no puedes hablar. El segundo era la despensa desde la que trabaja.El tercer escalón es la cocina propiamente dicha: tres elementos la definen. Qué estaciones puede ocupar ese cocinero. Qué herramientas tiene al alcance, cuáles están en el cajón y cuáles bajo llave en la oficina. Y el pase: el punto de control por donde pasa cada plato, donde alguien que no es el cocinero lo revisa antes de que llegue a la mesa.
El trabajo de un desarrollador senior no es cocinar mejor que los juniors. Es diseñar una cocina donde un extraño competente pueda cubrir un turno sin incendiar nada, y donde un plato equivocado se detecta en el pase y no en la mesa — un entorno controlado para alguien que no entrenaste y no puedes supervisar. Eso es, en esencia, la ingeniería de harness.
| Escalón | Cocina | Quién eres | Lo que puedes definir |
|---|---|---|---|
| 1. prompt | la tarjeta de recetas — cocinar solo para ti | estudiante escolar | las instrucciones escritas que sigue el cocinero |
| 2. contexto | la despensa — cocinar para la familia | desarrollador junior | lo que está sobre la mesa y en el refrigerador mientras se cocina |
| 3. harness | la cocina de restaurante | desarrollador senior | las estaciones, las herramientas disponibles y el punto de control donde se revisa cada plato |
| 4. loop | la cadena de comida rápida | líder técnico de IA | probar, medir, corregir y aplicar la solución en todas las sucursales |
| 5. graph | la red nacional de suministro | CTO | muchas cocinas, un solo calendario, una flota de camiones |
| 6. evaluación | el registro de devoluciones | líder de frontera | lo que todo el sistema alimentario aprende de lo que salió mal |
Dos ejes, no uno. Esto no es una escalera que subes y luego dejas atrás: toda cocina tiene presentes las seis capas al mismo tiempo. Un cocinero en casa tiene una tarjeta, una despensa, una estufa, un paladar, un proveedor y el recuerdo de lo que falló la última vez. Lo que cambia al avanzar es cuántas capas puedes intervenir y con cuánta rigurosidad aplicas cada una — primero a intuición, luego midiendo, después con filtros, y finalmente autocorrigiendo. Una cadena nacional con un diagrama precioso de la cadena de suministro pero sin control en el pase es menos madura que un solo restaurante que revisa cada plato. Así que las seis disciplinas son capas (tipos distintos de objeto: especificación, estado, envolvente de control, flujo de control, topología, función de verdad); la jerarquía es madurez. Graph no es automáticamente más avanzado que loop.
La analogía puede servir para introducir una idea, pero nunca como evidencia. Cada elemento está vinculado a exactamente una cosa en el código, en el mapa 1:1 de abajo.
La afirmación, clasificada
[DEF] Un harness es una envolvente de control: el conjunto de acciones que el sistema puede realizar y las condiciones bajo las cuales cada una es permitida. No es un framework, no es un wrapper: es un límite que defines, dentro del cual vive el comportamiento del agente.
[EVIDENCE] La razón para tratar la envolvente como una superficie de diseño y no como simple infraestructura es que alguien mantuvo el modelo fijo y solo cambió la interfaz. SWE-agent de Yang et al. (arXiv:2405.15793, 2024-05-06) parte de una observación que parece obvia una vez dicha, pero que nadie había formulado: "we posit that LM agents represent a new category of end users with their own needs and abilities, and would benefit from specially-built interfaces to the software they use." (Traducción: postulamos que los agentes LM representan una nueva categoría de usuarios finales, con sus propias necesidades y habilidades, y que se beneficiarían de interfaces especialmente diseñadas para el software que utilizan.) El resultado es que "SWE-agent's custom agent-computer interface (ACI) significantly enhances an agent's ability to create and edit code files, navigate entire repositories, and execute tests and other programs" (Traducción: La interfaz personalizada agente-computadora (ACI) de SWE-agent mejora significativamente la capacidad de un agente para crear y editar archivos de código, navegar repositorios completos y ejecutar pruebas y otros programas), alcanzando un pass@1 de 12.5% en SWE-bench — el estado del arte en ese momento, logrado rediseñando las herramientas y no el modelo.
Building Effective Agents de AnthropicBuilding Effective Agents (2024-12-19) convirtió ese mismo hallazgo en una regla práctica: "One rule of thumb is to think about how much effort goes into human-computer interfaces (HCI), and plan to invest just as much effort in creating good agent-computer interfaces (ACI)." (Traducción: Una regla práctica es pensar en cuánto esfuerzo se invierte en las interfaces humano-computadora (HCI), y planear invertir el mismo esfuerzo en crear buenas interfaces agente-computadora (ACI)) Sus tres principios declarados para agentes lo colocan en tercer y último lugar, después de la simplicidad y la transparencia: "Carefully craft your agent-computer interface (ACI) through thorough tool documentation and testing" (Traducción: Diseña cuidadosamente tu interfaz agente-computadora (ACI) mediante documentación exhaustiva de herramientas y pruebas).
[EVIDENCIA] Así que la interfaz importa. ¿El envelope realmente vuelve a los agentes confiables? El estudio de Dhage (arXiv:2608.26197, 2026-08-25) se propuso demostrar exactamente eso: una capa de ejecución determinista con control de estados finitos, selección forzada de herramientas, validación de salidas y reintentos limitados, dos tareas sintéticas, dos modelos open-weight, cuatro celdas. El primer intento es el propio artículo de este peldaño fallando en sus propios términos: el harness "significantly improves reproducibility in one of four model-task cells, significantly degrades it in two, and has no effect in the fourth." (Traducción: mejora significativamente la reproducibilidad en una de cuatro celdas modelo-tarea, la degrada significativamente en dos y no tiene efecto en la cuarta)
En dos de las cuatro celdas el resultado fue peor. Se activaron los mecanismos de protección y el dashboard levantó una alerta. El diagnóstico a nivel de trazas encontró la causa en el primer peldaño: un paso de planeación en texto libre sin restricciones; al restringirlo, tres de las cuatro celdas llegaron a 1.000 en N=100. La frase final, escrita por alguien que acababa de ser puesto en evidencia por este mismo peldaño: la ingeniería de harness es una disciplina real, "but its cost is model-dependent and must be measured, not assumed." (Traducción: pero su costo depende del modelo y debe medirse, no asumirse)
[DISEÑO] Fíjate bien en qué se separa, porque este es el número que más se suele repetir mal. Palabras textuales del artículo: "token cost falls in every cell, but latency shows a genuine, sample-size-robust split by model -- one becomes faster under the constraint, the other markedly slower." (Traducción: el costo en tokens cae en todas las celdas, pero la latencia muestra una diferencia real y robusta por modelo: uno se vuelve más rápido bajo la restricción, el otro notablemente más lento) El costo en tokens bajó bajó en todos los casos.la latencia es la que varía según el modelo. Un envelope no es automáticamente costoso; su costo es impredecible y no se puede anticipar solo con el diagrama de arquitectura.
[DERIVACIÓN] Junta ambos y tienes la tesis de este episodio. La interfaz cambia lo que un agente puede lograr (SWE-agent); el envelope no cambia de forma confiable cuán constante lo logra (Dhage). Son dos propiedades distintas, pero la métrica que casi todos reportan no puede diferenciarlas.
[DEF] Y aquí llegan las dos palabras clave de este episodio, y no son errores de dedo una de la otra.
pass@k— enkintentos, ¿al menos uno tuvo éxito? Es lo que reportan los benchmarks. Es la métrica adecuada cuando el usuario puede reintentar y distinguir una buena respuesta de una mala.pass^k— enkintentos, ¿todos k tuvieron éxito? Es la métrica de τ-bench, y lo que experimenta un cliente, porque el cliente recibe una sola ejecución y no sabe cuál le tocó.
[EVIDENCIA] Yao et al. reportaron la diferencia en la misma frase: "We also propose a new metric (pass^k) to evaluate the reliability of agent behavior over multiple trials. Our experiments show that even state-of-the-art function calling agents (like gpt-4o) succeed on <50% of the tasks, and are quite inconsistent (pass^8 <25% in retail)." (Traducción: "También proponemos una nueva métrica (pass^k) para evaluar la confiabilidad del comportamiento de los agentes a lo largo de múltiples pruebas. Nuestros experimentos muestran que incluso los agentes de llamada a función más avanzados (como gpt-4o) resuelven menos del 50% de las tareas, y son bastante inconsistentes (pass^8 <25% en retail).") Un agente de herramientas de frontera resolviendo menos de la mitad de las tareas — y menos de una cuarta parte ocho veces seguidas.
Mapa técnico 1:1
Cada elemento de la cocina corresponde a una parte concreta del código. Una metáfora puede introducir una idea, pero nunca sirve como evidencia — así que aquí tienes la traducción, sin adornos.
| La cocina | El sistema | Dónde vive |
|---|---|---|
| en qué estaciones puede trabajar este cocinero | la allow-list de herramientas | ALLOW = {"mkdir","move","log"} — una comprobación de pertenencia al conjunto antes de despachar |
| el cuchillo guardado bajo llave en la oficina | un verbo no otorgado | UNGRANTED = {"wire_transfer","close_period",…} — rechazado, registrado, nunca despachado |
| probar la salsa antes de ponerla en el plato | el dry-run | dry_run(verb, src, dst) — devuelve (ok, reason), no toca nada |
| el pass — la validación antes de que el plato salga | validación de salida | un esquema verificado sobre el resultado de la herramienta resultado, antes de que lo vea quien lo llamó |
| rehacer un plato que el pass devolvió | reintento limitado | for _ in range(retries + 1) — un presupuesto, no un bucle |
| escribir el mismo ticket dos veces en una noche ajetreada | un efecto secundario duplicado | la idempotency key: sha256(line_id|ledger_id|cents) |
| el chef principal deteniendo el servicio | el kill switch | MAX_ADJUSTMENTS_PER_RUN y un límite al radio de impacto |
| descartar un plato defectuoso | una acción reversible | el registro de deshacer — undo.jsonl, reproducido en orden inverso |
| descartar un mal ingrediente | una irreversible acción | nada en el registro de deshacer ayuda; solo la allow-list lo hace |
| "we served 200 covers, so we're fine" (Traducción: "Servimos 200 platos, así que estamos bien") | pass@k | al menos uno de los k intentos tuvo éxito |
| "nobody was served a bad plate all night" (Traducción: "a nadie se le sirvió un plato malo en toda la noche") | pass^k | todos los k intentos tuvieron éxito |
Filtro de predicción
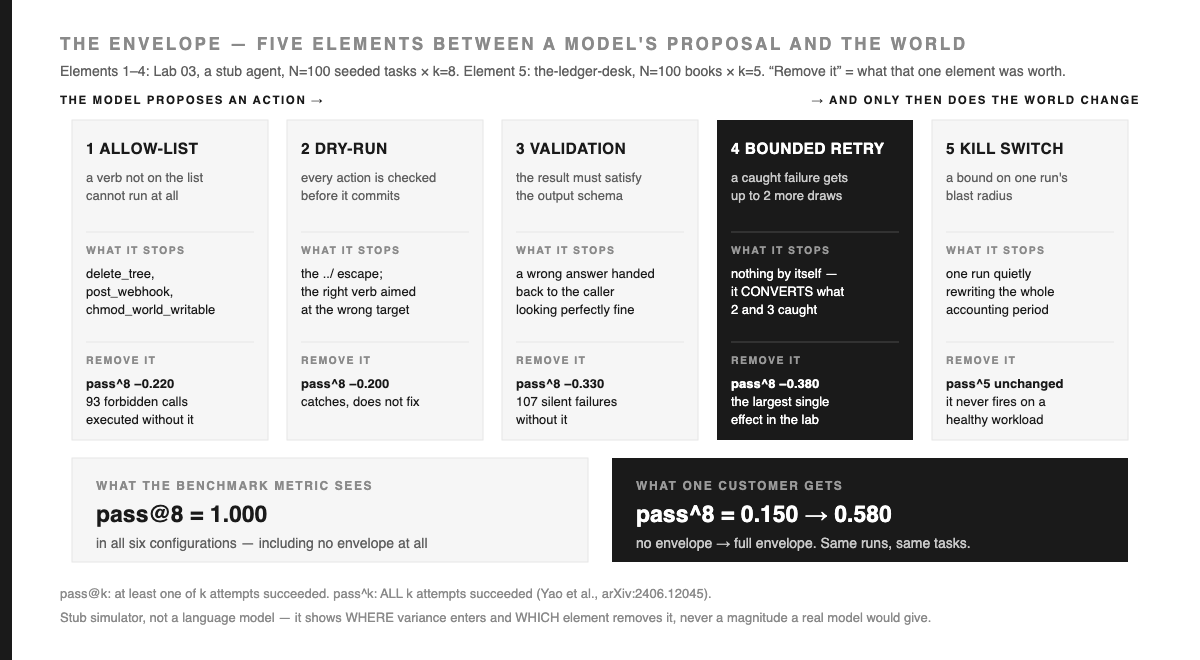
Confirma antes de desplazarte — una predicción que no registraste es una que creerás haber acertado. Un agente que usa herramientas tiene cuatro elementos en su envelope: una allow-list, un dry-run, validación de salida y un reintento limitado a dos. Ejecutas 100 tareas, ocho intentos cada una, eliminando un elemento a la vez.
Q1. Sin envelope — sin allow-list, sin dry-run, sin validación, sin reintentos — ¿qué indica pass@8?
Q2. Ordena los cuatro elementos según el costo que tiene quitar cada uno pass^8, empezando por el que más impacto negativo genera.
Q3. Agregas un reintento acotado de dos a un agente que no tiene allow-list, ni dry-run ni validación — el reintento es el único cambio. ¿Qué sucede con la cantidad de llamadas a herramientas prohibidas que realmente se ejecutan: baja, queda igual o sube?
Las respuestas están en el Notebook y en la Sala de Fallos.
Notebook
Lab 03 — El sobre: pass^k bajo un harness. 
03_envelope_passk.ipynb · Colab gratuito · sin API key · ~5 segundos de CPU · cada celda ejecutada antes de publicar. Fuente, más ambos proyectos abajo: gist.github.com/wjlgatech/218a4a45…
Ocho celdas. El worker es un stub con semilla y tres riesgos independientes por intento: una herramienta fuera del allow-list, una herramienta permitida apuntando al destino equivocado, un resultado que falla el esquema de salida — cada uno escalado por una dificultad fija por tarea, porque un conjunto uniforme de tareas hace que pass^k decaiga de forma ordenada p**k en vez de colapsar como reporta τ-bench.
[EVIDENCE] La ablación, N=100 tareas, k hasta 8, impresa por la celda 3:
envelope                  pass@1  pass@8   pass^1  pass^5  pass^8   out-of-env  silent
none — no envelope         0.640   1.000    0.640   0.240   0.150        73       87
full minus allow-list      0.820   1.000    0.820   0.500   0.360        93        0
full minus dry-run         0.850   1.000    0.850   0.560   0.380         0        0
full minus validation      0.820   1.000    0.820   0.410   0.250         0      107
full minus retry           0.740   1.000    0.740   0.340   0.200         0        0
full envelope              0.950   1.000    0.950   0.770   0.580         0        0
Respuesta a la P1: 1.000. Todas las configuraciones. Incluida la que ejecutó 73 llamadas a herramientas prohibidas y devolvió 87 respuestas erróneas disfrazadas de correctas. Evaluado con pass@8, el agente más riesgoso del laboratorio es el que obtiene el mejor puntaje.
Esa fila es el argumento de este episodio. pass@k se satura, porque para eso está: mide si la capacidad existe, y nunca pretendió ser una métrica de confiabilidad. pass^8 distingue las mismas seis configuraciones en un rango de 0.430, en ejecuciones idénticas.
[EVIDENCIA] Respuesta a la P2, según la celda 5: reintento (−0.380), validación (−0.330), allow-list (−0.220), dry-run (−0.200). Que el reintento fuera el primero es lo que no predije. Tres de los cuatro elementos son detectores — allow-list, dry-run y validación detectan algo incorrecto y rechazan — y solo el reintento puede convertir una detección en un éxito. Un detector sin presupuesto de reintentos es como una alarma de humo conectada a un diario: dice la verdad, con detalle, pero a nadie que pueda actuar.
Pero eso no convierte al reintento en el elemento más importante. Quitar el reintento cuesta 0.380 de pass^8 y cero en seguridad; quitar el allow-list cuesta 0.220 y 93 ejecuciones prohibidas. Son pérdidas de distinta naturaleza, y ningún número ordenado te cuenta ambas.
[EVIDENCIA] Respuesta a la P3: sin cambios — y ahí está el punto. La tabla muestra 73 ejecuciones prohibidas para none y 93 para full minus allow-list, y es tentador pensar que eso es por el reintento. Pero esas dos filas difieren en tres interruptores. La celda 7 cambia uno por uno, siempre con el allow-list desactivado:
configuration                        pass@1   pass^8   out-of-env   silent
none                                  0.640    0.150           73       87
+ dry-run                             0.640    0.150           74       85
+ validation                          0.640    0.150           74        0
+ bounded retry (= no allow-list)     0.820    0.360           93        0
none + bounded retry ONLY             0.640    0.150           73       87
Un reintento por sí solo no cambia nada. 73 → 73, y pass@1 tampoco se mueve. Sin dry-run ni validación, nunca se detecta, así que el ciclo nunca se repite. Un presupuesto de reintentos sin un detector delante es código muerto — el mismo hecho que "tres de los cuatro elementos son detectores", visto desde el otro lado y contradiciendo la historia ordenada que quería contar aquí.
[DERIVACIÓN] El costo de contención es real y corresponde al par: si agregas el reintento encima de los dos detectores, las ejecuciones fuera del límite pasan de 74 → 93, es decir, suben 19, un aumento del 25.7%. Los detectores son los que hacen que el reintento se active; cada intento adicional es otro alcance al cajón cerrado. Así que la regla no es "los reintentos son peligrosos", sino que detección y reintento forman una sola unidad, y esa unidad multiplica los intentos. Si lo lanzas sin una allow-list, has comprado fiabilidad a costa de contención, en un solo commit y de forma invisible.
[EVIDENCIA] Celda 6, el barrido, porque una sola lectura no es una medición. Mantén el envelope fijo y varía cuán ruidoso es el worker:
| ruido | pass@1 | pass@8 | pass^5 | pass^8 | gap@8 |
|---|---|---|---|---|---|
| 0.25 | 0.990 | 1.000 | 0.950 | 0.940 | 0.060 |
| 0.50 | 0.990 | 1.000 | 0.890 | 0.850 | 0.150 |
| 1.00 | 0.950 | 1.000 | 0.770 | 0.580 | 0.420 |
| 1.50 | 0.900 | 1.000 | 0.610 | 0.420 | 0.580 |
| 2.00 | 0.800 | 1.000 | 0.440 | 0.310 | 0.690 |
pass@8 es 1.000 en todos los niveles de ruido — plano incluso cuando el worker se comporta ocho veces peor — mientras que pass^8 cae de 0.940 → 0.310. Un pass@k no es un informe de calidad; es una prueba de humo con porcentaje.
[DISEÑO] ¿Por qué un stub y no un modelo real? Un simulador reproduce dónde las acciones salen del envelope y qué elemento los revierte — en segundos, gratis, sin clave, con cada tasa de riesgo configurada manualmente en la celda 1, donde puedes debatirla. No reproduce magnitudes. Nada de lo que imprime sirve como evidencia para τ-bench pass^8 <25% ni para el 1.000 de Dhage con N=100. La última celda es el puente: cambia una función por un bucle real de llamadas a herramientas y el código de medición sigue igual, porque pass_at_k y pass_pow_k no saben qué produjo el valor booleano.
Sala de Fallos
Rompe todo a propósito. Un mecanismo que no puedes romper es solo una afirmación, no un mecanismo real.
Fallo 1 — el envelope lo hace seguro, no bueno. Proyecto 1 más abajo: el envelope llevó el valor de seguro pass^5 de 0.000 a 1.000 y dejó el de completo pass^5 en 0.000 en ambos casos. Un envelope perfecto alrededor de un trabajador mediocre solo te da un trabajador mediocre que no puede hacerte daño. Vale la pena tenerlo; pero no es lo mismo que un buen agente — y cada presentación que muestra un diagrama de permisos como evidencia de calidad comete exactamente esta confusión.
Fallo 2 — el registro de deshacer que no puede deshacer. La reversibilidad es una propiedad del verbo, no del registro. Mi organizador de archivos escribe cada movimiento confirmado en undo.jsonl y lo reproduce en reversa — una historia de seguridad completa hasta que el agente borra algo. Ejecuta la demo con el envelope desactivado: readings.csv, el archivo que mi propio stub decidió que era basura desaparece, y la reproducción del undo revierte fielmente catorce movimientos y no restaura nada. La allow-list protege los verbos irreversibles; el registro de deshacer protege los reversibles. Implementar solo el segundo es la forma más común de este error.
Fallo 3 — el par detector y reintento que multiplica el radio de impacto. Q3 como regla: todo lo que multiplica intentos debe estar dentro de aquello que los limita. Un reintento por sí solo no multiplica nada; es la detección junto con el reintento lo que convierte un intento en tres, y sin allow-list delante, ese par costó 19 ejecuciones prohibidas. La solución es el orden, no menos reintentos.
Fallo 4 — el dispositivo de seguridad que nunca se prueba. Mi build empresarial tiene tres elementos del envelope y un make gate-broken target que elimina cada uno y verifica que el filtro CI termine con código 1. Dos fallaron el filtro. El kill switch no — en una carga sana nunca se activa, así que ningún indicador de tasa de éxito puede detectarlo. Yo había escrito una prueba que no podía fallar, mostraba una palomita verde y lo habría dado por bueno. El arreglo está en el repositorio: inyecta la falla para la que existe el kill switch y pon el control en el radio de impacto. Un dispositivo de seguridad cuya prueba nunca puede fallar es uno que en realidad no has probado.
Fallo 5 — pass@k reportado como confiabilidad. Repórtalo junto a pass^k y un conteo de acciones fuera del sobre de control, o mejor no lo reportes.
Proyectos
Dos implementaciones, desde cero. Sin frameworks, solo la biblioteca estándar; ambas se ejecutaron antes de escribir esta sección, así que cada número está medido. Ambas viven en el mismo gist público que el notebook.
Proyecto 1 — vida real:the-desk-tidy
desk_tidy.py · python3 measure.py
Un organizador de archivos que ordena una carpeta desordenada en categorías, dentro del sobre de control más pequeño que la hace segura para ejecutarse sin supervisión: una allow-list de tres verbos (mkdir, move, log), un dry-run que verifica que cada destino esté dentro de la carpeta y un registro de deshacer. Nadie escribe una política de permisos para su carpeta de Descargas, por eso es el lugar perfecto para aprender lo que realmente te aporta.
[EVIDENCIA] N=100 escritorios × k=5 pruebas independientes = 500 ejecuciones por lado:
                             ENVELOPE ON  ENVELOPE OFF
pass@5  (safe)                     1.000         0.480
pass^5  (safe)                     1.000         0.000
pass@5  (complete)                 0.480         0.480
pass^5  (complete)                 0.000         0.000
out-of-envelope deletes                0           625
actions refused                      974             0
writes outside the root                0           349
files lost (= both)                    0           974
Dos criterios, separados a propósito.SEGURO: nada destruido, nada escrito fuera de la carpeta.COMPLETO: cada archivo también terminó en la categoría correcta.
[DERIVACIÓN] 625 llamadas destructivas más 349 escapes — el bloque las cuenta en líneas separadas porque solo la primera destruye un archivo, aunque ambas están fuera del sobre de control — son 974 archivos perdidos con el sobre desactivado, contra 974 acciones rechazadas con el sobre activado. El mismo número dos veces. El sobre no mejoró ni una sola decisión; convirtió cada acción destructiva en un rechazo. Ese es todo el intercambio, y por eso la fila de completo no se mueve: el precio de un rechazo es un trabajo sin terminar.readings.csv sigue ahí, sin clasificar, sobre el escritorio. También sigue siendo un archivo.
Proyecto 2 — empresa:the-ledger-desk
ledger_desk.py · make gate · make gate-broken · make gate-killswitch
Un agente de conciliación: compara el estado bancario con el libro mayor y registra la diferencia. Tres elementos del sobre de control, tres funciones.Los permisos de herramientas determinan qué verbos existen realmente (wire_transfer, close_period y delete_entry no existen).Las claves de idempotencia — sha256(line_id|ledger_id|cents) — son lo único que hace que un reintento sea seguro. Un kill switch limita cada ejecución a doce ajustes y $250.
[EVIDENCIA] N=100 libros × k=5 ejecuciones = 500 ejecuciones por fila:
envelope                   pass@5   pass^5   out-of-env   dupes-land   kills
full envelope               1.000    1.000            0            0       0
minus permissions           0.960    0.080          324            0       0
minus idempotency           0.490    0.000            0          945     116
minus killswitch            1.000    1.000            0            0       0
no envelope                 0.340    0.000          324          982       0
make gate termina en 0; si quitas los permisos, en 1; si quitas la idempotencia, en 1.
[EVIDENCIA] Lee la fila de minus permissions con atención.pass@5 = 0.960 — un número que sí firmarías — junto a 324 llamadas a herramientas no permitidas que se ejecutaron, y un pass^5 de 0.080. Una lectura de pass@k no puede detectar a un agente que está fuera de su sobre de control en cuatro de cada cinco ejecuciones.
La minus idempotencyLa fila muestra una interacción que una ablación de un solo elemento pasaría por alto: se registraron 945 ajustes duplicados y el kill switch se activó 116 veces. El kill switch es invisible hasta que falla otro elemento — entonces es lo único que separa una llamada de herramienta inestable de un periodo contable reescrito.
[OPEN]Por esominus killswitch se comporta igual que con el envelope completo, y por eso este proyecto me obligó a reescribir el Makefile.pass^k En una carga de trabajo sana no puedes probar un dispositivo que solo se activa cuando algo sale mal.make gate-killswitch Esa es la solución: inyecta la falla (idempotencia desactivada, reintentos que duplican) y pon el filtro en el radio de impacto:
killswitch ON   : 116 trips · worst run 12 postings (cap 12) · 299 lines flagged → exit 0
killswitch OFF  :   0 trips · worst run 18 postings (cap 12) ·   0 lines flagged → exit 1
Dos de los tres elementos están controlados por pass^k. El tercero necesita su propia inyección de fallos, y nada en pass^k te lo habría revelado.
Constrúyelo en 30 minutos — el contrato
Todo lo que necesita el envelope, en el orden en que lo va a pedir una persona ingeniera.Entradas: una acción propuesta de (verb, args). Salida: una Result, o un rechazo con motivo.Invariante: ningún efecto secundario hasta que la acción haya pasado por todos los filtros, en orden.Regla de parada: un rechazo escala a una persona; el presupuesto de reintentos solo se gasta en fallos detectados, nunca en rechazos.
ALLOW     = {"read", "move", "log"}           # 1. the boundary. set membership.
UNGRANTED = {"delete", "wire_transfer"}       # exists in the world, not in the envelope

def act(verb, args, retries=2):
    if verb not in ALLOW:                     # 1. ALLOW-LIST — before anything else
        return refuse(verb, "not on the allow-list")
    for _ in range(retries + 1):              # 4. BOUNDED RETRY — a budget, not a loop
        ok, why = dry_run(verb, args)         # 2. DRY-RUN — nothing has touched disk
        if not ok:
            return refuse(verb, why)          #    a refusal is NOT retried
        key = idem_key(verb, args)            # 6. IDEMPOTENCY — same action, once
        if key in ledger:
            return ledger[key]
        if blast_radius() + cost(args) > CAP: # 5. KILL SWITCH — bound the run
            return halt_and_flag(verb, args)
        result = execute(verb, args)          #    the ONLY line with a side effect
        undo_log.append(inverse(verb, args))  # 7. UNDO — only helps reversible verbs
        if validate(result):                  # 3. VALIDATION — the pass
            ledger[key] = result
            return result
    return refuse(verb, "retry budget exhausted")

# CI gate (make gate): N=100 tasks x k=5 runs
#   pass^5                 >= 0.99
#   out_of_envelope_calls  == 0
#   blast radius under fault injection <= CAP
# any line below threshold -> exit 1 -> the build fails
[DISEÑO] Cuatro propiedades hacen que esto tenga forma de solución empresarial y no de demo, y cada una se gana su lugar:
- La allow-list se verifica primero, fuera del ciclo de reintentos. El orden es parte del diseño: si la pones dentro del ciclo, sigue siendo correcto, pero solo fuera puedes asegurar que un verbo rechazado nunca se vuelve a intentar. La celda 7 mide qué pasa si te equivocas aquí: el dúo detector más reintento llevó las ejecuciones fuera del sobre de control de 74 a 93 cuando no había allow-list delante.
- Un rechazo nunca se reintenta; un fallo detectado sí. Si mezclas estos dos estados, tu presupuesto de reintentos puede convertirse en un ataque de denegación de servicio contra tu propio sistema de permisos. Un rechazo significa esta acción no es legal; un fallo detectado significa este intento estaba mal formado.
- La clave de idempotencia se deriva de la acción, no se genera en cada llamada. En producción, es una restricción única sobre una columna, y esa restricción es toda la implementación. Un UUID generado en tiempo de llamada no es una clave de idempotencia; es solo un recibo de un duplicado.
- La compuerta lleva tres umbrales, no uno solo.
pass^kuno para confiabilidad, un conteo de acciones fuera del sobre de control para contención, y una verificación de radio de impacto con fallo inyectado para los dispositivos que nunca se activan cuando todo va bien.
Deliberadamente ausentes: concurrencia (dos ejecuciones compitiendo por el undo log), una cola de aprobación humana detrás de la ruta de escalamiento, un modelo real, una base de datos real — el ledger de idempotencia es un diccionario. El estado honesto de ambos proyectos es ejecutable y con compuerta, no desplegado y medido.
La misma historia, cinco salidas
Un solo hilo conductor, luego una puerta para cada lector. Toma una decisión y una acción; deja el resto.
| Si eres | La decisión que cambia este episodio | Una acción, esta semana |
|---|---|---|
| un estudiante de secundaria | "Darle herramientas a la IA" es diseñar una cocina, no simplemente entregarle un cuchillo. | Ejecuta el laboratorio en Colab (5 segundos, sin clave) y explica pass@k versus pass^k a un amigo. |
| un ingeniero de IA | Tu métrica de confiabilidad probablemente es pass@k, y se queda en 1.000 incluso cuando el agente se comporta mal. | Calcula pass^5 para un agente tuyo, junto con un conteo de acciones que salieron del sobre de control. |
| un fundador | Un diagrama de permisos no es prueba de calidad; un envelope bien definido hace que un agente sea seguro, no necesariamente bueno. | Pídele a tu equipo pass^k y el conteo de acciones fuera del envelope. Si nadie tiene el segundo número, ahí está el hallazgo. |
| un ejecutivo | La pregunta clave sobre un sistema autónomo es cuáles acciones son irreversibles y cómo están limitadas. | Agrega "qué verbos no están permitidos y cuál es el límite de radio de impacto" a la próxima revisión de arquitectura. |
| un inversionista | Cualquier empresa de agentes puede mostrar un buen demo; el envelope y su filtro de control son lo que realmente cuesta replicar. | Pide pass^k y pass@k juntos y compáralos. Uno sin el otro es puro teatro. |
Misión Realidad
Quince minutos, sobre algo que ya tienes corriendo esta semana.
- Elige un agente o automatización al que le hayas dado herramientas — cualquier cosa que pueda escribir, enviar, gastar o borrar.
- Anota cada verbo que puede ejecutar — no los que pensabas darle, sino los que realmente son accesibles desde el código. Este paso por sí solo suele ser el hallazgo.
- Marca cada verbo como reversible o irreversible. Los verbos irreversibles necesitan una allow-list; los reversibles pueden manejarse con un undo log. La mayoría tiene el log, pero no la lista.
- Ejecuta una tarea representativa cinco veces y cuenta cuántas veces las cinco tuvieron éxito. Ese es tu
pass^5; compáralo con el número que has estado citando. - Busca un mecanismo de seguridad y pregunta cuándo fue la última vez que se activó. Si la respuesta es nunca, escribe la prueba que lo haga activarse.
Si en el paso 2 aparecen verbos que no sabías que eran accesibles, detente ahí. Todo lo demás en este episodio es optimización sobre un límite que aún no has definido.
Desafío de investigación
Pre-registra la predicción antes de ejecutarla — un resultado que no predijiste es un resultado que vas a racionalizar.
Toma una tarea de agente con un resultado verificable y una superficie real de herramientas. Establecepass@kypass^kpara k ∈ {1,3,5,8} sobre N ≥ 100 con parámetros fijos, más un conteo de acciones fuera de una allow-list declarada. Luego elimina un elemento del envelope uno a la vez — allow-list, dry-run, validación de salida, retry acotado — en orden aleatorio, reportando el efecto marginal de cada uno sobrepass^ky sobre el conteo de acciones fuera del envelope por separado. Repite en dos modelos.
Pre-registra: si el elemento que aporta más al efecto enpass^kes el mismo que aporta más al efecto de contención, y si ese orden se mantiene en ambos modelos.
La respuesta de mi stub: son diferentes elementos — el retry aporta confiabilidad, la allow-list aporta contención — y el paper de Dhage es la razón para esperar que ese orden cambie entre modelos. Que un solo elemento aporte ambos en un sistema real sería un resultado más interesante que el mío.
Qué cambió
Estado de este peldaño al momento de publicación, a partir de una sincronización semanal en vivo de 30 fuentes pioneras en research-anything (make watch-sync), ordenadas por señal técnica, nunca por alcance. Fecha de sincronización: 2026-09-11. Cada elemento fue obtenido directamente, no resumido del título del feed.
- El nuevo roadmap de MCP (2026-08-22) — los responsables publicaron "an updated roadmap for the Model Context Protocol (MCP), covering the next specification release and beyond" (Traducción: "una hoja de ruta actualizada para el Model Context Protocol (MCP), que abarca la próxima versión de la especificación y más allá"), destacando la seguridad a nivel empresarial y nuevas primitivas mejoradas entre sus líneas. La capa de herramientas del harness ahora se regula como un estándar, no como una simple funcionalidad.
- arXiv:2608.27443 (2026-08-27) — ¿Las políticas de permisos escritas por el usuario mejoran la protección contra el exceso de alcance de los agentes de IA?, Ting Yan. 113 participantes sin formación en ingeniería supervisaron un día simulado de 18 acciones, incluyendo 7 acciones de exceso de alcance, bajo tres condiciones. Un resultado incómodo para cualquiera que venda gobernanza de agentes basada en políticas: "POLICY blocked less overreach than HITL (-20.1 percentage points, 95% CI [-32.1, -8.1])" (Traducción: "POLICY bloqueó menos excesos que HITL (-20.1 puntos porcentuales, IC 95% [-32.1, -8.1])"). Escribir tu propia política de permisos resulta más difícil que aprobar acciones una por una — el primer dato concreto que conozco al respecto.
- arXiv:2609.00829 (2026-09-01) — HarnessEvolve: Aprendizaje a partir de trayectorias de referencia para la auto-evolución confiable de agentes, Jiang, W. et al., comienza tratando el harness como el elemento a optimizar: "Self-evolving agents advance toward autonomy by optimizing their harness---prompts, skills, tools, and execution logic---based on environmental feedback." (Traducción: "Los agentes auto-evolutivos avanzan hacia la autonomía optimizando su harness—prompts, habilidades, herramientas y lógica de ejecución—a partir de la retroalimentación del entorno.") El tercer peldaño le pasa la estafeta al cuarto, que es precisamente el tema del Episodio 4.
- Justo fuera de la ventana, pero directamente relacionado:arXiv:2608.14711, Más allá de pass@k: Midiendo la confiabilidad y seguridad de la generación de código agéntico (2026-08-11 — un día antes del corte de esta sección, así que aparece aquí en vez de arriba).
- Más antiguos pero fundamentales:arXiv:2405.15793 (SWE-agent, el resultado de ACI), arXiv:2406.12045 (τ-bench,
pass^k), y el de Lilian Weng Harness Engineering for Self-Improvement (2026-07-04), que sigue siendo la definición más clara de este nivel.
[OPEN] Lo que sigue igual: no hay una réplica de arXiv:2608.26197, ni encontré ningún estudio publicado que reporte pass^k junto con un conteo de acciones fuera del límite de control en un agente real — justo la medición que defiendo en este episodio, y que mi stub solo puede ilustrar en forma de ejemplo. Si conoces uno, corrígeme en público.
Prueba final
Haz la comprobación sin desplazarte hacia arriba.
- Define
pass@kypass^k, y di cuál de los dos experimenta realmente un cliente. - Nombra los cinco elementos del límite de control y señala cuáles tres son detectores.
- Un reintento acotado añadido por sí solo no cambió nada. ¿Qué debe estar presente antes de que un reintento aumente el conteo de llamadas prohibidas, y por qué?
- Un agente obtiene
pass@8 = 1.000. Nombra dos cosas que eso te dice y dos que no. - ¿Por qué
make gate-brokenno pudo probar el kill switch, y qué lo reemplazó?
Cliffhanger
Tú defines el límite de control.
Cada verbo en una allow-list. Cada destino verificado antes de ejecutar. Cada resultado validado en el punto de control. Un presupuesto de reintentos que es un presupuesto y no un bucle, y un kill switch con un número. La compuerta indica pass^5 1.000 y fuera-del-límite 0, y por una tarde crees que resolviste la cocina.
Luego miras la fila de completela fila, la que nunca cambió, y notas algo que el sobre de control nunca iba a resolver.
Los platos que regresaron del pase volvieron por una razón. Nadie la anotó. El mismo error en la misma estación en cada turno; cada turno se detecta; cada turno se repite. Nada de lo que ocurre esta noche es diferente al martes pasado, salvo que pagaste dos veces por los ingredientes.
Una cocina que detecta cada plato defectuoso y nunca aprende por qué no está mejorando. Es experta en desperdiciar comida.
Episodio 4 — ingeniería de bucles. Una ejecución sale bien y la siguiente es distinta, y la solución no es un reintento. Es un árbitro que no trabaja para el cocinero.
Lee también
Episodio 3 de Intelligence Engineering Adventures, Temporada 7 — La escalera de la cocina. Las afirmaciones en la fuente de la serie están clasificadas por tipo — definición, derivación, evidencia, decisión de ingeniería, pregunta abierta — y una metáfora puede introducir una afirmación pero nunca sirve como evidencia. Cada episodio incluye un notebook de Colab que corre en el nivel gratuito sin API key, más dos aplicaciones construidas desde cero — una personal y otra de tipo empresarial. La escalera de cinco peldaños es la de Feng et al. (arXiv:2608.21156); el sexto peldaño, ingeniería de evaluación, es de mi autoría. La sección "qué cambió" se genera a partir de una sincronización semanal en vivo de 30 fuentes pioneras, ordenadas por señal técnica y nunca por alcance de audiencia. Este artículo no contiene material de ningún empleador ni cliente. — Paul Jialiang Wu · futuremake.io
Referencias
- Yang, J., Jimenez, C. E., Wettig, A., Lieret, K., Yao, S., Narasimhan, K., Press, O. (2024). SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. arXiv:2405.15793, enviado el 2024-05-06. — artefacto consultado: la página de resumen de arXiv. Fuente de las dos citas sobre ACI y la tasa de pass@1 de 12.5% en SWE-bench.
- Yao, S., Shinn, N., Razavi, P., Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv:2406.12045, enviado el 2024-06-17. — artefacto consultado: la página del resumen en arXiv. Fuente de
pass^ky de las cifras citadas de <50% / pass^8 <25%. - Anthropic — Schluntz, E., Zhang, B. (2024-12-19). Building Effective Agents. anthropic.com/engineering. — artefacto consultado: la publicación técnica en vivo, obtenida el 2026-09-11. Fuente de la regla práctica sobre HCI/ACI y del tercer principio clave.
- Dhage, S. (2026). Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197, enviado el 2026-08-25. — artefacto consultado: la página del resumen en arXiv. Fuente del resultado 1-de-4 / 2-de-4 en el primer pase, la diferencia entre costo de tokens y latencia, y el cierre "measured, not assumed" (Traducción: medido, no asumido).
- Weng, L. (2026-07-04). Harness Engineering for Self-Improvement. lilianweng.github.io. — artefacto consultado: la entrada publicada en vivo. Fuente de la definición completa de harness citada.
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. et al. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2, revisado el 2026-08-26. — artefacto consultado: la página del resumen en arXiv. Declaración publicada de la escalera, incluyendo "Harness Engineering to organize external tools and resources" (Traducción: Ingeniería de harness para organizar herramientas y recursos externos).
- Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., Cao, Y. (2022). ReAct: Synergizing Reasoning and Acting in Language Models. arXiv:2210.03629, enviado el 2022-10-06. — artefacto consultado: la página del resumen en arXiv.
- Schick, T., Dwivedi-Yu, J., Dessì, R. et al. (2023). Toolformer: Language Models Can Teach Themselves to Use Tools. arXiv:2302.04761, enviado el 2023-02-09. — artefacto consultado: página del resumen en arXiv.
- Patil, S. G., Zhang, T., Wang, X., Gonzalez, J. E. (2023). Gorilla: Large Language Model Connected with Massive APIs. arXiv:2305.15334, enviado el 2023-05-24. — artefacto consultado: página del resumen en arXiv.
- OpenAI (2023-06-13). Function calling and other API updates. openai.com. — descrito, no citado.
- Anthropic (2024-11-25). Introducing the Model Context Protocol. anthropic.com/news. — artefacto consultado: el anuncio en vivo, fuente de la definición citada. Documentación actual de la especificación: modelcontextprotocol.io (página principal sin fecha, citada por la especificación y no por una fecha).
- Model Context Protocol maintainers (2026-08-22). The New MCP Roadmap. blog.modelcontextprotocol.io. — artefacto consultado: publicación en vivo.
- Yan, T. (2026). Do User-Authored Permission Policies Improve Protection Against AI Agent Overreach? arXiv:2608.27443, enviado el 27 de agosto de 2026. — artefacto consultado: la página del resumen en arXiv, fuente del resultado citado de −20.1 puntos porcentuales.
- Jiang, W., Chu, M., Tian, Y. et al. (2026). HarnessEvolve: Aprendizaje a partir de trayectorias de referencia para la auto-evolución confiable de agentes. arXiv:2609.00829, enviado el 1 de septiembre de 2026. — artefacto consultado: la página del resumen en arXiv.
- Jiang, Jiajun, Zheng, S., Vidra, N., Setty, S. (2026). Más allá de pass@k: Medición de la confiabilidad y seguridad en la generación de código agéntico. arXiv:2608.14711, enviado el 11 de agosto de 2026. — listado en "Qué cambió" como justo fuera del periodo analizado.
- Jimenez, C. E., Yang, J. et al. (2023). SWE-bench: ¿Pueden los modelos de lenguaje resolver problemas reales de GitHub? arXiv:2310.06770. — el benchmark sobre el que se mide la cifra de 12.5% pass@1.
- Lab 03 y ambos proyectos, todos los datos y cifras de este artículo son reproducibles desde ellos: gist.github.com/wjlgatech/218a4a45533812ebe0b3f0e577dd6be7.
- Intelligence Engineering Adventures, Temporada 6 — The Governor Engine, episodios 1 y 3, para el argumento de que el diagrama de anidamiento no sobrevive al contacto y que ninguna etiqueta aquí puede expresar estabilidad.