Serie AI-Native · Ingeniería de Agentes, Comparada: Prompts · Contexto · Harness · Bucles · Grafos
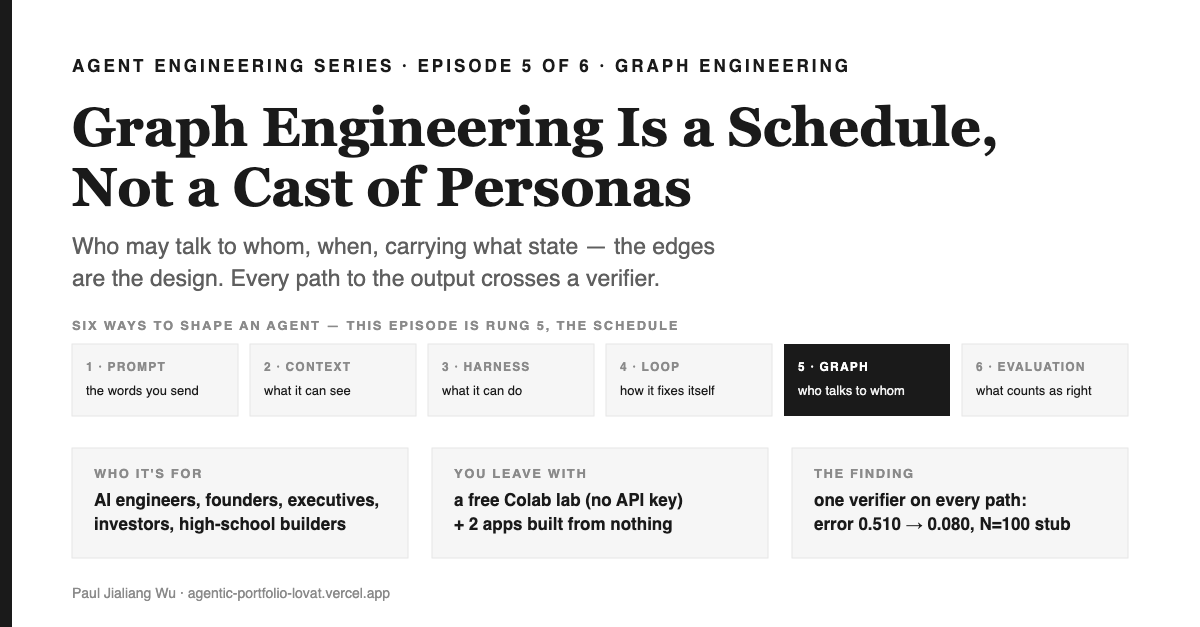
La ingeniería de grafos es un calendario, no un reparto de personajes
Episodio 5 de 6. Esta serie compara las formas en que la gente diseña agentes de IA —ingeniería de prompts, contexto, harness, bucles y grafos—: de dónde viene cada una, qué controla, quién la impulsa y qué principios sobreviven a la medición. Este episodio es el peldaño donde un solo agente deja de ser suficiente, y donde casi todos compran lo equivocado.
Resumen en un minuto — lo que aprenderás
Qué es esto. Una serie comparativa sobre las formas de diseñar un agente de IA —ingeniería de prompts (las palabras que envías), ingeniería de contexto (lo que puede ver), harness engineering (lo que puede hacer), ingeniería de bucles (cómo se corrige a sí mismo) y ingeniería de grafos (cómo se coordinan varios agentes). Este episodio es sobre ingeniería de grafos: su historia de 2023 a 2026, quién la impulsa y el principio que sobrevive a la medición: las conexiones son el diseño, los personajes son disfraz.
Por qué importa. Los sistemas multiagente se venden como un elenco, cuestan alrededor de quince veces más que un chat y fallan de formas en las que ningún agente individual falla. Una taxonomía construida a partir de más de 1,600 trazas anotadas en siete frameworks coloca un tercio de sus categorías de falla en verificación de tareas únicamente. En mi propio laboratorio con semillas, manteniendo fijos los cuatro trabajadores y sus nombres de rol y cambiando solo la configuración de conexiones, la tasa de error de extremo a extremo pasó de 0.510 a 0.080 (simulador N=100); y un atajo (una conexión directa) que rodea el nodo de verificación, en un sistema que aún contiene ese nodo, la devolvió a 0.240 — unas 2–3× en N=100 (2.4× en expectativa). Para una persona fundadora, eso es la diferencia entre una demo y una factura. Para una persona ingeniera, es una verificación que se ejecuta en microsegundos y no necesita modelo.
Qué puedes hacer después de leer. Dibuja tu sistema de agentes como una lista de conexiones, encuentra cada camino que llega a la salida sin cruzar un verificador y cuenta eso como un fallo de build. Obtienes un notebook de Colab gratuito (sin API key, segundos de CPU) que mide cuatro topologías en paralelo, y dos apps construidas desde cero: un planificador de cenas donde una sola agenda no deja pasar ninguno de los 224 conflictos cruzados (por construcción), mientras que un chat basado solo en personajes detecta 50; y un grafo de respuesta a incidentes cuyo make gate sale en 1 e identifica el camino exacto en cuanto alguien añade el atajo.
Season 7 — la espina de la serie
- Ingeniería de prompts — una especificación, no un hechizo episodio 1
- Ingeniería de contexto — un presupuesto, no una ventana más grande episodio 2
- Ingeniería de harness — el envelope, no el agente episodio 3
- Ingeniería de bucles — un árbitro externo, no un reintento episodio 4
- Ingeniería de grafos — una agenda, no un elenco de personajes este episodio
- Ingeniería de evaluación — la función de verdad, no un leaderboard episodio 6
Qué cubre este episodio y por qué la ingeniería de grafos va en quinto lugar
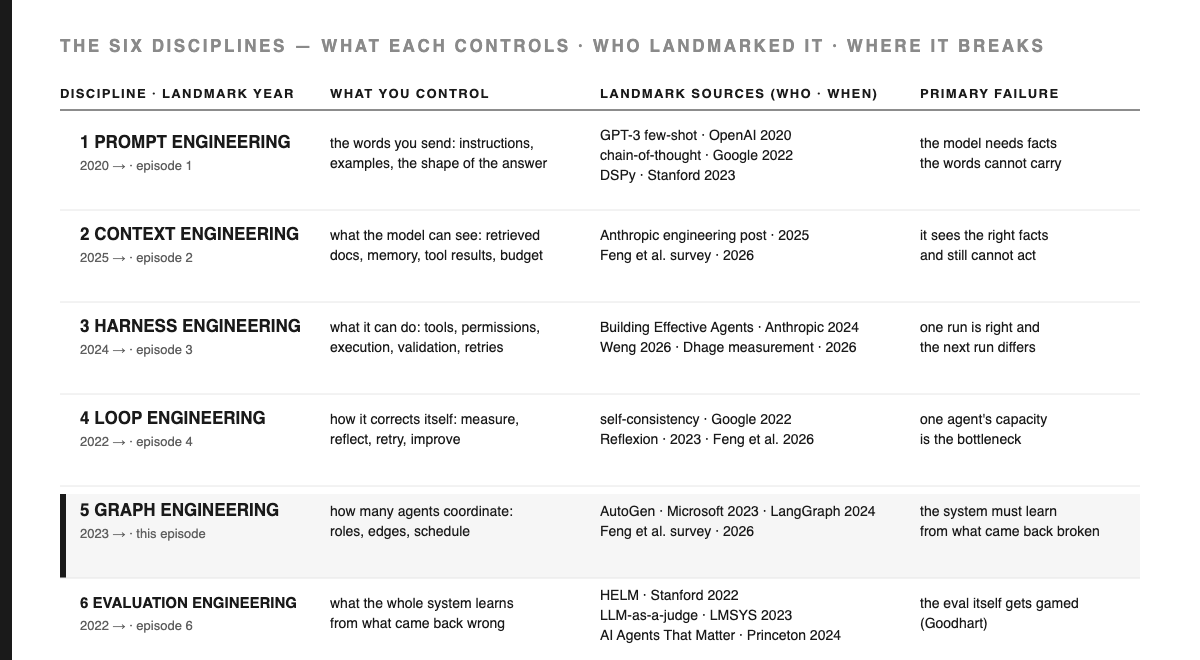
Ahora existen seis disciplinas con nombre para construir agentes de IA, que surgieron más o menos en este orden: ingeniería de prompts (2020), ingeniería de bucles y de evaluación (2022), ingeniería de grafos (2023), ingeniería de harness (2024), ingeniería de contexto (2025). La declaración publicada más clara de las primeras cinco es el survey de Feng et al. (arXiv:2608.21156), que las ordena según lo que cada una te permite controlar en vez de por antigüedad: prompt → contexto → harness → loop → graph. El sexto peldaño no es suyo ni es una cita — la ingeniería de evaluación es una propuesta propia de esta serie, y el Episodio 6 la defiende en vez de darla por sentada. Esta serie toma una por episodio, en ese orden, y plantea las mismas cuatro preguntas para cada una: de dónde viene, qué puedes controlar, quién la impulsa y qué tipo de fallo te obliga a subir al siguiente peldaño.
La ingeniería de grafos es el peldaño al que llegas cuando lo que escasea ya no es la capacidad del agente, sino su capacidad organizacional: varios tipos de especialización a la vez, subtareas que dependen entre sí, trabajo que puede ejecutarse en paralelo, un resultado que alguien tiene que verificar, estado que sobrevive entre pasos. Dejas de afinar a un solo trabajador y empiezas a diseñar quién entrega qué a quién — y aquí es donde la ingeniería más confiada de la industria se hace sobre su objeto menos comprobable: una lista de roles.
A quién va dirigido esto. Un ingeniero a punto de añadir un segundo agente, o corrigiendo errores en un sistema con cinco. Un fundador decidiendo si "multi-agente" es arquitectura o solo material para la presentación. Un ejecutivo al que le dijeron que la respuesta es más agentes, y quiere ver la factura. Un estudiante de secundaria que quiere saber qué significa "orquestación" sin el misticismo del organigrama. Prerrequisito: haber encadenado dos llamadas a modelos alguna vez.
De dónde viene la ingeniería de grafos y quién la impulsa
[DEF] A grafo aquí es lo que es en una clase de matemáticas discretas: nodos y aristas dirigidas. Los nodos son unidades de trabajo — un agente, una herramienta, una verificación. Las aristas indican quién puede entregar trabajo a quién. La ingeniería de grafos consiste en diseñar esa estructura de forma deliberada en vez de dejar que emerja. La historia es cómo la industria pasó de "dos chatbots conversando" a "un grafo de ejecución compilado".
| Cuándo | Hito | Quién | Qué cambió |
|---|---|---|---|
| 2023-03 | CAMEL (arXiv:2303.17760) | Li et al., KAUST | Dos agentes sostienen una conversación de rol sin ningún humano en el circuito. La primera respuesta ampliamente copiada a "¿y si el otro interlocutor también es un modelo?". |
| 2023-07 | ChatDev (arXiv:2307.07924) | Qian et al., Tsinghua | Una empresa de software planteada como una conversación con un orden fijo. El chat chain convierte la secuencia en el propio artefacto: la primera pista de que el calendario —la agenda— es el diseño. |
| 2023-08-01 | MetaGPT (arXiv:2308.00352) | Hong et al. | Procedimientos operativos estandarizados codificados como secuencias de prompts, en una línea de ensamblaje, para que los agentes "verify intermediate results and reduce errors" (Traducción: verifiquen resultados intermedios y reduzcan errores). La verificación entra en la arquitectura. |
| 2023-08-16 | AutoGen (arXiv:2308.08155) | Wu et al., Microsoft | Los patrones conversacionales pasan a ser programables en código en vez de en prosa. El framework multi-agent por defecto de la industria durante dos años. |
| 2024-02 | More Agents Is All You Need (arXiv:2402.05120) | Li et al., Tencent | Muestreo y votación: el rendimiento escala con el número de agentes, sin comunicación entre ellos. El argumento más fuerte de que el reparto no es lo importante. |
| 2024 | LangGraph (github.com/langchain-ai/langgraph) | LangChain | El grafo se convierte en un objeto de primera clase en las herramientas: nodos, conexiones y un estado compartido explícito que puedes inspeccionar entre pasos. |
| 2025-03 | Why Do Multi-Agent LLM Systems Fail? (arXiv:2503.13657) | Cemri et al., UC Berkeley y colaboradores | La primera taxonomía de fallos para estos sistemas, construida a partir de trazas anotadas en siete frameworks. Multi-agent deja de ser solo una idea difusa y pasa a ser un sistema con defectos identificados y nombrados. |
| 2025-04-09 | Protocolo Agent2Agent (developers.googleblog.com) | La conexión se convierte en un protocolo entre proveedores: agentes en diferentes frameworks se descubren y delegan tareas entre sí. Una conexión ahora es una interfaz, no una simple importación. | |
| 2025-06-13 | Cómo construimos nuestro sistema de investigación multi-agent (anthropic.com/engineering) | Anthropic | Un informe de producción que muestra ambas caras: una gran mejora en una evaluación interna, y el multiplicador de tokens que la hace posible. |
| 2026-08 | Graph Engineering in the Era of LLM Agents (arXiv:2608.21156v2) | Feng et al. | Nombra el paradigma, lo ubica en quinto lugar y argumenta que la restricción clave es organizacional, no cognitiva. |
| 2026-09-04 | Inference-Time Graph Engineering (arXiv:2609.05774) | Tieu et al. | Separa la compilación del grafo de su ejecución, permitiendo inspeccionar la topología antes de ejecutarla. Así comienza la era del compilador. |
[DISEÑO] Tres cosas a notar. Primero, el campo arrancó en 2023 con la conversación como elemento básico y ha pasado tres años reemplazándola por estructura: CAMEL tiene dos interlocutores, ChatDev un orden, AutoGen patrones, LangGraph una lista de conexiones, y el trabajo de 2026 un compilador. Segundo, la verificación aparece pronto — MetaGPT ya verifica resultados intermedios en agosto de 2023 — y luego casi desaparece del marketing, que es justo la brecha de la que trata este episodio. Tercero, el resultado empírico más contundente de la tabla dice que quizá ni siquiera necesitas el grafo: muestrear respuestas independientes y votar escala el rendimiento sin ninguna conexión.
Quién lo impulsa ahora. Los proveedores de frameworks (LangGraph, la línea de AutoGen) son quienes poseen las abstracciones que los ingenieros realmente escriben. Los laboratorios de modelos publican la experiencia de producción — el informe de Anthropic es la descripción pública más detallada de cuánto cuesta operar un sistema multi-agent. El A2A de Google convierte una conexión en algo que dos empresas pueden compartir. El lado académico se ha dividido de forma útil: una mitad sistematiza el paradigma (Feng et al.), la otra mide cómo se rompe (Cemri et al., los papers de topologías de 2026). Lee la segunda mitad primero.
El modelo mental de la serie: la escalera de la cocina
Una imagen resume los seis episodios, planteada como herramienta y no como historia. Cada cocinero sube la misma escalera: primero cocina para sí mismo, luego para la familia, después en una cocina de restaurante, luego en una cadena de comida rápida, y finalmente en la cadena nacional de suministro que alimenta a varias cadenas. Cada ingeniero de IA sube una equivalente — estudiante escolar, desarrollador junior, desarrollador senior, líder técnico de IA, CTO, líder de frontera.
Este episodio es la cadena nacional de suministro: muchas cocinas, un solo calendario, una flota de camiones. Fíjate en cuál es el trabajo a esa altura. No cocinas; ni siquiera pruebas la comida. Decides qué depósito envía a qué cocina, qué envío se inspecciona antes de llegar a la estantería y qué pasa con un pallet que falla. Nadie que dirige un sistema alimentario nacional cree que la seguridad de la comida depende de cómo se describen los conductores.
| Peldaño | Cocina | Quién eres | Qué puedes definir |
|---|---|---|---|
| 1. prompt | la tarjeta de recetas — cocinas para ti mismo | estudiante | las instrucciones escritas que sigue quien cocina |
| 2. contexto | la despensa — cocinas para la familia | desarrollador junior | lo que hay sobre la mesa y en el refrigerador mientras se cocina |
| 3. harness | la cocina de restaurante | desarrollador senior | las estaciones, las herramientas al alcance y el pase donde se revisa cada plato |
| 4. loop | la cadena de comida rápida | líder técnico de IA | probar, medir, corregir y desplegar la mejora en cada sucursal |
| 5. graph | la red nacional de suministro — muchas cocinas, un solo horario, una sola flota de camiones | CTO | qué depósito envía a qué cocina, en qué orden y qué se inspecciona en el trayecto |
| 6. evaluación | el registro de recuperación | líder de frontera | lo que todo el sistema alimentario aprende de lo que salió mal |
Dos ejes, no uno. Esto no es una escalera que subes y dejas atrás: cada cocina tiene las seis capas a la vez. Un cocinero en casa tiene una tarjeta, una despensa, una estufa, un gusto, un proveedor y una memoria de lo que falló la última vez. Lo que cambia al subir es cuántas capas puedes intervenir y con cuánta rigurosidad ejecutas cada una: primero a ojo, luego medido, luego con compuerta, luego autocorregido. Una cadena nacional con un diagrama precioso pero sin paso de inspección es menos madura que un solo restaurante que pesa cada plato. Así que las disciplinas son capas (lo que controlas); la seniority es madurez (cómo las ejecutas); y la ingeniería de grafos no es automáticamente más avanzada que la de bucles. Ese error es el caro aquí, porque un grafo decorativo es inusualmente fácil de dibujar e inusualmente satisfactorio de presentar.
La analogía puede introducir una afirmación, nunca servir como evidencia — cada elemento está anclado en el mapa 1:1 de abajo. Y el episodio termina con el descubrimiento de que un sistema perfectamente agendado con inspección en cada ruta aún no puede decirte si la inspección es buena. Eso es el Episodio 6.
La escalera no es mía, y tampoco la palabra "grafo"
[DEF] El vocabulario, anclado a su fuente — porque este peldaño tiene más etiquetas competidoras que cualquier otro (orquestación, multi-agent systems, flujos de trabajo de agentes, enjambres, agentic mesh) y la mayoría nombra al elenco y no a la estructura.
El survey de Feng et al. (arXiv:2608.21156v2, revisado 2026-08-26, leído como el abstract de arXiv el 2026-09-11) nombra los cuatro peldaños debajo de este, y luego argumenta a favor de este. Su diagnóstico de por qué se necesita un quinto peldaño es una lista de cinco cosas, ninguna de ellas un rasgo de personaje:
"many tasks require heterogeneous expertise, interdependent subtasks, parallel execution, independent verification, and persistent state, exceeding any single agent's organizational capacity" (Traducción: muchos trabajos requieren experiencia heterogénea, subtareas interdependientes, ejecución en paralelo, verificación independiente y estado persistente, superando la capacidad organizacional de cualquier agente individual)
— Feng et al., 2026
Experiencia heterogénea. Subtareas interdependientes. Ejecución en paralelo. Verificación independiente. Estado persistente. Cada una es una propiedad de una estructura: qué nodo sabe qué, cuál espera a cuál, cuál verifica a cuál y qué sobrevive entre ellos. El survey llama a la meta System Intelligence, definida como "an agent system's ability to organize and coordinate multiple intelligent components into a coherent, adaptive whole pursuing a shared objective" (Traducción: "la capacidad de un sistema de agentes para organizar y coordinar múltiples componentes inteligentes en un conjunto coherente y adaptativo que persigue un objetivo compartido"), y deja claro que no se llega ahí simplemente añadiendo más integrantes al equipo: "Achieving it requires more than adding agents; it demands explicit structures to organize work, coordinate heterogeneous agents, and maintain evolving execution states." (Traducción: "Lograrlo requiere más que sumar agentes; exige estructuras explícitas para organizar el trabajo, coordinar agentes heterogéneos y mantener estados de ejecución en evolución.")
Y lo que construye es, en palabras del propio survey, "explicit, dynamic, evolving graph structures representing tasks, agents, and system states" (Traducción: "estructuras de grafos explícitas, dinámicas y en evolución que representan tareas, agentes y estados del sistema"). Tareas, agentes, estados. Tres tipos de nodo. Cero tipos de disfraz.
[OPEN] Observa lo que el survey no afirma: que este peldaño reemplace al anterior, o que un grafo supere a un bucle. Es un survey de principios, metodologías y aplicaciones — un mapa, no un resultado de referencia. Quien lo cite como prueba de que lo multi-agente supera a lo monolítico está citando un mapa como si fuera una medición.
La afirmación, clasificada
[DEF] La afirmación: en un sistema multi-agente, las aristas son el diseño — quién puede comunicarse con quién, cuándo y con qué estado — y los personajes son disfraz. Un personaje es una cadena en un prompt; una arista es un hecho sobre qué puede alcanzar a qué. Solo una de las dos puede comprobarse sin ejecutar el sistema.
[EVIDENCE] La primera razón para tomárselo literalmente es que alguien catalogó cómo fallan realmente estos sistemas, y el catálogo no trata de personajes. Cemri et al. (arXiv:2503.13657, leído como el abstract de arXiv el 2026-09-11, que corresponde a la v3 revisada 2025-10-26) abren negándose a asumir la premisa: "Despite enthusiasm for Multi-Agent LLM Systems (MAS), their performance gains on popular benchmarks are often minimal." (Traducción: "A pesar del entusiasmo por los sistemas LLM multi-agente (MAS), sus mejoras de rendimiento en benchmarks populares suelen ser mínimas.")
Lo que construyeron en cambio es un dataset — "1600+ annotated traces collected across 7 popular MAS frameworks" (Traducción: "más de 1600 trazas anotadas recogidas en 7 frameworks MAS populares") — y una taxonomía derivada de una lectura detallada de 150 de ellas con anotadores humanos,"validated by high inter-annotator agreement (kappa = 0.88)". El resultado, MAST:
"This process identifies 14 unique modes, clustered into 3 categories: (i) system design issues, (ii) inter-agent misalignment, and (iii) task verification." (Traducción: "Este proceso identifica 14 modos únicos, agrupados en 3 categorías: (i) problemas de diseño del sistema, (ii) desalineación entre agentes y (iii) verificación de tareas.")
— Cemri et al., arXiv:2503.13657
[DERIVATION] Lee los tres nombres como un ingeniero lee una traza de errores.Problemas de diseño del sistema — la estructura está mal.Desalineación entre agentes — las conexiones llevan lo incorrecto, o en el momento equivocado.Verificación de tareas — nadie verificó. Ninguno es "the Researcher agent was insufficiently curious" (Traducción: el agente Investigador fue insuficientemente curioso), y un tercio completo del nivel superior de la taxonomía es la ausencia de una verificación.
[EVIDENCE] La segunda razón es el informe de producción más honesto en este nivel. El reporte de Anthropic sobre su sistema de investigación multi-agente (2025-06-13) muestra una gran mejora:"We found that a multi-agent system with Claude Opus 4 as the lead agent and Claude Sonnet 4 subagents outperformed single-agent Claude Opus 4 by 90.2% on our internal research eval." (Traducción: "Descubrimos que un sistema multi-agente con Claude Opus 4 como agente principal y subagentes Claude Sonnet 4 superó al Claude Opus 4 de agente único en un 90.2% en nuestra evaluación interna de investigación.") Un número real de un sistema real, con el alcance declarado en la propia frase: una evaluación interna, una disposición de líder y subagentes, una sola familia de modelos.
Y en el mismo post, el precio, que casi nadie menciona:
"In our data, agents typically use about 4× more tokens than chat interactions, and multi-agent systems use about 15× more tokens than chats." (Traducción: "En nuestros datos, los agentes suelen usar unas 4× más tokens que las interacciones de chat, y los sistemas multi-agente usan alrededor de 15× más tokens que los chats.")
— Anthropic, 2025-06-13
[DERIVATION] Quince veces no es un error de redondeo; es otro empleado más. Puestas lado a lado, las dos frases te dan la decisión que realmente plantea este nivel — no ¿es mejor multi-agente? sino ¿vale esta tarea quince chats?. Una lista de personajes nunca te obliga a hacer esa cuenta. Una lista de conexiones sí, porque cada conexión es un mensaje y cada mensaje son tokens.
[EVIDENCIA] La tercera razón es la contraprueba, lo bastante fuerte como para que este episodio tenga que enfrentarla en vez de relegarla a una nota al pie. El trabajo de Li et al., More Agents Is All You Need (arXiv:2402.05120) muestra que muestrear muchas respuestas y tomar una votación mayoritaria mejora el desempeño a medida que añades agentes — sin coordinación, sin roles, sin conexiones en absoluto. Si ese es el efecto, la mayoría de lo que la gente construye en este peldaño es maquinaria elaborada para un resultado que podrías obtener con un for loop y un contador.
El seguimiento de 2026 lo deja cristalino. Ann, Liu y Tan, en The Interaction Tax (arXiv:2608.23541, 2026-08-24) prueban once tareas de optimización evaluadas por verificadores bajo presupuestos igualados y encuentran que hablar puede destruir justo aquello para lo que compraste varios modelos: "when agents read each other's complete outputs, their proposals converge within one round, erasing the diversity that motivates using multiple models" (Traducción: cuando los agentes leen las salidas completas de los demás, sus propuestas convergen en una sola ronda, borrando la diversidad que motiva usar varios modelos). Su conclusión es la tesis de este episodio, pero desde la dirección opuesta — "multi-agent performance depends less on the number of agents than on the information they exchange" (Traducción: el desempeño multi-agente depende menos del número de agentes que de la información que intercambian).
[DERIVACIÓN] Así que la regla que sobrevive a ambos artículos: añadir agentes no ayuda de forma confiable y añadir conversación puede perjudicar; lo que sí ayuda es diseñar qué cruza cada conexión y cuándo, con una verificación independiente antes de la salida. El muestreo independiente con voto es un grafo perfectamente respetable — un fan-out con un agregador y sin interferencias — y si tu problema tiene un verificador barato, puede ser el mejor grafo que puedas construir. Esa es una decisión sobre conexiones. No es una decisión sobre quién es el Crítico.
Mapa técnico 1:1
Cada elemento de la metáfora corresponde a algo que puedes señalar en el código.
| La cadena de suministro | El sistema | Dónde vive |
|---|---|---|
| un depósito, una cocina, un laboratorio | un nodo — una unidad de trabajo | una función, un agente o una llamada a herramienta |
| una ruta en el itinerario | una conexión dirigida — quién puede entregar trabajo a quién | una entrada en la lista de conexiones |
| el itinerario completo | el calendario — todo el grafo | edges: list[tuple[str, str]] |
| lo que transporta el camión | la carga útil del mensaje y el estado compartido | el objeto de estado tipado que se transmite por la conexión |
| la inspección antes de colocar algo en el estante | el nodo verificador | una comprobación determinista sobre el estado combinado |
| "ningún pallet llega a un estante sin ser inspeccionado" | el invariante de alcanzabilidad | unverified_path_share == 0.000 |
| el atajo que toma un depósito un domingo | la conexión de bypass | una tupla extra en la lista de conexiones |
| el puesto del conductor en el manifiesto | la cadena de personaje | un campo de prompt que ninguna transición utiliza |
| combustible consumido por entrega | el multiplicador de tokens | mensajes × tamaño de carga útil |
| un depósito repitiendo al depósito anterior | conformidad — colapso de la diversidad | el impuesto de interacción en una conexión de salida completa |
[DEF] Los tres números clave sobre los que se apoya el resto de este episodio, definidos una sola vez:
- Tasa de error de extremo a extremo — en N ejecuciones idénticas, la fracción en la que al menos un campo de la salida es incorrecto.
- Costo — mensajes y tokens por ejecución. Una conexión no es gratis, y comparar topologías sin considerar el costo es hacer publicidad.
- Proporción de rutas no verificadas — de todos los caminos simples desde una fuente hasta la salida, la fracción que omite al verificador. Se calcula solo a partir del grafo: sin muestreo, sin modelo, sin semilla.
El tercero es la aportación: los dos primeros se obtienen por muestreo y dependen de tu modelo, tu temperatura o tu suerte, mientras que el tercero es decidible. Por eso pertenece al CI y los otros dos al panel de control.
Puerta de predicción
Antes de seguir leyendo, comprométete: una predicción que no anotaste es una que jurarás haber acertado.
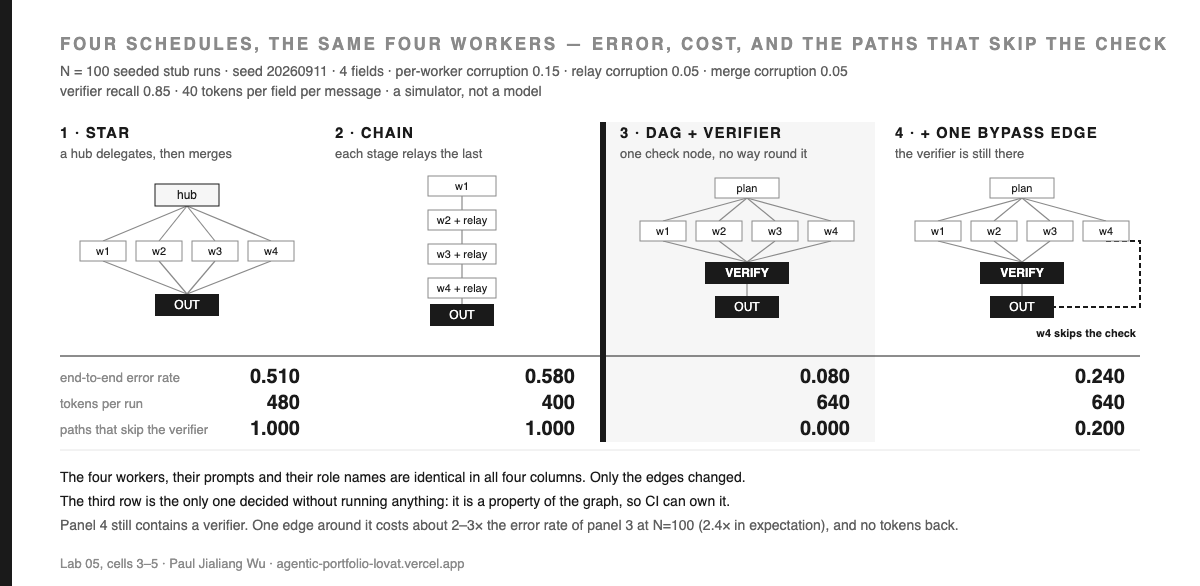
Cuatro especialistas, un campo cada uno en una respuesta de cuatro campos. Todos los parámetros, declarados antes de que intentes adivinar:corrupción por trabajador 0.15 · corrupción por relevo 0.05 · corrupción al fusionar 0.05 · recall del verificador 0.85 · 40 tokens por campo por mensaje. Tres configuraciones: una estrella (un nodo central delega y fusiona, y puede corromper un campo al fusionar), una cadena (cada etapa escribe su propio campo y retransmite todo lo anterior), y un DAG donde los cuatro trabajadores alimentan a un verificador antes de la salida.
Q1. Ordena los tres por tasa de error de extremo a extremo, del peor al mejor. Luego predice el tamaño de la brecha entre el mejor y el peor.
Q2. Ordena esos mismos tres por tokens por ejecución, del más caro al más barato.
Q3. Ahora toma el DAG, deja el verificador exactamente donde está, y añade una conexión desde el cuarto trabajador directo a la salida — el atajo que alguien mete por latencia. Ahora un campo de cada cuatro se salta la revisión. ¿Qué pasa con la tasa de error de extremo a extremo: más o menos se duplica, o peor?
Las respuestas están en el Notebook y en la Sala de Fallos. Si la P1 puso la cadena en el medio, ejecuta el laboratorio.
Sala de Fallos
Rómpe lo a propósito — un mecanismo que no puedes romper es solo una afirmación.
Fallo 1 — el reparto es el diseño. Nombras a cinco agentes, les das títulos de puesto y das por terminada la arquitectura. Pero ninguna transición en tiempo de ejecución lee un título: el router lee el grafo, el agregador lee el estado, la revisión lee los campos. Mi propio trabajo publicado sobre paneles de expertos midió esto desde el lado de la psicología: las etiquetas de personaje no mejoraron la precisión factual en 162 personajes y 2,410 preguntas, y lo que sí funcionó fue anclar un agente en el corpus de una persona, no en la descripción de un personaje. Un corpus es datos. Un disfraz es una cadena.Una opinión con diez sombreros lo explica de principio a fin.
Fallo 2 — el verificador que está solo en el papel. El único que justifica el precio del artículo. En el laboratorio, tanto el DAG con compuerta como el mismo DAG con una conexión de atajo tienen un nodo verificador, y ambos pasan a cualquier revisor que pregunte "¿tienes un paso de verificación?". El que tiene el atajo funciona con 0.240 tasa de error de extremo a extremo frente a 0.080 — aproximadamente entre 2 y 3 veces peor en N=100, 2.4× en expectativa — con exactamente los mismos 640 tokens, porque la verificación sigue ejecutándose en los otros tres campos. Pagas por la inspección y la saltas en una ruta. El número estático lo detecta en microsegundos: proporción de rutas no verificadas 0.000 → 0.200. Los números muestreados también lo capturan, aunque tarden, en N=100.
Fallo 3 — la cadena que parece impecable. La topología más barata del laboratorio (400 tokens frente a los 480 de la estrella y los 640 del DAG) es también la peor, con 0.580: el primer campo se escribe una vez con 0.15 y luego se retransmite tres veces con 0.05, así que tiene cuatro oportunidades de fallar frente a una sola del último campo. La propagación del error no es una propiedad de los trabajadores, sino de cuántas veces la topología permite que un valor sea manipulado de nuevo.
Fallo 4 — la conformidad que se vende como consenso. Haz que los agentes hablen más y dejan de discrepar, lo que parece progreso y es justo lo contrario: las propuestas convergen en una sola ronda cuando los agentes leen las salidas completas de los demás. En mi proyecto de cena, el brazo de chat basado solo en personajes detectó 50 de 224 conflictos cruzados, y los que se le escaparon no eran difíciles. Tres especialistas estuvieron de acuerdo unánimemente en un postre con nueces. El consenso fue impecable. También la alergia.
Fallo 5 — la métrica que marca 0.000 y no sirve para nada. Lleva la proporción de rutas no verificadas a 0.000 haciendo que el verificador devuelva True. Igual que la métrica de determinismo del Episodio 1 leyendo 1.000 en un objeto vacío: el invariante de alcanzabilidad debe reportarse junto a una métrica de resultado, nunca sola. La compuerta demuestra que hay una verificación en la ruta. No dice nada sobre si la verificación es buena — y eso es precisamente el tema del Episodio 6.
Respuesta a la P3: En este sorteo, aproximadamente se triplica (0.080 → 0.240); los parámetros del laboratorio sitúan el valor esperado en 0.206, alrededor de 2.4×. De cualquier forma, el mecanismo es lo importante: la corrupción del campo que se salta el control ahora sobrevive con certeza en vez de con probabilidad 0.15. Una compuerta que rodeas en uno de cada cuatro casos no es el 75% de una compuerta.
Cuaderno
Lab 05 — El horario, no los personajes. 
05_graph_schedule.ipynb · Colab gratuito · no API key · segundos de CPU · cada celda ejecutada antes de publicar, y los números de abajo son los que imprimió la ejecución.
Ocho celdas. El Graph objeto contiene nodos, conexiones, un nodo de salida y opcionalmente un verificador; las cuatro topologías no difieren en nada más.
parameters: per-worker corruption 0.15 · relay corruption 0.05 · merge corruption 0.05
            verifier recall 0.85 · 40 tokens per field per message · 4 fields

topology                            err    msgs   tokens  paths  unverified
star (hub + 4 workers)            0.510     9.0      480      4       1.000
chain (4 stages)                  0.580     4.0      400      1       1.000
DAG + verifier                    0.080    10.0      640      4       0.000
DAG + verifier, 1 bypass edge     0.240    10.0      640      5       0.200

  orphaned output   -> RAISES: no path reaches 'OUT' — the graph is
                       disconnected, not verified
[EVIDENCIA] Tres hallazgos, en orden de sorpresa.
La topología más barata es la peor. Yo esperaba que la cadena quedara entre la estrella y el DAG; resulta peor que ambas, con menos mensajes.
La conexión de atajo no cuesta nada y lo arruina todo. El conteo de tokens es idéntico, pero el error es unas 2–3× mayor a N=100. El atajo aquí no tiene ningún argumento de eficiencia — ni siquiera ahorra un mensaje — lo que lo convierte en un modelo limpio del caso real, donde ahorra un poco de latencia, cuesta mucha corrección y nadie mide ninguna de las dos.
La compuerta es aburrida, y ese es el punto. La celda 5 ejecuta la verificación de alcanzabilidad en los cuatro grafos y muestra el código de salida que usaría CI: microsegundos, sin llamadas, totalmente determinista. Dos de los cuatro fallan antes de que ocurra una sola ejecución — y un quinto grafo, cuyo resultado no es alcanzado por ningún camino, hace que la verificación lance una excepción en vez de marcar un cómodo 0.000.
El barrido en la celda 6 es la celda que vale la pena copiar: muestra cómo el grafo con atajo sigue el comportamiento de los brazos sin protección en vez del grafo con compuerta, a medida que el problema se complica.
| corrupción por trabajador | estrella | cadena | DAG + verificador | + conexión de atajo |
|---|---|---|---|---|
| 0.05 | 0.220 | 0.410 | 0.030 | 0.070 |
| 0.10 | 0.370 | 0.480 | 0.080 | 0.180 |
| 0.15 | 0.510 | 0.580 | 0.080 | 0.240 |
| 0.20 | 0.580 | 0.630 | 0.150 | 0.280 |
| 0.30 | 0.760 | 0.800 | 0.160 | 0.460 |
La columna con compuerta se mantiene casi plana mientras todas las demás suben — la marca de una solución estructural y no de un parche, e invisible si solo mides a un nivel de ruido, que es como casi todos miden.
[DISEÑO] La celda 7 es la directa. run_dag recibe un personas argumento; le pasé Chef Senior, Inspector Michelin, Nutricionista y Líder de Logística, que asigna a los cuatro trabajadores y lleva en el estado — la celda imprime el diccionario transportado, así puedes comprobar que realmente están ahí. La tasa de error cambió exactamente 0.000 y el conteo de tokens exactamente 0, y la razón es el hallazgo, no una excusa: ninguna línea en esa función ramifica según los personajes. En un sistema cuyo comportamiento es su grafo, un disfraz no tiene por dónde entrar. Eso no es una medición de modelos de lenguaje; es una demostración de dónde puede vivir la flecha causal. Los títulos siguen en el organigrama.
[DISEÑO] Por qué un stub. Un simulador reproduce dónde entra el error en una topología y qué lo elimina, en segundos, gratis, sin clave. no reproducir magnitudes: nada de lo que imprime sirve como evidencia para el 90.2% de Anthropic ni para nada en MAST. La celda 8 es el puente: cambia los lanzamientos de moneda por llamadas a modelos y el Graph, la compuerta y las tres métricas no cambian, porque por construcción no dependen del modelo.
Proyectos
Dos implementaciones, desde cero. Sin frameworks, nada más allá de la biblioteca estándar, ambas con semillas, ambas ejecutadas antes de escribir esta sección, ambas en el gist del notebook.
Proyecto 1 — vida real: the-dinner-party
p1_dinner_party.py · python3 p1_dinner_party.py 100
Cena para seis personas. Un invitado es vegano, otro tiene alergia a los frutos secos, el presupuesto es de 80 dólares, solo hay una rejilla de horno y todos se sientan a las 19:00. Tres stubs especializados escriben cada uno una parte del plan — agent_menu uno elige los platillos, agent_shopping otro calcula el costo de la canasta, agent_timing otro asigna los turnos del horno — y ninguno ve la salida de los demás. Cada uno es correcto y seguro por separado; los fallos viven entre ellos. Cada una de las cinco reglas que los detectan necesita datos de dos especialistas, que es la razón estructural por la que ningún especialista puede ser dueño de una sola:
allergen  needs  menu + the guest list      a dish contains nuts
diet      needs  menu + the guest list      the main is not vegan and one guest is
budget    needs  menu + shopping            the basket cleared $80
oven      needs  menu + timing              two dishes want the single rack at once
timing    needs  menu + timing              a dish finishes after people sit down
[EVIDENCE] Dos brazos, mismos especialistas, mismas semillas. El brazo A es un chat basado solo en personajes ficticios: hablan por turnos y quien sigue puede objetar. El brazo B es una sola agenda con un nodo verificador: los tres escriben en un estado compartido y luego un nodo de verificación ejecuta las cinco reglas.
conflicts present            : 224
caught by persona-only chat  : 50    (0.223 recall)
caught by schedule+verifier  : 224   (1.000 recall — by construction, see below)

dinners served with an unresolved conflict
  persona-only chat          : 85/100  (0.850)
  schedule + verifier        : 0/100   (0.000)

by rule: allergen 83 · oven 74 · timing 36 · diet 22 · budget 9
[OPEN] Lo que esto no prueba: la probabilidad de que el chat detecte algo es un dial que fijé en 0.30 con decaimiento, representando la tendencia a estar de acuerdo con tres párrafos seguros en vez de objetar. No es una medición de ningún modelo, y el 0.223 es tan real como ese dial. Lo estructural es que una regla que necesita datos de dos especialistas no tiene dueño hasta que el grafo se lo da. Ninguna descripción de puesto dice "la interacción entre mi salida y la de otro". Y el 1.000 del brazo agenda es 1.000 por construcción: el nodo verificador ejecuta las mismas cinco reglas que definen un conflicto, así que no puede perderse ninguna. Lo que mide esto es la pérdida del brazo chat, no la habilidad del verificador — la misma métrica vacía que advierte el Fallo 5, aquí revelada porque es mía.
Proyecto 2 — empresa: the-incident-room
p2_incident_room.py · make gate · make bypass · make measure
Un grafo de respuesta a incidentes:
page → triage → diagnose → mitigate ─┐
                └────────→ rollback ─┼→ check → resolve
       triage → comms ───────────────┘
El invariante, en una frase: ningún camino de ningún nodo a resolve puede saltarse check. Es una propiedad del grafo, no de una ejecución, decidida enumerando caminos simples — sin llamadas a modelos, sin muestreo, sin aleatoriedad. Es la misma forma que una regla de alcanzabilidad de módulos que uso en mi propio harness de investigación — inédito, así que tómalo como práctica, no como cita.
$ make gate
  paths to 'resolve'        : 3
  paths that skip 'check'   : 0   (share 0.000)
  invariant: every path to 'resolve' crosses 'check' -> HOLDS     exit 0

$ make bypass          # after adding ("rollback", "resolve")
  paths to 'resolve'        : 4
  paths that skip 'check'   : 1   (share 0.250)
    BYPASS: page -> triage -> diagnose -> rollback -> resolve
  invariant: every path to 'resolve' crosses 'check' -> VIOLATED  exit 1
[EVIDENCE] La compuerta nombra el camino en vez de decir "algo está mal en algún lugar" — la diferencia entre un build fallido que alguien arregla y uno que alguien desactiva. En N=100 incidentes con semilla, cuatro reglas cruzadas que posee el nodo de verificación:
                                            gated     + one bypass edge
rule violations raised (all runs)              63                    63
incidents blocked at the check node   52/100 (0.520)        37/100 (0.370)
INCIDENTS RESOLVED WHILE DIRTY         0/100 (0.000)        15/100 (0.150)
La primera fila cuenta violaciones, las otras dos cuentan incidentes — un solo incidente puede levantar más de una violación, por eso las columnas no se restan. Stubs, prompts y personajes idénticos en ambas columnas. Cambió solo una conexión, y quince incidentes de cada cien cerraron con una violación sin corregir — monitores en rojo, una caída en la ruta de ingresos sin comunicación al cliente, sin causa raíz y sin rollback. Esa conexión de bypass es la que un ingeniero de guardia real añade a las 03:00 de un domingo por una razón genuinamente buena, y que sigue en el repositorio en marzo.
Constrúyelo en 30 minutos — el contrato
Todo lo que necesita la compuerta, en el orden en que lo pide una persona ingeniera.
INPUTS   edges: list[tuple[str, str]]     # the whole schedule, as data
         output:   str                    # the node that ends the run
         verifier: str                    # the node every path must cross

OUTPUT   unverified_path_share: float in [0, 1]
         offending_paths: list[list[str]]  # named, not counted

INVARIANT   unverified_path_share == 0.000

STOP RULE   the gate never retries and never repairs.
            It refuses, and prints the path. Repair is a human's job.

def unverified_share(edges, output, verifier):
    paths = simple_paths_to(edges, output)       # every source → output
    if not paths:                                # a graph nothing reaches is not verified
        raise ValueError(f"no path reaches {output!r} — the graph is disconnected, not verified")
    return sum(1 for p in paths if verifier not in p) / len(paths)

# CI gate (make gate)
#   unverified_path_share == 0.000   → exit 0
#   anything above                   → exit 1, printing each bypass path
Deliberadamente ausente, porque dejarlo fuera es parte del diseño: ciclos (el caminante se niega a volver a visitar un nodo, así que un bucle de reintentos te obliga a decidir qué significa "un camino" antes de poder ponerle una compuerta); conexiones añadidas en tiempo de ejecución por un agente que se reconfigura (un horario que cambia durante la ejecución necesita un invariante distinto); cualquier juicio sobre si el verificador es correcto; una salida a la que ningún camino llega (la compuerta lanza una excepción en un grafo desconectado en vez de marcarlo como 0.000, porque un cero ingenuo le daría luz verde a un grafo roto); y cualquier modelo real — si cambias los stubs por llamadas reales, la compuerta no cambia, porque nunca lee una ejecución.
[DISEÑO] Cuatro propiedades hacen que esto sea de tamaño empresarial y no solo una demo, y cada una se gana su lugar:
- El horario es dato, no rutas de código. Una lista de conexiones se puede comparar en un pull request. Un grafo implícito en qué función llama a cuál, no; así que el atajo llega de forma invisible.
- El invariante es estático, así que es lo bastante barato para cada commit. Una revisión que cuesta una llamada a modelo se ejecuta cada noche, luego cada semana, luego nunca.
- La compuerta nombra el camino, no el conteo. "Unverified share 0.250" es un número con el que discutir.
page → triage → diagnose → rollback → resolvees una frase que alguien arregla. - Las reglas entre campos viven en el nodo de verificación. Cada regla que necesita datos de dos agentes pertenece al nodo al que llegan ambas conexiones. En el prompt de un agente es la opinión de ese agente; en el grafo es la condición previa del sistema.
[ABIERTO] Lo que ninguno de los dos proyectos demuestra: ambos conjuntos de trabajadores son stubs y ambos golden sets son sintéticos. El estado honesto del build empresarial es ejecutable y con compuerta, no desplegado y medido. Lo que lo haría real sería correr la misma compuerta contra un grafo de orquestación de producción exportado del framework que uses, con el conteo de atajos reportado desde el primer día — y mi predicción pre-registrada es que la mayoría de los grafos de producción tienen al menos uno y nadie lo sabe.
Misma historia, cinco salidas
Un solo eje, una puerta para cada lector. Toma una decisión y una acción.
| Si eres | La decisión que este episodio cambia | Una acción para esta semana |
|---|---|---|
| un estudiante de preparatoria | "Multi-agent" es un diagrama de conexiones, no un elenco de personajes. Lo que diseñas son las conexiones. | Abre el laboratorio en Colab (sin clave, en segundos) y dibuja tu propio proyecto como cajas y flechas. Encierra en un círculo cada flecha que llegue a la respuesta sin pasar por una verificación. |
| un ingeniero de IA | El invariante de alcanzabilidad es una verificación estática que tu build puede controlar; la tasa de error no lo es. | Exporta tu grafo de orquestación como una lista de conexiones y ejecuta la compuerta de 12 líneas sobre él. Reporta cuántos atajos hay, aunque sea incómodo. |
| un fundador | Multi-agent cuesta alrededor de quince chats. La pregunta es si la tarea vale esos quince chats, no si la arquitectura es moderna. | Pide el número de tokens por tarea de tu sistema junto a su tasa de aciertos. Uno sin el otro no es un resultado. |
| un ejecutivo | "¿Tenemos un paso de revisión?" es la pregunta equivocada. "¿Puede algún camino llegar al resultado sin pasar por él?" es la correcta. | Agrega "unverified path share" a la próxima revisión de arquitectura y pide ver el build fallido en vez del diagrama. |
| un inversionista | Un elenco de personajes no es una barrera; un horario medido con una compuerta en CI podría serlo. | Pide a cualquier startup de agentes que te muestre la lista de conexiones y la compuerta. Si la respuesta es un organigrama de agentes, ya tienes tu respuesta. |
Misión Realidad
Quince minutos, sobre algo que ya ejecutas.
- Toma un sistema tuyo con más de una llamada a modelo y escríbelo como una lista de conexiones — pares de nombres de nodos, nada más. Si no puedes, ese es el hallazgo: el grafo existe, solo que no está escrito.
- Nombra el nodo de salida y el nodo verificador. Si no hay verificador, detente y escribe uno; todo lo que sigue trata de si es alcanzable, no de si es bueno.
- Enumera los caminos simples desde cada origen hasta la salida y cuenta cuántos se saltan el verificador. Ese es tu unverified path share.
- Para cada camino de atajo, averigua quién lo agregó y por qué. Siempre hay una razón y siempre es válida, por eso volverá a pasar.
- Pon la verificación en CI con un umbral de cero. Luego agrega deliberadamente un atajo y confirma que el build se pone en rojo — una compuerta que nunca has visto fallar es indistinguible de no tener compuerta.
Si en el paso 1 solo aparece un nodo, no estás en este nivel y no deberías estarlo. Vuelve al Episodio 4 y asegúrate de medir ese bucle primero. Un bucle bien medido siempre supera a un grafo decorativo, y el argumento de este episodio es sobre cuál de los dos construiste realmente.
Desafío de investigación
Entrégale esto a un agente y deja registrada tu predicción de antemano.
Toma una tarea con una salida verificable y cuatro especialistas. Mantén fijos los especialistas, sus prompts y sus nombres de rol. Varía únicamente la topología: estrella, cadena, muestreo independiente con voto mayoritario y un DAG donde todo camino cruce un verificador. Reporta la tasa de error de extremo a extremo, los tokens por ejecución y la proporción de caminos no verificados para cada uno, en tres niveles de ruido de los trabajadores. Luego añade una conexión de atajo al DAG con verificador y vuelve a reportar los tres.
Deja registrada tu predicción: si el muestreo independiente con voto supera al DAG verificado cuando el verificador es barato, y si el orden de las cuatro topologías se mantiene estable entre niveles de ruido o se cruza.
Mi predicción, registrada antes de que lo ejecutes: sampling-and-vote gana en coste y pierde en el invariante, porque un voto solo es verificador cuando la mayoría acierta. En algún punto hay un cruce donde una topología barata y no verificada supera a una verificada y cara en cualquier métrica que ignore los casos extremos; encontrarlo en una tarea real sería un desacuerdo publicable con este episodio, no un bug en tu configuración.
Qué ha cambiado
Estado de este nivel al momento de publicación, a partir de una sincronización semanal en vivo con 30 fuentes pioneras en research-anything (make watch-sync), ordenadas por señal técnica y nunca por alcance de audiencia. Cada ítem fue consultado y leído como su página de resumen en arXiv en la fecha de sincronización.
Fecha de sincronización: 2026-09-11.
- arXiv:2609.05774 (2026-09-04) — Inference-Time Graph Engineering for Multi-Agent LLM Workflows, Tieu et al. Compila una consulta y un conjunto de agentes en una secuencia de grafos de comunicación dirigidos, uno por etapa de razonamiento, cada conexión llevando una instrucción sobre qué viaja por ella. Su conclusión es la tesis de este episodio en una frase: "effective multi-agent orchestration depends not only on which agents communicate, but also on engineering executable workflow graphs that encode when, why, and how information should flow during reasoning" (Traducción: la orquestación multi-agente efectiva depende no solo de qué agentes se comunican, sino también de diseñar grafos de flujo de trabajo ejecutables que codifican cuándo, por qué y cómo debe fluir la información durante el razonamiento).
- arXiv:2608.23541 (2026-08-24) — The Interaction Tax: When Communication Erases Diversity in Multi-Agent Teams, Ann, Liu y Tan. Once tareas de optimización evaluadas por verificadores bajo presupuestos igualados; la interacción de solución completa se mide como un valor por defecto débil, y la generación de propuestas independientes evita el colapso. Es la contra-evidencia más fuerte a que este nivel exista en absoluto, y la razón por la que este artículo trata el sampling-and-voting como un grafo legítimo y no como un hombre de paja.
- arXiv:2608.21156v2 (revisado 2026-08-26) — el survey de Feng et al., la fuente que nombra este nivel y el eje central de esta serie. Su argumento para un quinto paradigma es organizacional, no cognitivo.
- arXiv:2608.12921v2 (v1 2026-08-13, v2 2026-08-14) — Discovering Efficient and Explainable Communication Topologies … via Causal Inference, Li et al. trata "qué conexiones realmente importaron" como atribución causal, midiendo cómo enmascarar cada canal cambia el resultado y luego podando las conexiones redundantes. Hace dos años la pregunta era qué agentes contratar; este es un paper sobre qué conexiones despedir.
[ABIERTA] Lo que no ha cambiado: no he encontrado nada que publique un invariante estructural tipo reachability como puerta de CI para grafos de agentes. Los papers de 2026 optimizan, explican y podan conexiones; los frameworks te dejan dibujarlas; nadie parece estar fallando una build por "un camino llega al output sin pasar por el verificador". Si esa puerta existe con otro nombre, no la he encontrado — y prefiero decirlo antes que insinuar novedad por una búsqueda superficial.
Prueba de salida
Hazte el chequeo sin hacer scroll.
- Nombra las cinco cosas que Feng et al. dicen que exceden la capacidad organizacional de un solo agente. ¿Cuántas de ellas son rasgos de personalidad?
- MAST agrupa catorce modos de fallo en tres categorías. Nómbralas y di cuál de ellas nunca puede abordar una lista de personajes.
- Anthropic reporta tanto una mejora del 90.2% como un multiplicador de tokens. ¿Cuál es ese multiplicador y qué decisión te obliga a tomar que la mejora sola no?
- ¿Por qué la proporción de caminos no verificados es la única de las tres métricas del laboratorio que pertenece en CI?
- Un sistema tiene un nodo verificador y aun así marca 0.240 donde la versión con puerta marca 0.080. ¿Cuál es el defecto, y cuál de las dos métricas — muestreada o estática — lo detecta más rápido?
- Da el argumento más fuerte de que todo este peldaño es innecesario, y el paper de 2026 que lo refuerza.
Cliffhanger
Tú dibujas el calendario.
Cada nodo con nombre, cada conexión deliberada, cada camino al output cruzando la revisión. La puerta está en CI en cero; alguien añade el atajo del domingo por la noche y la build se pone en rojo en noventa segundos, nombrando el camino. La tarta de nuez nunca llega a la mesa.
Y entonces, una semana, el nodo de revisión aprueba algo que nunca debió salir.
No porque fue saltado. Sino porque se ejecutó, leyó el estado combinado, aplicó todas las reglas que le corresponden y dijo que sí.
Miras las reglas. Todas siguen ahí. Todas siguen pasando. Y te das cuenta de que todo en esta escalera — la especificación, la despensa, el sobre, el ciclo, el calendario — ha estado tomando prestada su idea de lo correcto de un lugar que nadie ha medido jamás. Peor: en cuanto lo mides, todo río arriba empieza a optimizar para eso, incluidas las partes a las que no se lo pediste.
Episodio 6 — El Registro de Recuperación. Ingeniería de evaluación: la función de verdad que todas las demás capas toman prestada, por qué la verdadera madurez de un sistema es cómo aprende de lo que regresó roto, y el hecho incómodo de que una evaluación es un objetivo — y un objetivo puede ser manipulado por el mismo sistema que construiste para alcanzarlo.
Lee a continuación
Episodio 5 de Intelligence Engineering Adventures, Temporada 7 — La escalera de la cocina. Las afirmaciones están clasificadas por tipo — definición, derivación, evidencia, decisión de ingeniería, pregunta abierta — y una metáfora puede introducir una afirmación, pero nunca sirve como evidencia. Cada episodio incluye un notebook de Colab que se ejecuta en el nivel gratuito sin API key, más dos aplicaciones construidas desde cero: una personal y otra con enfoque empresarial. Los primeros cinco peldaños son de Feng et al. (arXiv:2608.21156), no míos; el sexto — ingeniería de evaluación — es una propuesta propia de esta serie, y el Episodio 6 la argumenta. "Qué cambió" proviene de una sincronización semanal en vivo de 30 fuentes pioneras, ordenadas por señal técnica y nunca por alcance de audiencia. Este artículo no contiene material de ningún empleador ni cliente. — Paul Jialiang Wu · futuremake.io
Referencias
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. et al. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156, v1 2026-08-21, v2 revisada 2026-08-26. — artefacto leído: la página del resumen en arXiv, 2026-09-11. Fuente de las cuatro citas en "La escalera no es mía".
- Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A. et al. (2025). Why Do Multi-Agent LLM Systems Fail? arXiv:2503.13657, v1 2025-03-17, v3 revisada 2025-10-26. — artefacto leído: la página del resumen en arXiv tal como estaba el 2026-09-11, que corresponde a la v3.Fuente de la cita de MAST, las más de 1600 trazas anotadas en 7 frameworks y kappa = 0.88. Todos los números citados provienen del abstract; los porcentajes por categoría están en el PDF y no se citan aquí.
- Anthropic (2025-06-13). How we built our multi-agent research system. anthropic.com/engineering. — artefacto consultado: la publicación en vivo, 2026-09-11.Fuente de la frase del 90.2% y de la del multiplicador de tokens 4× / 15×, ambas citadas textualmente.
- Los hitos de 2023 en la tabla histórica, cada uno leído como su página de abstract en arXiv el 2026-09-11 y descrito en vez de citado salvo donde se indica: Li, G. et al., CAMEL (arXiv:2303.17760, v1 2023-03-31); Qian, C. et al., ChatDev (arXiv:2307.07924, v1 2023-07-16); Hong, S. et al., MetaGPT (arXiv:2308.00352, v1 2023-08-01 — fuente de la cita "verify intermediate results and reduce errors" (Traducción: verificar resultados intermedios y reducir errores)); Wu, Q. et al., AutoGen (arXiv:2308.08155, v1 2023-08-16).
- Li, J., Zhang, Q., Yu, Y., Fu, Q., Ye, D. (2024). More Agents Is All You Need. arXiv:2402.05120, v1 2024-02-03. — la contra-evidencia: el muestreo y la votación escalan con el número de agentes y no requieren conexiones.
- Ann, S. E., Liu, H., Tan, C. (2026). The Interaction Tax: When Communication Erases Diversity in Multi-Agent Teams. arXiv:2608.23541, 2026-08-24. — fuente de las dos citas sobre colapso de diversidad y sobre qué determina el rendimiento.
- Tieu, K., Fu, D., Xia, Y., Li, H., Yan, H., He, J. (2026). Inference-Time Graph Engineering for Multi-Agent LLM Workflows. arXiv:2609.05774, 2026-09-04. — fuente de la cita sobre "when, why, and how information should flow" en "What moved".
- Li, J., He, P., Ji, Q., Wang, W., Liu, L., Sun, C. (2026). Discovering Efficient and Explainable Communication Topologies for LLM-based Multi-Agent Systems via Causal Inference. arXiv:2608.12921, v1 2026-08-13, v2 2026-08-14 es la versión consultada. — atribución causal y poda a nivel de conexiones; no citado.
- Herramientas y protocolo, consultado el 2026-09-11: LangChain's LangGraph (github.com/langchain-ai/langgraph), el grafo como objeto de primera clase; de Google, Announcing the Agent2Agent Protocol (A2A), 2025-04-09 (developers.googleblog.com, especificación en a2a-protocol.org).
- Hitos de la tabla de la serie para los otros escalones: Anthropic, Building Effective AI Agents, 2024-12-19 (anthropic.com/engineering); Dhage, S., Harness Engineering for Predictable Agentic Systems (arXiv:2608.26197, 2026-08-25), la métrica central del Episodio 1.
- Wu, P. J. Una opinión con diez sombreros. futuremake.io, 2026-08-06. — mi propia medición de paneles de personajes: 162 personajes en 2,410 preguntas, sin mejora frente a no usar personaje, corpus-sí-disfraz-no, y la compuerta de conformidad.
- Lab 05 y ambos proyectos, ejecutados antes de la publicación:public gist — notebook,
p1_dinner_party.py,p2_incident_room.py, ambos README y el Makefile. Todos los números de este artículo provienen de esas ejecuciones.