AIネイティブ連載 エージェントエンジニアリング比較:プロンプト・コンテキスト・ハーネス・ループ・グラフ
ハーネスエンジニアリングは「エンベロープ」であって、エージェントそのものではない
全6回シリーズの第3回。本連載はAIエージェントのエンジニアリング手法――プロンプト、コンテキスト、ハーネス、ループ、グラフ――を比較し、それぞれの起源・制御対象・推進者・測定で残る原則を整理する。今回は、エージェントが「しゃべる」段階から「手を動かす」段階へ進むターニングポイントだ。
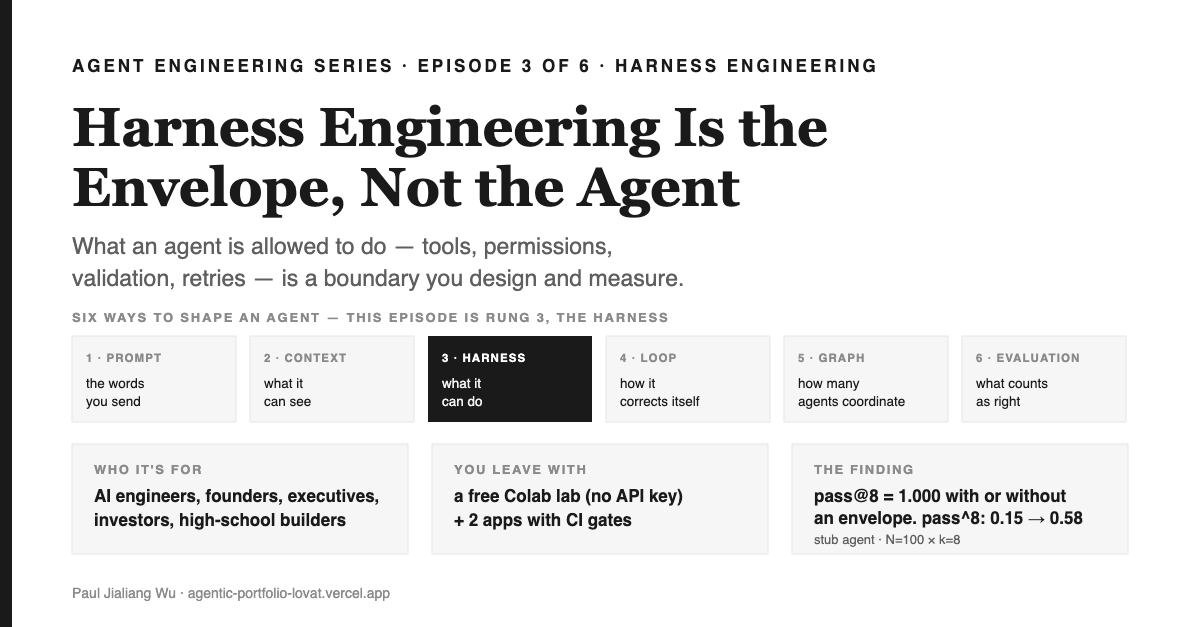
1分でつかむ要点――この記事で持ち帰れること
本記事の概要AIエージェントのエンジニアリング手法を比較する連載――プロンプトエンジニアリング(送る言葉)、コンテキストエンジニアリング(見えるもの)、ハーネスエンジニアリング(何が できるか)、ループエンジニアリング(どう自己修正するか)、グラフエンジニアリング(複数エージェントの連携)。今回はハーネスエンジニアリングを掘り下げる:2022年ReActからModel Context Protocol以降までの歩み、推進役、そして計測に耐える原則。
なぜそれが重要なのか ツールを持つエージェントは、金を動かし、ファイルを消し、顧客にメールを送り、台帳を書き換える。どこまで許すか――許可リスト、ドライラン、バリデーション、リトライ予算、キルスイッチ――を決めるのはハーネスだけだ。そして、ダッシュボードのベンチマーク値は、その制御が効いているかどうかをほとんど見抜けない。自分の実験では、pass@8が1.000を示した構成で73件の禁止ツール呼び出し(スタブエージェント、N=100のシードタスク、各タスク8回試行)が実行されていた。創業者にとってはデモと本番運用の分水嶺であり、エンジニアにとっては午後の作業とCI一行分の差だ。
この記事を読んだあとにできること 自分のエージェントのエンベロープ(制約範囲)をはっきり定義し、pass^k ではなく pass@k を計測し、枠からはみ出したアクションの数を数える。APIキー不要のColabノートブックと、ゼロから作った2つのアプリが使える:エンベロープで974件のファイル破壊を974件の拒否に変えた自宅用ファイル整理ツール、そしてエンベロープを外すとCIゲートが1で落ちる財務照合デスク――失敗を通じて、3つある安全装置のうち1つが一度もテストされていなかったことを学んだ。
Season 7 — シリーズの背骨
- プロンプトエンジニアリング——呪文ではなく仕様 第1話
- コンテキストエンジニアリング——予算で考える、ウィンドウを広げる話ではない 第2話
- ハーネスエンジニアリング――エンベロープであってエージェントそのものではない この回
- ループエンジニアリング——再試行ではなく外部の判定者 第4話
- グラフエンジニアリング —— 配役ではなくスケジュール 第5話
- 評価エンジニアリング——リーダーボードではなく「正しさ」を決める関数 第6話
この回で扱う内容と、なぜハーネスエンジニアリングが三番目なのか
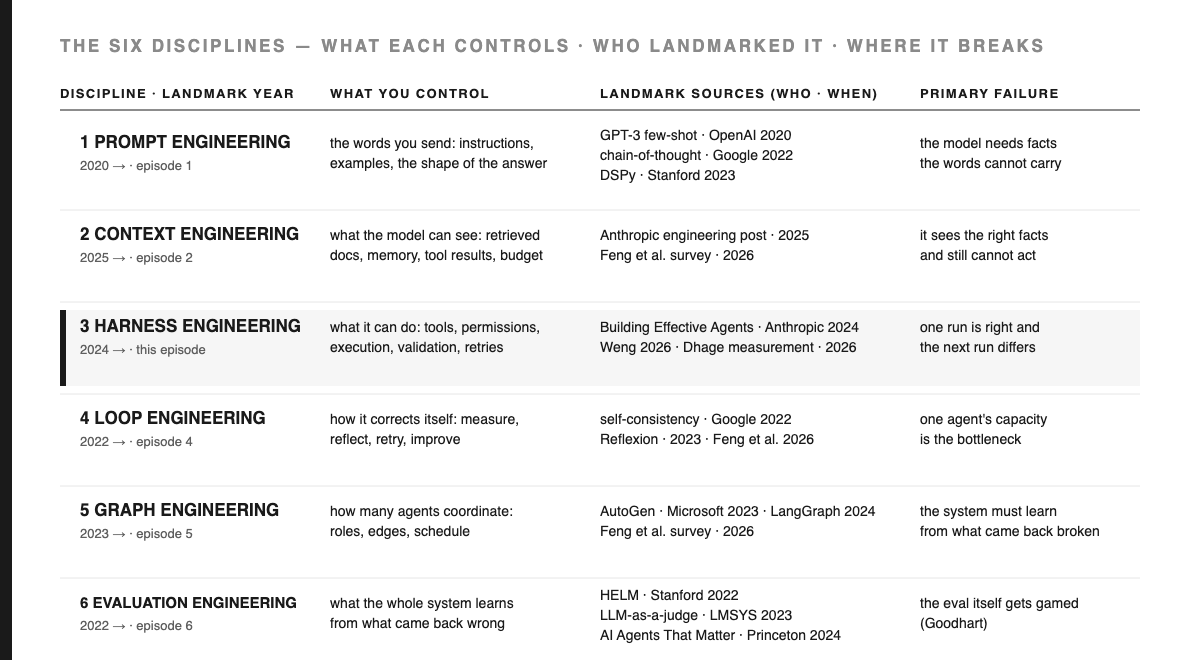
本シリーズは、AIエージェントをどう設計するかという6つの分野を、制御できる対象の順に1話ずつ掘り下げていく。どんな要素を制御できるか——プロンプト→コンテキスト→ハーネス→ループ→グラフ→評価、という順番だ。最初の5つはFengらのサーベイ(arXiv:2608.21156)で名付けられている(プロンプト、コンテキスト、ハーネス、ループ、グラフ)。6つ目の評価エンジニアリングは本シリーズ独自の追加だ。各段ごとに必ず「起源」「制御対象」「推進者」「どの失敗が次の段へ押し上げるか」の4つを問う。
ハーネスエンジニアリングは三段目。ここからリスクの質が根本的に変わる。1段目・2段目でエージェントが意図を誤解しても、せいぜい変な文章が出るだけだ。だが3段目では、アクションが問題になる。たとえばファイルの削除、二重支払い、送信済みメールなど。ここから先はこの非対称性がすべての前提になる。文章なら捨てれば済むが、アクションは取り返しがつかない。
想定読者 重要なものへの書き込み権限をエージェントに与えようとしているAIエンジニア、デモが間違った場合どうなるかをパイロット顧客から問われた創業者、自律システムの承認を求められているが何を問えばいいか分からない経営層、「AIにツールを与える」とはなぜ工学分野なのか疑問に思う高校生ビルダー。必要なのは「モデルが関数を呼ぶのを一度見たことがある」経験だけだ。
ハーネスエンジニアリングの起源と推進者
[DEF] A ハーネスとは、モデルの外側でその実行を制御するコード全体を指す。呼び出せるツールや渡せる引数、アクションがコミットされる前後の処理、失敗時の挙動、全体の停止条件まで含む。Lilian Weng(3年前に第1段の決定版サーベイ、今年7月にこの段の決定版記事を執筆)は、これを次のように定義している:"A harness is the system surrounding a base model that orchestrates execution and decides how the model thinks and plans, calls tools and acts, perceives and manages context, stores artifacts, and evaluates results."(訳:ハーネスとは、ベースモデルを取り囲み、実行を調整し、モデルがどのように思考・計画し、ツールを呼び出し・行動し、コンテキストを認識・管理し、成果物を保存し、結果を評価するかを決定するシステムである。)
この回の論点は、この定義にある「decides」という一語を文字通りに受け取ると何が起きるか、にある。歴史は「モデルがツールを使えるか」から「どのツールを、どんな条件で、どうチェックするか」へと進化してきた道筋そのものだ。
| 時期 | ランドマーク | 推進者 | 何が変わったか |
|---|---|---|---|
| 2022-10 | ReAct: Synergizing Reasoning and Acting in Language Models (arXiv:2210.03629) | Yaoら(Princeton・Google Research) | 推論の経路(トレース)とアクションを交互に組み合わせることで、"reasoning traces help the model induce, track, and update action plans as well as handle exceptions, while actions allow it to interface with external sources…"(訳:推論のトレースはモデルが行動計画を導き、追跡し、更新し、例外処理もできるようにし、アクションは外部ソースとのインターフェースを担う……)。この構造はいまも多くのエージェントフレームワークの基本ループとなっている。 |
| 2023-02 | Toolformer (arXiv:2302.04761) | Schickら(Meta AI) | "a model trained to decide which APIs to call, when to call them, what arguments to pass, and how to best incorporate the results into future token prediction"(訳:どのAPIをいつ呼び、どの引数を渡し、その結果を将来のトークン予測にどう活かすかを判断できるよう訓練されたモデル)。ツール利用はプロンプトの工夫ではなく、モデルの訓練済み能力となった。 |
| 2023-05 | Gorilla (arXiv:2305.15334) | Patilら(UC Berkeley) | 実際の大規模APIレジストリを扱い、初めてcatalogue問題を本格的に論じた:"When combined with a document retriever, Gorilla demonstrates a strong capability to adapt to test-time document changes, enabling flexible user updates or version changes."(訳:ドキュメントリトリーバーと組み合わせることで、Gorillaはテスト時のドキュメント変更に柔軟に適応し、ユーザーによる更新やバージョン変更にも対応できることを示した) |
| 2023-06 | APIでの関数呼び出し | OpenAI | ツール利用は文章解析からプロトコル上の型付きフィールドとなり、harnessにスキーマが導入された。 |
| 2024-05 | SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering (arXiv:2405.15793) | Yangら(Princeton) | 本エピソードの根幹となる発見は、モデル自体はそのままにして「インターフェース」だけを変えるとスコアが動く、というものだ。ここでエージェント・コンピューター・インターフェース(ACI)という呼び名が定着した。 |
| 2024-06 | τ-bench (arXiv:2406.12045) | Yao ら(Sierra) | を提案。pass^kエージェントを8回実行し、そのすべてで合格することを求めるベンチマークは、8回中ベストだけを見る従来の指標とは本質的に異なるものとなった。 |
| 2024-11 | Model Context Protocol | Anthropic | 発表文ではこう説明されている:"an open standard that enables developers to build secure, two-way connections between their data sources and AI-powered tools"(訳:開発者が自分のデータソースとAI搭載ツールの間に安全な双方向接続を構築できるオープン標準)。これにより、ハーネスのツール層はベンダーをまたいで持ち運べるものとなった。 |
| 2024-12 | Building Effective Agents | Anthropic(Erik Schluntz, Barry Zhang) | この段階の実務者必読のカノンであり、誰もが引用する一文がある。「エージェント・コンピューター・インターフェースには、人間向けと同じだけの労力を注げ」。 |
| 2026-07 | Harness Engineering for Self-Improvement | Lilian Weng | この分野に名前を与え、先述の定義を示した。著者一人で三段分、三年分の仕事である。 |
| 2026-08 | このラダー(arXiv:2608.21156)と決定性の研究(arXiv:2608.26197) | Feng ら、Dhage) | ハーネスエンジニアリングは、公開された体系の第3段に据えられ、そして誰も望まなかった測定結果が出た。 |
[設計] この分野の進化は、「できる」から「どう制限するか」へと向かっている。2022〜2023年は「ツールが使えるか」を問う段階だったが、2024年以降は「どのツールを、どうチェックし、失敗時にどう扱うか」が主題となる。標準化の方が測定より先に進み、MCPは2024年11月にリリース。ハーネスが本当にエージェントの信頼性を高めるかどうかの本格的な公開検証は、2026年8月が最初だった。
今この分野を動かしているのは誰か。 プロトコル層と実践者の規範はモデルラボが握っている。AnthropicのBuilding Effective AgentsやMCP、OpenAIのfunction-callingスキーマがそれだ。設計を最も強く押し進めているのはコーディングエージェント系(Claude Code, Codex)で、コーディングエージェントとは「モデル入りのハーネス」であって、その逆ではない。測定の主導権はアカデミアにあり、ACIの成果はPrinceton、pass^k.
思考の枠組み:レストランの厨房
全6回を貫くイメージがある。物語ではなく、設計ツールとしての比喩だ。料理人は「自分のために作る」「家族のために作る」「レストランの厨房で働く」「ファストフードチェーンを回す」「全国規模のサプライチェーンを担う」と段階を上がる。エンジニアも同じで、「学校の学習者」「ジュニア開発者」「シニア開発者」「AIテックリード」「CTO」「フロンティアリーダー」と成長する。それぞれのエージェントエンジニアリングの段階は、このはしごの厨房に対応する。
第1段は、会話できない料理人に渡すレシピカード。第2段は、その料理人が使うパントリー。第3段は、まさに厨房そのものだ——ここには3つの要素がある。どの持ち場にこの料理人が立てるか。どの道具が手の届く範囲にあるか、どれが引き出しにあり、どれがオフィスに鍵をかけてしまわれているか。そしてパス——すべての皿が必ず通るカウンターで、料理人以外の誰かがテーブルに届く前にチェックする場所だ。
シニア開発者の役割は、ジュニアより料理が上手いことではない。有能な他人が火事を起こさずにシフトを回せる厨房を設計し、間違った皿がテーブルに出る前にパスで止められるようにすること——つまり、自分が訓練も監督もしていない作業者のために、境界のある環境を作ることだ。それがハーネスエンジニアリングの本質である。
| 段階 | 厨房 | あなたの立場 | あなたが形作れるもの |
|---|---|---|---|
| 1. プロンプト | レシピカード──自分のための料理 | 学校で学ぶ人 | 料理人が手にする書かれた指示 |
| 2. コンテキスト | パントリー──家族のための料理 | ジュニア開発者 | 作業中にカウンターや冷蔵庫に並ぶもの |
| 3. ハーネス | レストランの厨房 | シニア開発者 | どの持ち場を担当するか、手の届く道具、そして全ての皿が必ず通るチェックポイント |
| 4. ループ | ファストフードチェーン | AIテックリード | 味見して、測って、直して、その修正を全店舗に反映する |
| 5. グラフ | 全国規模の供給網 | CTO | 複数の厨房、ひとつのスケジュール、ひとつのトラック隊 |
| 6. 評価 | リコール記録 | フロンティアリーダー | 全体のフードシステムが、戻ってきた失敗から何を学ぶか |
一軸ではなく二軸で考える。 これは「登りきったら終わり」のはしごではない。どのキッチンにも常に6層すべてが同時に存在する。家庭の料理人にも、レシピカード、パントリー、コンロ、味見、仕入れ先、そして前回の失敗の記憶がある。段を上がるごとに変わるのは、自分がどの層まで手を伸ばせるかと、各層をどれだけ厳密に運用するかだ。最初は勘、次に計測、やがてゲートを設け、最後は自己修正へ。華やかなサプライチェーン図があっても、パスでの検品がない全国チェーンは、すべての皿をチェックする一軒のレストランより未熟だ。だから6つのディシプリンはレイヤー(仕様・状態・制御エンベロープ・制御フロー・トポロジー・真理関数という異なるオブジェクト)であり、シニアリティは成熟度を指す。グラフがループより自動的に高度ということはない。
この比喩は主張の導入には使えるが、証拠にはならない。下の1:1マップで、すべての要素がコード上の何か一つに正確に対応している。
主張の分類
[DEF] ハーネスとは、制御エンベロープである。つまり、システムが取りうる行動の集合と、それぞれが合法となる条件のセットだ。フレームワークでもラッパーでもなく、あなたが引く境界線であり、エージェントの振る舞いはその内側で生きる。
[EVIDENCE] エンベロープを設計対象として扱うべき理由は、モデル自体はそのままにしてインターフェースだけを変えたときに何が起きるかが示されたからだ。YangらのSWE-agent(arXiv:2405.15793、2024-05-06)は、一度言われれば当たり前だが誰も明言していなかった観察から始まる:"we posit that LM agents represent a new category of end users with their own needs and abilities, and would benefit from specially-built interfaces to the software they use."(訳:我々は、LMエージェントが独自のニーズと能力を持つ新しいエンドユーザーのカテゴリであり、彼らが使うソフトウェアには専用に設計されたインターフェースが有益だと考える。) その結果、"SWE-agent's custom agent-computer interface (ACI) significantly enhances an agent's ability to create and edit code files, navigate entire repositories, and execute tests and other programs"(訳:SWE-agentのカスタムなエージェント-コンピュータ・インターフェース(ACI)は、エージェントがコードファイルを作成・編集し、リポジトリ全体を操作し、テストや他のプログラムを実行する能力を大幅に高める)。この成果は、モデル自体をいじらずツール設計だけを変えることで、当時最先端だったSWE-benchでpass@1率12.5%を記録した。
AnthropicによるBuilding Effective Agents(2024-12-19)は、この知見を「経験則」として定式化した:"One rule of thumb is to think about how much effort goes into human-computer interfaces (HCI), and plan to invest just as much effort in creating good agent-computer interfaces (ACI)."(訳:ヒューマン・コンピュータ・インターフェース(HCI)にどれだけ労力をかけているかを考え、同じだけの労力を優れたエージェント-コンピュータ・インターフェース(ACI)の設計にも注ぐべき、というのが経験則である)。彼らが掲げるエージェントの三原則のうち、シンプルさ・透明性に続く三つ目、かつ最後にこれが置かれている:"Carefully craft your agent-computer interface (ACI) through thorough tool documentation and testing"(訳:ツールのドキュメントとテストを徹底し、エージェント-コンピュータ・インターフェース(ACI)を丁寧に設計せよ).
[EVIDENCE] つまり、インターフェースは本当に重要だ。では、エンベロープはエージェントを信頼できるものにするのか?Dhageの研究(arXiv:2608.26197、2026-08-25)はまさにそれを検証した――有限状態制御・強制ツール選択・出力バリデーション・制限付きリトライからなる決定的な実行レイヤー、2つの合成タスク、2つのオープンウェイトモデル、4つのセル。最初のパスは、この段自身の論文が自らの基準で失敗した例だ:ハーネスは"significantly improves reproducibility in one of four model-task cells, significantly degrades it in two, and has no effect in the fourth."(訳:4つのモデル-タスクセルのうち1つでは再現性を大きく向上させたが、2つでは大きく悪化させ、残り1つには効果がなかった)
4セル中2つは悪化した。ガードレールは設置されたが、ダッシュボードは苦情を上げた。トレースレベルの診断で原因は1段上――制約のないフリーテキストの計画ステップ――にあると判明し、そこを制約したことで4セル中3つはN=100で1.000に到達した。締めの一文は、この段で恥をかいた誰かによるものだ:ハーネスエンジニアリングは確かに実在する分野だが、"but its cost is model-dependent and must be measured, not assumed."(訳:だがそのコストはモデル依存であり、測定されるべきものであって、想定で済ませてはならない)
[DESIGN] どこで分岐が起きるか、ここが最も誤って引用されやすい数値なので正確に見てほしい。論文自身の言葉:"token cost falls in every cell, but latency shows a genuine, sample-size-robust split by model -- one becomes faster under the constraint, the other markedly slower."(訳:トークンコストはすべてのセルで下がったが、レイテンシはモデルごとに明確かつサンプルサイズに頑健な分岐を示した――制約下で速くなるものもあれば、著しく遅くなるものもあった) トークンコストはすべてのセルでトークンコストは下がった。レイテンシだけがモデルごとに明確に分かれる。エンベロープは必ずしもコスト高になるわけではなく、どちらに転ぶかは設計図からは読めない。
[DERIVATION] この2つを合わせると、この回の主張になる。インターフェースはエージェントが何を達成できるかを変える(SWE-agent)。だが、エンベロープは安定して 達成できるかどうかを保証しない(Dhage)。多くの人が使う指標ではこの2つを区別できず、しばしば混同されている。
[DEF] ここで、この回が軸にする2つの言葉にたどり着く。どちらもタイプミスではなく、意味が異なる。
pass@k——k回の試行で、1回でも 成功したか?ベンチマークが報告する指標。ユーザーがリトライでき、良い答えと悪い答えを見分けられる場合にふさわしい。pass^k——k回すべてでk 成功したか?τ-benchの指標であり、顧客が実際に体験するもの。顧客は1回しか実行できず、どの回が当たったかを知ることもできない。
[EVIDENCE] Yaoらはこの差を同じ文脈で報告している:"We also propose a new metric (pass^k) to evaluate the reliability of agent behavior over multiple trials. Our experiments show that even state-of-the-art function calling agents (like gpt-4o) succeed on <50% of the tasks, and are quite inconsistent (pass^8 <25% in retail)."(訳:我々はまた、エージェントの挙動の信頼性を複数回の試行で評価する新しい指標(pass^k)を提案する。我々の実験では、最先端の関数呼び出しエージェント(gpt-4oのような)でさえ、タスクの50%未満しか成功せず、非常に一貫性に欠けている(小売業ではpass^8が25%未満)。) つまり、最先端のツール呼び出しエージェントでも半分未満のタスクしか解けず、8回連続で成功するのは4分の1未満.
1:1技術マップ
キッチンの各要素はコードの1つの構成要素に対応する。比喩は主張の導入には使えるが、証拠にはならない——ここでは飾り気なしに、その対応を示す。
| キッチン | システム | どこに存在するか |
|---|---|---|
| この料理人が担当できる持ち場 | ツールのallow-list(許可リスト) | ALLOW = {"mkdir","move","log"} — 実行前にセットに含まれているか判定 |
| オフィスに鍵をかけてしまってあるナイフ | 未許可の動詞 | UNGRANTED = {"wire_transfer","close_period",…} — 拒否され、記録され、決して実行されない |
| ソースを皿にかける前の味見 | ドライラン | dry_run(verb, src, dst) — 戻り値は (ok, reason)、何も変更しない |
| パス(pass)— 皿がテーブルに出る前のチェック | 出力バリデーション | ツールのスキーマで検証 結果、呼び出し元が見る前に |
| パスで戻された皿を作り直す | バウンデッドリトライ | for _ in range(retries + 1) — ループではなく予算 |
| 忙しい夜に同じ伝票を2回書く | 重複した副作用 | 冪等性キー:sha256(line_id|ledger_id|cents) |
| 料理長によるサービス停止 | キルスイッチ | MAX_ADJUSTMENTS_PER_RUNと被害範囲(ブラストラディウス)上限 |
| 一皿だけ捨てる | 可逆的なアクション | undoログ——undo.jsonl逆順でリプレイ |
| 食材を一つだけ捨てる食材 | 不可逆アクション | undoログではどうにもならない。許可リストだけが効く。 |
| 「200人分出したから大丈夫」 | pass@k | 少なくともk回の試行のうち1回は成功した |
| 「今夜は一度も悪い皿を出さなかった」 | pass^k | すべてのk回の試行が成功した |
予測ゲート
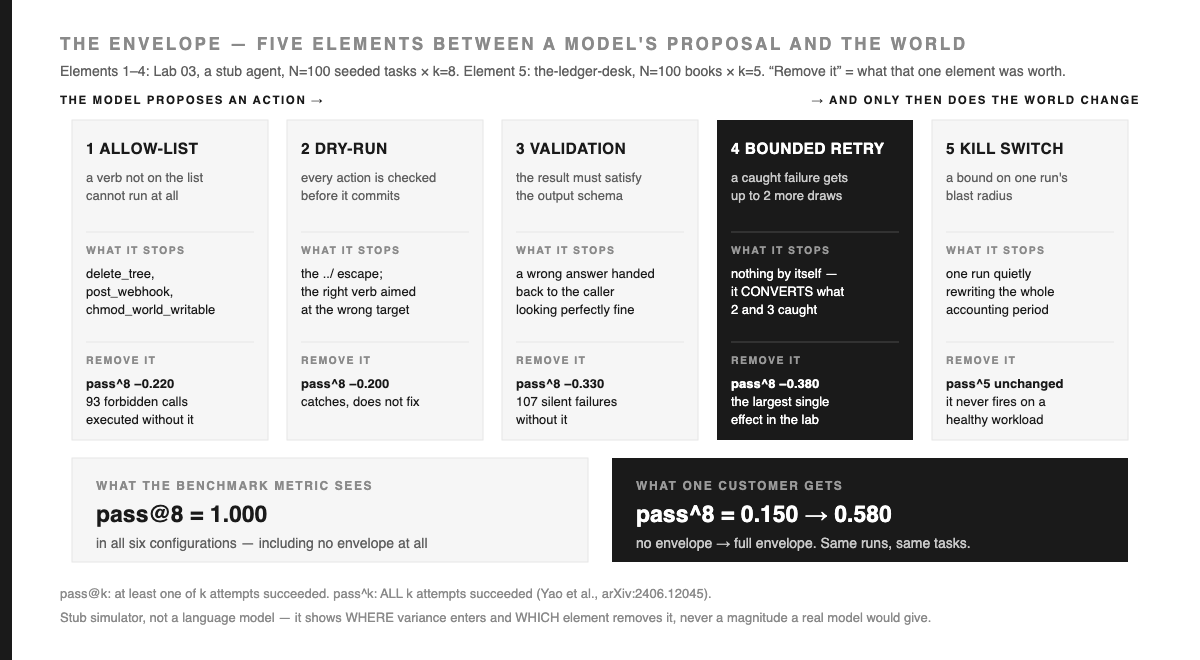
スクロールする前にコミット——記録していない予測は、正しかったと信じ込むことになる。ツールを使うエージェントには4つのエンベロープ要素がある:許可リスト、ドライラン、出力バリデーション、2回までのリトライ。100タスクを8回ずつ試行し、1要素ずつアブレーションする。
Q1.エンベロープがまったくない場合——許可リストなし、ドライランなし、バリデーションなし、リトライなし——pass@8はどうなる?
Q2. 4つの要素を「外したときの被害が大きい順」に並べよ pass^8。最もダメージが大きいものから順に。
Q3. 許可リスト・ドライラン・バリデーションがすべて無いエージェントに、バウンデッドリトライ(2回)だけを追加する——唯一の変更点はこのリトライだけだ。このとき、実際に実行される禁則ツール呼び出しの数は減るか、変わらないか、増えるか?
答えはノートブックとFailure Roomにある。
ノートブック
Lab 03 — エンベロープ: pass^k ハーネスのもとで。 
03_envelope_passk.ipynb · Colab無料枠 · APIキー不要 · CPU約5秒 · 全セル公開前に実行済み。ソースと下記2プロジェクト: gist.github.com/wjlgatech/218a4a45…
全8セル。ワーカーはシード付きスタブで、1回ごとに独立した3つのハザード(許可リスト外ツール、許可ツールの誤ターゲット、出力スキーマ不適合)が発生する。各ハザードはタスクごとの固定難易度でスケーリングされる。均一なタスクセットにすることで pass^k がきれいな p**k 減衰を示し、τ-benchのような崩壊にはならない。
[EVIDENCE] アブレーション実験、N=100タスク、k最大8、セル3の出力:
envelope                  pass@1  pass@8   pass^1  pass^5  pass^8   out-of-env  silent
none — no envelope         0.640   1.000    0.640   0.240   0.150        73       87
full minus allow-list      0.820   1.000    0.820   0.500   0.360        93        0
full minus dry-run         0.850   1.000    0.850   0.560   0.380         0        0
full minus validation      0.820   1.000    0.820   0.410   0.250         0      107
full minus retry           0.740   1.000    0.740   0.340   0.200         0        0
full envelope              0.950   1.000    0.950   0.770   0.580         0        0
Q1への答え:1.000。 すべての構成で同じ。しかも、その中には 73件の禁則ツール呼び出し と 87件の「正解のふりをした誤答」 を返したものも含まれる。pass@8 で採点すると、ラボで最も危険なエージェントが首席になる。
この行が本エピソードの主張そのものである。pass@k は飽和する。なぜなら、これが本来の役割だからだ。能力が存在するかどうかだけを測るものであり、信頼性指標だと主張したことは一度もない。 pass^8 同じ6構成を、まったく同じ実行で0.430の幅に分けて見分ける。
[EVIDENCE] Q2の答え(セル5より):retry(−0.380)、validation(−0.330)、allow-list(−0.220)、dry-run(−0.200)。retryが最も効いていたのは自分でも意外だった。4要素のうち3つは検出器 ——allow-list、dry-run、validationはいずれも異常を見つけて拒否するが、retryだけが検出結果を成功に変える。retry予算のない検出器は、日記帳につながった煙探知機のようなものだ。延々と正しいことを記録しても、誰もそれを行動に移せない。
だが、だからといってretryが一番大事というわけではない。これを外すと0.380分のpass^8と安全性ゼロを失う。allow-listを外すと0.220と93件の禁止ツール実行。損失の質が異なり、単一の順位付けスコアでは語れない。
[EVIDENCE] Q3の答え:変化なし——そしてそれこそが要点だ。 表を見ると、noneで73件、full minus allow-listで93件の禁止実行がある。これをretryの効果と読みたくなるが、この2行は3つのスイッチが違う。セル7では1つずつ切り替え、allow-listは常にオフ:
configuration                        pass@1   pass^8   out-of-env   silent
none                                  0.640    0.150           73       87
+ dry-run                             0.640    0.150           74       85
+ validation                          0.640    0.150           74        0
+ bounded retry (= no allow-list)     0.820    0.360           93        0
none + bounded retry ONLY             0.640    0.150           73       87
retry単体では何も起きない。 73→73で、pass@1も動かない。dry-runもvalidationもなければ、何も検知されないそのためループは一度も回らない。検出器が前にいないリトライ予算は、まさにデッドコードだ。「4つの要素のうち3つが検出器」という事実を、逆方向から突きつける形になり、私が描きたかったきれいなストーリーとは食い違う。
[DERIVATION] 封じ込めコストは確かに存在し、このペアに属する。2つの検出器の上にリトライを重ねると、封じ込め外の実行数は74→93、19件増(25.7%増)となる。検出器がリトライを発火させ、試行が増えるたびにロックされた引き出しに手を伸ばすことになる。だから「リトライは危険」なのではなく、検出とリトライは一体であり、そのユニットが試行回数を増幅させるのだ。 アロウリストなしで出荷すれば、1コミットで密かに封じ込めと引き換えに信頼性を買ったことになる。
[EVIDENCE] セル6、スイープ。1回の測定では測定にならない。エンベロープを固定し、ワーカーのノイズだけを変化させる:
| ノイズ | pass@1 | pass@8 | pass^5 | pass^8 | gap@8 |
|---|---|---|---|---|---|
| 0.25 | 0.990 | 1.000 | 0.950 | 0.940 | 0.060 |
| 0.50 | 0.990 | 1.000 | 0.890 | 0.850 | 0.150 |
| 1.00 | 0.950 | 1.000 | 0.770 | 0.580 | 0.420 |
| 1.50 | 0.900 | 1.000 | 0.610 | 0.420 | 0.580 |
| 2.00 | 0.800 | 1.000 | 0.440 | 0.310 | 0.690 |
pass@8 はノイズレベルがどれだけ変わっても常に1.000——ワーカーの挙動が8倍荒れても一切ブレない——一方でpass^8 は0.940→0.310まで落ちる。pass@k の数値は品質レポートではなく、パーセント記号付きのスモークテストに過ぎない。
[DESIGN] なぜスタブであってライブモデルではないのか。シミュレータなら、どこで アクションがエンベロープを外れ、どの要素が元に戻すか――数秒、無料、キー不要、各ハザード率はセル1で手動設定できる。規模感は再現しない。ここで出力されるものはτ-benchのpass^8 <25%やDhageのN=100における1.000の証拠にはならない。最後のセルが橋渡しだ:関数を本物のツール呼び出しループに差し替えても、計測コードはそのまま動く。なぜならpass_at_kとpass_pow_kは、ブール値が何によって生まれたかを知らないからだ。
失敗ルーム
わざと壊せ。壊せない仕組みは、仕組みではなく主張である。
失敗1――エンベロープは「安全」にするが、「良く」はしない。下のプロジェクト1:エンベロープは安全性 pass^5を0.000から1.000に引き上げ、完了度 pass^5はどちらも0.000のままだった。凡庸な作業者を完璧なエンベロープで囲んでも、傷つけられない凡庸な作業者ができるだけだ。持つ価値はあるが、良いエージェントとは別物――そして、権限図を品質の証拠として出すデッキは、まさにこのすり替えをやっている。
失敗2――undoログは万能ではない。可逆性は動詞の性質であって、ログの性質ではない。自作のファイル整理ツールは、すべてのコミット済み操作をundo.jsonlに記録し、逆順で再生する――エージェントが何かを削除するまでは完全な安全ストーリーだ。エンベロープを外してデモを走らせると:readings.csv、自作スタブがゴミと判定したファイルが消え、undo再生は14回の移動を律儀に逆戻しするが、何も戻らない。allow-listは不可逆動詞を守り、undoログは可逆動詞を守る。後者だけを出荷するのが、この失敗の典型だ。
失敗3――検出器+リトライのペアが被害範囲を拡大する。Q3のルール:試行回数を増やすものは、必ずそれを制限するものの内側に置く。リトライ単体では何も増やさないが、検出+リトライの組み合わせは1回の抽選を3回に増やす。allow-listが前にないと、禁止実行19回分の被害になる。解決策はリトライ回数を減らすことではなく、順序の設計だ。
失敗4――一度もテストされない安全装置。エンタープライズ向けビルドにはエンベロープ要素が3つあり、make gate-broken各要素を外してゲートが1で終了することをassertするターゲットがある。2つはゲートで落ちたが、キルスイッチは落ちなかった――健全なワークロードでは一度も発火しない。だから、どんなパスレート指標でも観測できなかった。私は失敗しようのないテストを書き、緑のチェックを眺めて、そのままリリースするところだった。修正はリポジトリにある。キルスイッチが本来対応する障害を意図的に注入し、被害半径でゲートする。失敗しないテストしか持たない安全装置は、実際にはテストされていないのと同じだ。
失敗例5 — pass@k を信頼性として報告する。 は pass^k とアウト・オブ・エンベロープのカウントを並べて報告するか、さもなくば報告しない。
プロジェクト
ゼロから作った2つのビルド。フレームワークなし、標準ライブラリのみ。どちらもこのセクション執筆前に実行済みで、すべての数字は実測値だ。どちらも 同じ公開gist にノートブックと一緒に置いてある。
プロジェクト1 — 実生活:the-desk-tidy
desk_tidy.py · python3 measure.py
散らかったフォルダをカテゴリごとに整理するファイルオーガナイザー。無人運用でも安全に動く最小限のエンベロープ:3つの動詞のアロウリスト(mkdir, move, log)、すべての移動先がフォルダ内かをチェックするドライラン、アンドゥログ。Downloadsフォルダにパーミッションポリシーを書く人はいない。だからこそ、ここで何が得られるかを体験するのが一番いい。
[EVIDENCE] N=100デスク × k=5独立試行=各500回実行:
                             ENVELOPE ON  ENVELOPE OFF
pass@5  (safe)                     1.000         0.480
pass^5  (safe)                     1.000         0.000
pass@5  (complete)                 0.480         0.480
pass^5  (complete)                 0.000         0.000
out-of-envelope deletes                0           625
actions refused                      974             0
writes outside the root                0           349
files lost (= both) 0 9742つの基準を、あえて分けている。SAFE:何も壊れず、フォルダ外への書き込みもない。COMPLETE:すべてのファイルが正しいカテゴリに収まった。
[DERIVATION] 625件の破壊的コールと349件の逸脱――この2つは別々にカウントされる。前者だけがファイルを壊し、どちらもエンベロープ外だ――エンベロープなしでは974ファイルが失われ、エンベロープありでは974アクションが拒否された。同じ数字が2度現れる。エンベロープは意思決定を一つも良くしなかった。すべての破壊的アクションを拒否に変えただけだ。それがすべてのトレードオフであり、だから complete 行は動かない。拒否の代償は未完の仕事だ。readings.csv は、いまだに机の上で未分類のまま残っている。だが、それもまたファイルである。
プロジェクト2 — 企業向け:the-ledger-desk
ledger_desk.py · make gate · make gate-broken · make gate-killswitch
突合エージェント:銀行明細と台帳を突き合わせ、差分を記帳する。エンベロープ要素は3つ、それぞれ役割がある。ツール権限 は、どの動詞が使えるか自体を決める(wire_transfer, close_period と delete_entry は存在しない)。冪等性キー — sha256(line_id|ledger_id|cents) —— これがあって初めてリトライが安全になる。そして キルスイッチ は1回の実行につき調整12回・$250までで止める役割だ。
[EVIDENCE] N=100冊 × k=5回=各行500回実行:
envelope                   pass@5   pass^5   out-of-env   dupes-land   kills
full envelope               1.000    1.000            0            0       0
minus permissions           0.960    0.080          324            0       0
minus idempotency           0.490    0.000            0          945     116
minus killswitch            1.000    1.000            0            0       0
no envelope                 0.340    0.000          324          982       0
make gate 権限ありで終了コード0、権限を外すと1、冪等性を外すと1。
[EVIDENCE] minus permissions 行はじっくり見てほしい。pass@5 = 0.960 —— あなたが責任を持ってサインできる数字 —— のすぐ隣に 324件の未許可ツール呼び出しが実行されている。さらに pass^5 の 0.080。この pass@k を一読しただけでは、5回中4回もエンベロープの外で動いているエージェントを見抜くことはできない。
このminus idempotency この行は、単一要素の除去だけでは見えない相互作用を示している。945件の重複調整が発生し、キルスイッチは116回作動した。他の要素が壊れたときに初めて、キルスイッチが表に現れる——その瞬間、不安定なツール呼び出しと会計期間の書き換えを食い止める最後の砦になる。
[OPEN] だから minus killswitch はフルエンベロープと同じ値になるし、このせいでMakefileを書き直す羽目になった。pass^k 正常なワークロードでは、異常時にしか発動しないデバイスはテストできない。make gate-killswitch そこで必要なのがこれだ——障害(冪等性オフ、リトライによる重複)を意図的に注入し、ブラスト半径でゲートする:
killswitch ON   : 116 trips · worst run 12 postings (cap 12) · 299 lines flagged → exit 0
killswitch OFF  :   0 trips · worst run 18 postings (cap 12) ·   0 lines flagged → exit 1
三つの要素のうち二つは pass^k でゲートされている。三つ目は独自の障害注入が必要で、pass^k だけではその必要性に気づけなかった。
30分で作る——契約書
エンベロープに必要なものを、エンジニアが順番に確認したくなる通りに並べる。入力: 提案された (verb, args). 出力: ひとつの Result 、もしくは理由付きの拒否。不変条件: すべてのゲートを順に通過するまで副作用は発生しない。停止ルール: 拒否は人間にエスカレーションされ、リトライ予算は 検知された 失敗にだけ消費され、拒否には使われない。
ALLOW     = {"read", "move", "log"}           # 1. the boundary. set membership.
UNGRANTED = {"delete", "wire_transfer"}       # exists in the world, not in the envelope

def act(verb, args, retries=2):
    if verb not in ALLOW:                     # 1. ALLOW-LIST — before anything else
        return refuse(verb, "not on the allow-list")
    for _ in range(retries + 1):              # 4. BOUNDED RETRY — a budget, not a loop
        ok, why = dry_run(verb, args)         # 2. DRY-RUN — nothing has touched disk
        if not ok:
            return refuse(verb, why)          #    a refusal is NOT retried
        key = idem_key(verb, args)            # 6. IDEMPOTENCY — same action, once
        if key in ledger:
            return ledger[key]
        if blast_radius() + cost(args) > CAP: # 5. KILL SWITCH — bound the run
            return halt_and_flag(verb, args)
        result = execute(verb, args)          #    the ONLY line with a side effect
        undo_log.append(inverse(verb, args))  # 7. UNDO — only helps reversible verbs
        if validate(result):                  # 3. VALIDATION — the pass
            ledger[key] = result
            return result
    return refuse(verb, "retry budget exhausted")

# CI gate (make gate): N=100 tasks x k=5 runs
#   pass^5                 >= 0.99
#   out_of_envelope_calls  == 0
#   blast radius under fault injection <= CAP
# any line below threshold -> exit 1 -> the build fails
[DESIGN] この設計がデモではなく実運用向けである理由は四つあり、それぞれに意味がある。
- 許可リストは、リトライループの外で最初にチェックする。 この順序こそが設計の肝だ。ループ内でチェックしても動作としては成立するが、外に置いてこそ「拒否された動詞が二度と選ばれない」ことが保証できる。セル7の計測がこの順序ミスの影響を示している——検出器とリトライのペアだけで許可リストなしだと、エンベロープ外の実行が74件から93件に増えた。
- 拒否は絶対にリトライされず、検知された失敗だけがリトライされる。 この2つの状態を混同すると、リトライ予算が自作の権限システムへのDoS攻撃に化ける。拒否はこのアクションは許可されていない という意味であり、検知はこの試行が不正だった.
- 冪等性キーはアクション内容から導出し、呼び出しごとに新規発行するものではない。 本番では、これはカラムの一意制約そのものが実装になる。呼び出し時に生成したUUIDは冪等性キーではなく、単なる重複の領収書だ。
- ゲートは1つではなく、3つの閾値を持つ。
pass^k信頼性のための閾値、封じ込めのためのエンベロープ外カウント、そして正常時には絶対に発火しないデバイス用のフォルト注入による被害半径チェック——この3つだ。
あえて省いているもの:並行実行(2つのrunがundoログで競合)、エスカレーション経路の裏にある人間の承認キュー、本物のモデル、本物のDB——冪等性台帳はdictで済ませている。両ビルドの正直なステータスは「実行可能かつゲート付き」であり、「本番運用・計測済み」.
同じ話でも、出口は5通りある
一本の背骨があり、読者ごとにドアが用意されている。ひとつの意思決定とひとつのアクションだけ選び、あとは置いていけ。
| あなたが | このエピソードで変わる意思決定 | 今週やるべきアクション |
|---|---|---|
| 高校生ビルダー | 「AIにツールを持たせる」とは、包丁を渡すことではなく、キッチンを設計することだ。 | Colabラボ(5秒、キー不要)を動かし、pass@k と pass^k を友人一人に説明せよ。 |
| AIエンジニアの場合 | 君が普段使っているリライアビリティ指標はおそらくpass@kで、エージェントが暴走しても1.000で頭打ちになる。 | を計算してみようpass^5。自分の管理するエージェントについて、エンベロープから逸脱したアクションの数と並べて出す。 |
| ファウンダーの場合 | パーミッション図が品質の証拠になるわけではない。エンベロープはエージェントを「安全」にするが、「優秀」にするものではない。 | チームにpass^kとエンベロープ外アクションのカウントを尋ねよ。もし誰も後者を持っていなければ、それ自体が発見だ。 |
| エグゼクティブの場合 | 自律システムについて本当に問うべきは「どのアクションが不可逆か」「それを何が制限しているか」だ。 | 次のアーキテクチャレビューには「未許可の動詞は何か」「ブラスト半径の上限はどこか」を加えよ。 |
| 投資家の場合 | どんなエージェント企業もデモは作れるが、エンベロープとそのゲートこそが簡単に真似できない部分だ。 | pass^kとpass@kを並べて聞け。どちらか一方だけなら、それは見せかけにすぎない。 |
リアリティ・ミッション
今週すでに動かしている何かで15分だけ使う。
- ツールを持たせたエージェントや自動化を一つ選べ——書く・送る・使う・消す、どれでもよい。
- そのエージェントが呼び出せる動詞をすべて書き出す——「与えたつもり」ではなく、コード上で到達可能なものすべて。この時点で大抵は何か見つかる。
- 各動詞に「可逆 または 不可逆。不可逆な動詞には許可リストが必要で、可逆なものはundoログで十分だ。多くの人はログだけを持ち、リストを持っていない。
- 代表的なタスクを5回実行し、5回すべて 成功した回数を数える。それがあなたの
pass^5だ。今まで引用してきた数字と比べてみよ。 - 安全装置を一つ見つけて、最後に作動したのはいつか尋ねよ。「一度もない」なら、その装置が必ず作動するテストを書け。
もしステップ2で、想定外の動詞が到達可能だと分かったら、そこで止まるべきだ。このエピソードの他の内容は、まだ線引きされていない境界の上に最適化を重ねるだけに過ぎない。
リサーチチャレンジ
実行前に予測を事前登録せよ——予測していなかった結果は、必ず自分に都合よく解釈することになる。
検証可能な結果と、実際にツールを使うエージェントタスクを一つ選ぶ。pass@kとpass^kをk∈{1,3,5,8}、N≥100の固定設定で測定し、さらに宣言した許可リスト外アクションの回数も数える。その後、envelope要素(allow-list、dry-run、output validation、bounded retry)を一つずつランダムな順で除去し、それぞれがpass^kおよびenvelope外アクション数に与える限界効果を個別に報告する。2つのモデルで繰り返すこと。
事前登録: の効果を最も多く担う要素と、containment効果を最も多く担う要素が同じかどうか、またその順序が2モデル間で安定しているかどうか。pass^k
私のスタブの答え:それらは異なる要素だ——reliabilityはretryが、containmentはallow-listが担う。Dhageの論文が、その順序がモデルごとに変わる理由である。実システムで両方を一つの要素が担っていたら、私の結果よりずっと面白い。
何が動いたか
この段の現状(執筆時点)は、30の先駆的な情報源を毎週ライブで同期し、research-anything (make watch-sync技術的なシグナルで順位付けし、リーチ数では決して並べていない。同期日:2026年9月11日。 すべて実際に取得したもので、フィードタイトルの要約ではない。
- MCP新ロードマップ(2026-08-22)— メンテナーチームが公開:"an updated roadmap for the Model Context Protocol (MCP), covering the next specification release and beyond"(訳:Model Context Protocol(MCP)の次期仕様リリース以降を含む、最新のロードマップ)。エンタープライズ向けのセキュリティ強化やプリミティブの改良などが盛り込まれている。ハーネスのツール層は、単なる機能追加ではなく標準として管理される段階に入った。
- arXiv:2608.27443 (2026-08-27) — ユーザー自身が作成した許可ポリシーはAIエージェントの越権行為を防げるか(Ting Yan)。エンジニア以外の参加者113名が、7件の越権行為を含む18アクションのシミュレーションを3条件で監督した。ポリシーベースのエージェントガバナンスを推す人には厳しい結果:"POLICY blocked less overreach than HITL (-20.1 percentage points, 95% CI [-32.1, -8.1])"(訳:ポリシーはHITLよりも越権行為を20.1ポイント(95%信頼区間[-32.1, -8.1])少なくしか防げなかった)。自作の許可ポリシーを書くのは、個別承認より難しい——これに関する初の定量データである。
- arXiv:2609.00829 (2026-09-01) — HarnessEvolve: 参照軌跡から学ぶ信頼性の高いエージェント自己進化(Jiang, W. ほか)。ハーネスそのものを最適化対象とみなすところから始まる:"Self-evolving agents advance toward autonomy by optimizing their harness---prompts, skills, tools, and execution logic---based on environmental feedback."(訳:自己進化型エージェントは、環境からのフィードバックをもとに、プロンプト・スキル・ツール・実行ロジックを含むハーネス全体を最適化しながら自律性を高めていく)。第3段(ハーネス)が第4段(ループ)にバトンを渡す——これがエピソード4の主題だ。
- ウィンドウの直外、かつ本論に直結:arXiv:2608.14711, Beyond Pass@k: エージェント型コード生成の信頼性とセキュリティ測定(2026-08-11——このセクションの締切1日前なのでここに記載)。
- やや古いが基盤となるもの:arXiv:2405.15793(SWE-agent、ACIの結果)、arXiv:2406.12045(τ-bench、
pass^k)、そしてLilian WengのHarness Engineering for Self-Improvement(2026-07-04)。この段階の定義として、今も最も明快な一文だ。
[OPEN] 変わらないもの:arXiv:2608.26197の追試は現時点でなく、実エージェントでpass^kとアウト・オブ・エンベロープのアクション数を同時に報告した公開研究も見つからなかった——まさに本エピソードが求めている測定であり、私のスタブでは形だけしか示せないものだ。もしご存知なら、ぜひ公に指摘してほしい。
セルフチェック
上まで戻らず、自分で答えてみてほしい。
- と
pass@kを定義し、どちらが顧客の体験に該当するか説明せよ。pass^kエンベロープの構成要素5つを挙げ、そのうちどれが検出器か3つ答えよ。 - リトライだけを追加しても何も変わらなかった。リトライが禁止コール数を増やすには何が必要で、その理由は何か?
- エージェントが
- を記録した場合、それで分かること2つ・分からないこと2つを挙げよ。
pass@8 = 1.000なぜ - ではキルスイッチのテストができず、何がその代わりになったのか?
make gate-broken次回予告
エンベロープを描くのはあなた自身だ。
許可リストに載せた動詞だけ。コミット前に宛先をすべて確認し、パスで結果をバリデート。リトライはループではなく予算、キルスイッチには上限値。ゲートは
1.000、アウト・オブ・エンベロープは0。たった一晩、あなたはキッチンを制した気になる。pass^5そしてふと
complete あの「動かなかった」行――そこで、エンベロープでは本質的に解決できない問題があることに気づく。
パスで弾かれて戻ってきた皿には、必ず理由がある。しかし誰もそれを書き残さない。同じミスが同じ持ち場で毎回起き、毎回見つかり、毎回作り直される。今夜と先週の火曜の違いは、材料費を二度払ったことだけだ。
不良品をすべてキャッチしても、なぜそうなったかを学ばない厨房は進歩しない。食材を無駄にするだけは一流だ。
第4回 ループエンジニアリング 一度目は正解、次は違う――その修正はリトライではなく、料理人の部下ではない「審判」が必要だ。
次に読む
第3回 インテリジェンス・エンジニアリング・アドベンチャーズ シーズン7 キッチンラダー編。シリーズの主張は「定義」「導出」「証拠」「設計判断」「オープンクエスチョン」でタグ付けされている。比喩は主張の導入には使えるが、証拠には決してならない。各回にColabノートブック(無料・APIキー不要)と、ゼロから作ったアプリ2本(個人用・エンタープライズ型)が付く。5段ラダーはFengら(arXiv:2608.21156)、6段目の評価エンジニアリングは筆者独自。「what moved」セクションは30の先端ソースを毎週ライブ同期し、技術的な信号のみで順位付けしている(リーチは考慮しない)。本記事には雇用主やクライアント由来の素材は一切含まれない。――Paul Jialiang Wu · futuremake.io
参考文献
- Yang, J., Jimenez, C. E., Wettig, A., Lieret, K., Yao, S., Narasimhan, K., Press, O. (2024). SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. arXiv:2405.15793(2024-05-06投稿)――証拠読取:arXivアブストラクトページ。ACI引用2件とSWE-benchのpass@1率12.5%の出典。
- Yao, S., Shinn, N., Razavi, P., Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv:2406.12045、2024-06-17提出。— アーティファクト確認:arXivアブストラクトページ。出典:
pass^kおよび引用された「<50% / pass^8 <25%」の数値。 - Anthropic — Schluntz, E., Zhang, B. (2024-12-19)。Building Effective Agents. anthropic.com/engineering。— アーティファクト確認:2026-09-11取得のライブエンジニアリング投稿。HCI/ACIの経験則および三つ目のコア原則の出典。
- Dhage, S. (2026)。Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197、2026-08-25提出。— アーティファクト確認:arXivアブストラクトページ。1-of-4 / 2-of-4の初回結果、トークンコストとレイテンシの分岐、締めの「measured, not assumed(訳:測定されるべきで、想定してはならない)」の出典。
- Weng, L. (2026-07-04)。Harness Engineering for Self-Improvement. lilianweng.github.io。— アーティファクト確認:ライブ投稿。harness定義全文の出典。
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. ほか (2026)。Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2、2026-08-26改訂。— アーティファクト確認:arXivアブストラクトページ。ラダーの公表文、および"Harness Engineering to organize external tools and resources"(訳:外部ツールやリソースを整理するためのハーネスエンジニアリング).
- Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., Cao, Y. (2022)。ReAct: Synergizing Reasoning and Acting in Language Models. arXiv:2210.03629、2022-10-06提出。— アーティファクト確認:arXivアブストラクトページ。
- Schick, T., Dwivedi-Yu, J., Dessì, R. ほか (2023)。Toolformer: Language Models Can Teach Themselves to Use Tools. arXiv:2302.04761(2023-02-09提出、arXivアブストラクトページ実読)
- Patil, S. G., Zhang, T., Wang, X., Gonzalez, J. E. (2023)。Gorilla: Large Language Model Connected with Massive APIs. arXiv:2305.15334(2023-05-24提出、arXivアブストラクトページ実読)
- OpenAI (2023-06-13)。Function calling and other API updates. openai.com(記述のみ、引用はなし)
- Anthropic (2024-11-25)。Introducing the Model Context Protocol. anthropic.com/news(ライブ発表を実読、引用定義の出典。現行仕様ドキュメント:modelcontextprotocol.io ※日付なしドキュメントホーム。仕様の出典として引用、日付目的ではない)
- Model Context Protocol maintainers (2026-08-22)。The New MCP Roadmap. blog.modelcontextprotocol.io(ライブ投稿を実読)
- Yan, T. (2026)。Do User-Authored Permission Policies Improve Protection Against AI Agent Overreach? arXiv:2608.27443、2026年8月27日投稿。— arXivアブストラクトページを直接確認、引用された−20.1パーセントポイントの出典。
- Jiang, W., Chu, M., Tian, Y. 他(2026年)。HarnessEvolve: Learning from Reference Trajectories for Reliable Agent Self-Evolution. arXiv:2609.00829、2026年9月1日投稿。— arXivアブストラクトページを直接確認。
- Jiang, Jiajun, Zheng, S., Vidra, N., Setty, S.(2026年)。Beyond Pass@k: Measuring Reliability and Security of Agentic Code Generation. arXiv:2608.14711、2026年8月11日投稿。—「What moved」セクションでウィンドウ直外として掲載。
- Jimenez, C. E., Yang, J. 他(2023年)。SWE-bench: Can Language Models Resolve Real-World GitHub Issues? arXiv:2310.06770。— pass@1=12.5%のベンチマークとして引用。
- Lab 03および両プロジェクト、この記事中のすべての数値はここから再現できる:gist.github.com/wjlgatech/218a4a45533812ebe0b3f0e577dd6be7.
- Intelligence Engineering Adventures シーズン6 — The Governor Engine(エピソード1・3)。ネスティング図が現場で破綻すること、そしてここで使われるどのラベルも安定性を表現できないという議論のため。