Serie AI-Native · Ingeniería de Agentes, comparada: Prompt · Contexto · Harness · Bucle · Grafo
La ingeniería de bucles es un árbitro externo, no un reintento
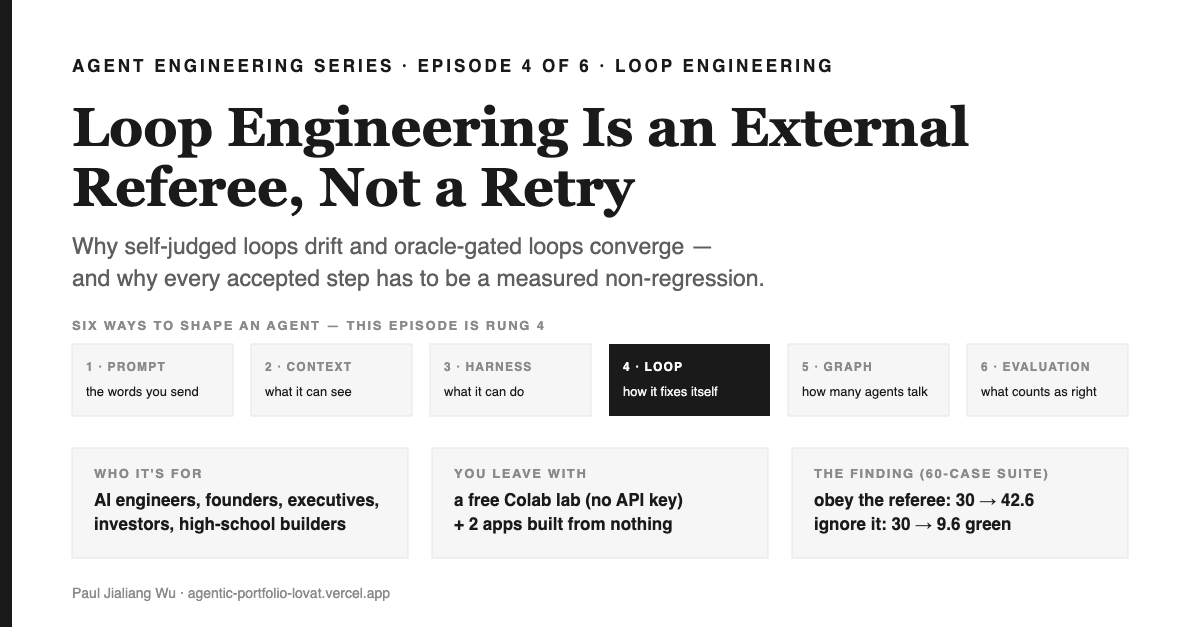
Episodio 4 de 6. Esta serie compara las formas en que se diseña un agente de IA — ingeniería de prompts, de contexto, de harness, de bucles y de grafos: de dónde viene cada una, qué controla y qué principios sobreviven a la medición. Este episodio es el peldaño donde un sistema se corrige a sí mismo, y de dónde debe venir esa corrección.
Resumen en 1 minuto — lo esencial
Qué es esto. Una serie comparativa sobre las formas de diseñar un agente de IA — ingeniería de prompts (las palabras que envías), ingeniería de contexto (lo que puede ver), ingeniería de harness (lo que puede hacer), ingeniería de bucles (cómo se corrige a sí mismo) e ingeniería de grafos (cuántos agentes coordinan). Este episodio trata sobre la ingeniería de bucles: su historia de 2022 a 2026, quién la impulsa y la única regla de diseño que decide si un bucle converge o se desvía.
Por qué importa. Todo el mundo está implementando agentes que corrigen sus propios errores, y un bucle que califica su propio trabajo no mejora: simplemente se vuelve más seguro de sí mismo. El resultado publicado es tajante: sin retroalimentación externa, los modelos tienen dificultades para corregirse en razonamiento y pueden empeorar. En mi propio experimento, el mismo bucle de reparación sobre el mismo servicio roto pasa de 42.6 de 60 pruebas en verde cuando obedece a un evaluador externo, a solo 9.6 cuando no lo hace — peor que el bug que fue a arreglar, reportando progreso todo el tiempo. Para un fundador, eso es la diferencia entre un producto que mejora en el campo y uno que se degrada ahí mismo. Para un ingeniero, es una sola línea en CI.
Qué puedes hacer después de leerlo. Encuentra el bucle que ya tienes funcionando, pregunta quién lo califica y mueve ese evaluador fuera de lo que está siendo evaluado. Obtienes un notebook de Colab gratis (sin API key, solo stdlib) que mide la deriva en veinte ejecuciones con semilla, más dos aplicaciones construidas desde cero: un refinador de planes de estudio donde cero de 413 pasos aceptados bajaron la puntuación externa, y un bucle de reparación que make gate termina en 1 en cuanto le quitas el rollback.
Season 7 — la espina de la serie
- Ingeniería de prompts — una especificación, no un hechizo episodio 1
- Ingeniería de contexto — un presupuesto, no una ventana más grande episodio 2
- Ingeniería de harness — el envelope, no el agente episodio 3
- Ingeniería de bucles — un árbitro externo, no un reintento este episodio
- Ingeniería de grafos — una agenda, no un elenco de personajes episodio 5
- Ingeniería de evaluación — la función de verdad, no un leaderboard episodio 6
Qué cubre este episodio y por qué la ingeniería de bucles es la cuarta
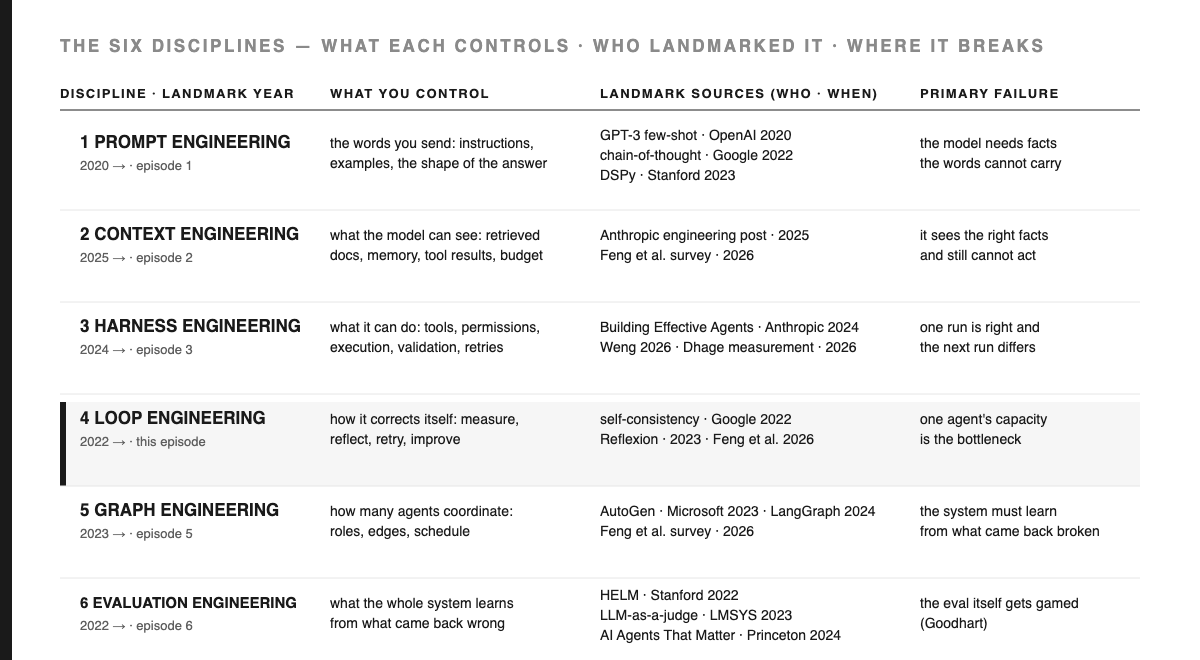
Esta serie toma un peldaño por episodio, en el orden que marca una revisión publicada: prompt → contexto → harness → bucle → grafo, más el sexto que esta temporada defiende. La ingeniería de bucles es el cuarto peldaño: donde el sistema mira lo que produjo, decide que no fue suficiente y lo intenta de nuevo. Todo lo anterior moldea un solo intento; este es el primer peldaño que invierte más de uno.
Una sola pregunta decide si ese esfuerzo vale la pena: ¿quién dice que el segundo intento fue mejor que el primero? Suena a detalle. Es toda la disciplina. Un bucle con un buen generador y un mal árbitro no se queda quieto: avanza con confianza en la dirección equivocada, y el número que reporta sube todo el tiempo.
De dónde vino la ingeniería de bucles y quién la impulsa
[DEF] Un bucle es un controlador con tres pasos: generar un candidato, evaluarlo, decidir si conservarlo. La ingeniería de bucles consiste en diseñar esos tres pasos para que, al repetirlos, el resultado realmente mejore y no solo sea distinto. Todo el argumento de este episodio gira en torno al segundo paso.
| Cuándo | Hito | Quién | Qué cambió |
|---|---|---|---|
| 2022-03 | Autoconsistencia (arXiv:2203.11171) | Wang, Wei, Schuurmans, Le, Chi, Narang, Chowdhery, Zhou | Se generan múltiples trayectorias de razonamiento y se conserva la respuesta en la que más coinciden. Es el primer bucle que surge de un prompt — y no tiene retroalimentación alguna, solo una votación. |
| 2022-03 | STaR (arXiv:2203.14465) | Zelikman, Wu, Mu, Goodman | El bucle genera sus propios datos de entrenamiento y solo conserva aquello que llegó a la respuesta correcta. El filtro es una etiqueta externa, y el artículo deja claro que las respuestas incorrectas se vuelven a intentar, ahora con la respuesta correcta como referencia. |
| 2023-03 | Reflexion (arXiv:2303.11366) | Shinn, Cassano, Berman, Gopinath, Narasimhan, Yao | Aprendizaje por refuerzo sin actualizaciones de pesos: el agente escribe su lección en un búfer de memoria episódica y la consulta en la siguiente prueba. 91% pass@1 en HumanEval frente a un baseline del 80%. |
| 2023-03 | Self-Refine (arXiv:2303.17651) | Madaan, Tandon, Gupta et al. | Un solo modelo actúa como generador, refinador y proveedor de retroalimentación, sin ningún entrenamiento. ~20% de mejora absoluta promedio en 7 tareas: el caso publicado más sólido de que un modelo puede evaluarse y corregirse de forma útil a sí mismo. |
| 2023-10 | Cannot Self-Correct Reasoning Yet (arXiv:2310.01798) | Huang, Chen, Mishra, Zheng, Yu, Song, Zhou | El contrapeso, y el artículo que centra este episodio: si eliminas la retroalimentación externa, la autocorrección en razonamiento no solo deja de ayudar, sino que puede empeorar el desempeño. |
| 2023-12 | FunSearch (Nature, doi:10.1038/s41586-023-06924-6) | Romera-Paredes et al., Google DeepMind | Un modelo de lenguaje emparejado con un evaluador sistemático descubre nuevas matemáticas. El bucle es tradicional; el árbitro externo es lo que permitió publicarlo en Nature. |
| 2024-12 | Building Effective Agents (anthropic.com/engineering) | Anthropic | El canon de la práctica reconoce el patrón evaluador–optimizador como un flujo de trabajo propio, y coloca al evaluador en una llamada aparte. |
| 2025-05 | AlphaEvolve (deepmind.google) | AlphaEvolve team, Google DeepMind | La misma estructura, pero a escala industrial: un bucle evolutivo donde los evaluadores automáticos —no el modelo— deciden qué sobrevive. Uno de sus resultados lleva más de un año en producción. |
| 2026-07 | SEAL (arXiv:2607.24300) | Guo, Cao, Yuan, Wang, Wang, Wang | Nombra y mide el fallo de forma directa: la brecha entre la verificación autoescrita por el agente y una auditoría sellada que este no puede consultar. |
| 2026-08 | La escalera (arXiv:2608.21156v2) | Feng, Xiang, Yang, Ma | La ingeniería de bucles se ubica como el cuarto peldaño de cinco, definido por su propósito y no por el framework que lo implemente. |
[DISEÑO] Dos cosas a notar. El primer bucle de la tabla — self-consistency, 2022 — no contiene ningún tipo de retroalimentación: toma una votación, lo cual debería hacerte sospechar de cualquier afirmación posterior de que el crítico es quien hace el trabajo. Y los dos sistemas que demostraron haber encontrado algo que los humanos no sabían, FunSearch y AlphaEvolve, ambos describen al evaluador como la pieza clave, sin que nadie se los pidiera.
¿Quién lo impulsa hoy? Google DeepMind lidera la frontera — self-consistency, la crítica a la autocorrección, FunSearch y AlphaEvolve llevan autores de DeepMind — y el canon práctico proviene de los blogs de ingeniería de los laboratorios. El trabajo más útil de 2026 plantea la pregunta menos glamurosa: no "¿puede un agente mejorarse solo?" sino "¿qué impide que empeore silenciosamente?"
El modelo mental: la cadena de comida rápida
El cuarto peldaño de la escalera de la cocina es la cadena de comida rápida, y aparece un verbo nuevo: corregir. Aquí no cocinas. Tienes cuatrocientas sucursales y lo que realmente posees es el ciclo: probar, medir, corregir y desplegar la solución. Nunca probarás la mayoría de la comida que produce tu empresa, así que tu trabajo es decidir qué significa realmente "la hamburguesa mejoró" y lograr que ese criterio llegue a cada freidora.
Este es el fracaso que toda cadena ha vivido. Le pides a los gerentes que califiquen sus propias sucursales. Las calificaciones regresan excelentes, y siguen regresando excelentes, trimestre tras trimestre, mientras la fila en la puerta se acorta. Los gerentes no mienten; su rúbrica fue creada por la misma cabeza que diseñó la hamburguesa, así que lo que tendría que notar el problema es lo que lo tiene. Una cadena real manda a un extraño — un cliente incógnito, un termómetro en el aceite de la freidora — instrumentos con los que la tienda no puede discutir, no puede editar, no diseñó. La palabra para ese extraño es un verificador externo.
Y luego está el adorno: el elemento que sube la calificación interna y baja la calidad real del producto — la salsa extra que se ve hermosa en la foto y hace que la caja gotee. Nadie está haciendo trampa; la métrica lo recompensa. Aparece tres veces, y al final resulta que ese era el punto.
| Peldaño | Cocina | Quién eres | Lo que te permite moldear |
|---|---|---|---|
| 1. prompt | la tarjeta de recetas — cocinar solo para ti | alumno de escuela | las instrucciones escritas que sigue el cocinero |
| 2. context | la despensa — cocinar para la familia | desarrollador junior | lo que hay sobre la mesa mientras se cocina |
| 3. harness | la cocina del restaurante | desarrollador senior | las estaciones, las herramientas a la mano, la barra de pase |
| 4. loop | la cadena de comida rápida | líder técnico de IA | probar, medir, corregir y aplicar la mejora en cada sucursal |
| 5. graph | la red nacional de suministro | CTO | muchas cocinas, un solo horario, una sola flota de camiones |
| 6. evaluation | el registro de devoluciones | líder de frontera | lo que aprende todo el sistema alimentario de lo que salió mal |
Dos ejes, no uno. Si interpretas esa tabla como una escalera que subes y luego dejas atrás, caes en el error de categoría contra el que esta temporada insiste en advertir. Toda cocina tiene las seis capas a la vez. Lo que cambia al subir es cuántas capas puedes tocar y con qué rigor ejecutas cada una: primero a ojo, luego medida, luego con compuerta, luego autocorregida. Las disciplinas son capas (una especificación, un estado, un entorno de control, un flujo de control, una topología, una función de verdad); la antigüedad es madurez. Una cadena de suministro con un diagrama logístico precioso pero sin termómetro es menos madura que un restaurante que pesa cada plato. Graph no está por encima de loop. Un bucle con compuerta vence siempre a un graph decorativo, y este episodio trata de lo que cuesta realmente “poner compuerta”. La analogía puede introducir una afirmación, pero nunca la prueba: cada elemento está anclado a una cosa concreta en código en el mapa de abajo.
La escalera no es invención mía
[DEF] El vocabulario, anclado a su fuente. La declaración publicada más clara del conjunto es la revisión de Feng et al. (arXiv:2608.21156v2, revisado 2026-08-26), que nombra cuatro peldaños y luego argumenta por un quinto. La ingeniería de bucles es el cuarto, y la frase exacta de la propia revisión sobre para qué sirve merece citarse tal cual:
"Prompt Engineering to elicit model capabilities, Context Engineering to manage information access, Harness Engineering to organize external tools and resources, and Loop Engineering to support continual reflection and self-improvement" (Traducción: Ingeniería de prompts para extraer capacidades del modelo, ingeniería de contexto para gestionar el acceso a la información, ingeniería de harness para organizar herramientas y recursos externos, e ingeniería de bucles para fomentar la reflexión continua y la auto-mejora)
— Feng, Xiang, Yang & Ma, arXiv:2608.21156v2
[DISEÑO] Observa los dos silencios. Dice que un bucle es para la reflexión continua y auto-mejora; no dice quién realiza la reflexión, ni qué convierte una mejora en mejora. Todos los fallos de este episodio viven en ese hueco. La revisión luego argumenta que un solo agente eventualmente topa con un techo — "exceeding any single agent's organizational capacity" (Traducción: superando la capacidad organizativa de cualquier agente individual) — que es la puerta de entrada al Episodio 5.
La afirmación, clasificada
[DEF] Un bucle solo mejora cuando el evaluador está fuera del generador. “Fuera” tiene una prueba: el generador no puede escribirlo, no puede editarlo, no puede ver los casos sobre los que será evaluado, y no puede subir su propia puntuación por ningún medio que no sea mejorar.
[EVIDENCIA] La literatura hizo este experimento en ambos sentidos, y los dos resultados solo parecen una contradicción hasta que miras de dónde venía la retroalimentación. Empieza por el negativo. Huang et al. (arXiv:2310.01798, la versión marcada ICLR 2024) examinaron lo que llaman autocorrección intrínseca, definido en la página del resumen como el caso "whereby an LLM attempts to correct its initial responses based solely on its inherent capabilities, without the crutch of external feedback." (Traducción: “cuando un LLM intenta corregir sus respuestas iniciales basándose únicamente en sus capacidades inherentes, sin el apoyo de retroalimentación externa.”) Su conclusión:
"In the context of reasoning, our research indicates that LLMs struggle to self-correct their responses without external feedback, and at times, their performance even degrades after self-correction." (Traducción: “En el contexto del razonamiento, nuestra investigación indica que los LLMs tienen dificultades para autocorregir sus respuestas sin retroalimentación externa, y a veces, su desempeño incluso empeora después de la autocorrección.”)
— Huang et al., arXiv:2310.01798 (ICLR 2024)
El matiz es todo el artículo: sin retroalimentación externa. Esto no significa "la autocorrección no funciona"; se trata de la configuración en la que le pides al modelo que revise su propia respuesta y te dice que está bien.
[EVIDENCIA] Ahora los resultados positivos. Reflexion (arXiv:2303.11366) reporta agentes que "verbally reflect on task feedback signals, then maintain their own reflective text in an episodic memory buffer to induce better decision-making in subsequent trials" (Traducción: “reflexionan verbalmente sobre las señales de retroalimentación de la tarea y luego mantienen su propio texto reflexivo en un búfer de memoria episódica para inducir una mejor toma de decisiones en pruebas posteriores.”), logrando "a 91% pass@1 accuracy on the HumanEval coding benchmark, surpassing the previous state-of-the-art GPT-4 that achieves 80%." (Traducción: “un 91% de precisión pass@1 en el benchmark de codificación HumanEval, superando el anterior estado del arte de GPT-4 que logra 80%.”) Once puntos en un benchmark real no son ruido.
¿Entonces cuál es la diferencia? La respuesta está en la primera frase del propio Reflexion: los entornos que menciona son "games, compilers, APIs". Un compilador no es una opinión. El resumen sí permite señales tanto externas como simuladas internamente — retroalimentación de "(external or internally simulated)" fuentes — pero el resultado principal que reporta, 91% en HumanEval, es el caso externo, porque HumanEval incluye pruebas unitarias.La reflexión es verbal. La señal es una máquina diciendo aprobado o reprobado. Reflexion es un modelo que anota lo que un árbitro externo le dijo, en una forma que puede consultar la próxima vez.
[EVIDENCIA] Self-Refine (arXiv:2303.17651) es el caso más difícil y no lo voy a suavizar. "uses a single LLM as the generator, refiner, and feedback provider" (Traducción: utiliza un solo LLM como generador, refinador y proveedor de retroalimentación), sin ninguna señal externa, "improving by ~20% absolute on average in task performance" (Traducción: mejorando en promedio ~20% absoluto en el desempeño de tareas) en siete tareas. Un bucle autoevaluado que sí funcionó.
[DERIVATION] La clave para reconciliar ambos resultados es una regla práctica. Las siete tareas de Self-Refine cubren, en palabras del propio resumen, "from dialog response generation to mathematical reasoning" (Traducción: desde la generación de respuestas en diálogos hasta el razonamiento matemático); en la página del proyecto se listan como reescritura de reseñas, generación de acrónimos, generación de historias, reescritura de código, generación de respuestas, generación condicionada y eliminación de toxicidad, además de un análisis aparte sobre inversión de sentimiento, razonamiento matemático y optimización de código. La mayoría de ese conjunto está definida por preferencias, donde quien califica y quien recibe la salida son la misma población, y el juicio está cerca de la verdad por definición. El caso de Huang et al. es puro razonamiento, donde sí hay un hecho objetivo y se le pide a la misma facultad que produjo la respuesta errónea que la detecte. Cuando la verdad es una preferencia, el propio juicio del modelo es un árbitro legítimo aunque sesgado. Cuando hay un hecho objetivo sobre el que el modelo puede equivocarse —¿es válida esta demostración?, ¿corre este código?, ¿esta regla enruta correctamente el ticket?— la autoevaluación está correlacionada con el error que debería detectar, y el bucle lo empeora. Casi todo para lo que se despliega un agente cae en la segunda categoría.
[OPEN] El límite honesto: el conjunto de Self-Refine incluye una tarea de razonamiento matemático y el artículo reporta un ~20% de mejora promedio en las siete. No pude obtener el desglose por tarea, así que esto es una lectura de dos conjuntos de tareas, no una descomposición medida de la ganancia de Self-Refine.
[EVIDENCE] La confirmación más sólida no es un artículo crítico, sino los dos sistemas que usaron bucles para descubrir cosas nuevas. FunSearch (Nature, 2023) es "an evolutionary procedure based on pairing a pretrained LLM with a systematic evaluator" (Traducción: un procedimiento evolutivo basado en emparejar un LLM preentrenado con un evaluador sistemático), y descubrió nuevas construcciones de conjuntos cap. AlphaEvolve, dos años después, "pairs the creative problem-solving capabilities of our Gemini models with automated evaluators that verify answers, and uses an evolutionary framework to improve upon the most promising ideas." (Traducción: combina las capacidades creativas de resolución de problemas de nuestros modelos Gemini con evaluadores automáticos que verifican las respuestas, y utiliza un marco evolutivo para mejorar las ideas más prometedoras) Sus resultados están en producción: un algoritmo que "continuously recovers, on average, 0.7% of Google's worldwide compute resources" (Traducción: recupera continuamente, en promedio, el 0.7% de los recursos de cómputo globales de Google), y una multiplicación de matrices complejas 4×4 en 48 multiplicaciones escalares, mejorando el resultado de Strassen de 1969. Ningún equipo presentó al modelo como el motor de mejora. El modelo propone; el evaluador decide.
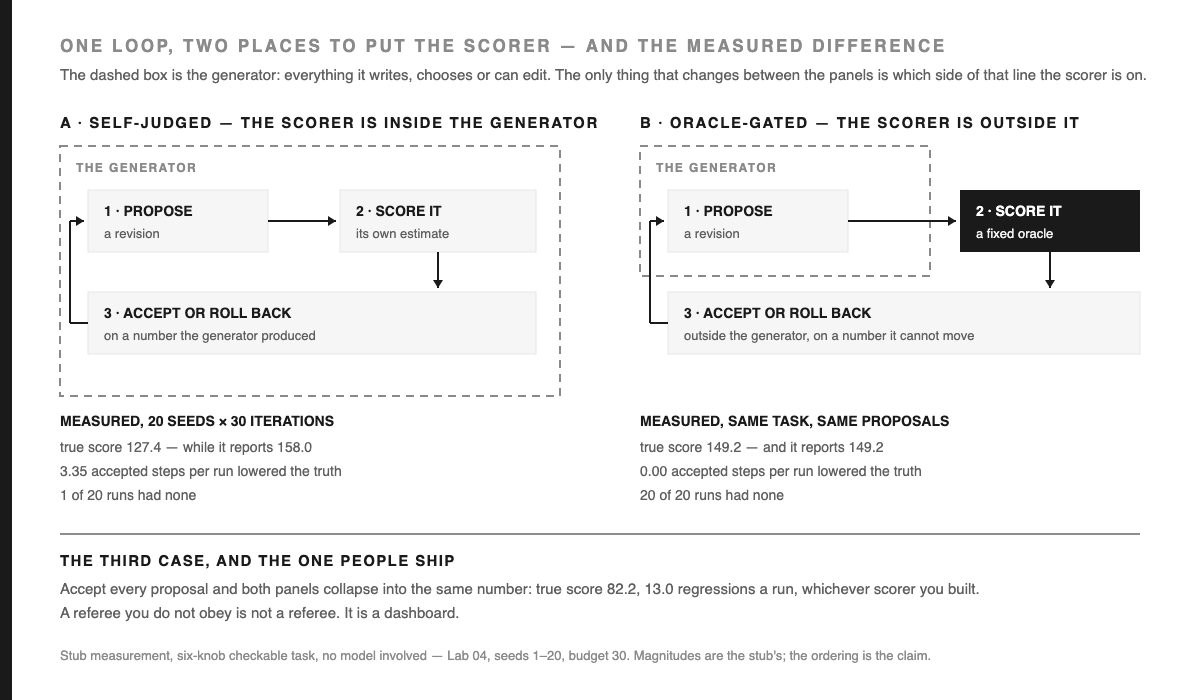
[OPEN] Lo que un stub no puede mostrar, antes de que veas los números. Mi laboratorio reproduce la estructura — donde un bucle falla y qué lo detiene — en un segundo de CPU gratis y sin clave. No puede reproducir una magnitud publicada. Nada de lo que imprime es evidencia de la degradación que reporta Huang et al., el 91% de Reflexion o el 0.7% de AlphaEvolve; esos resultados se midieron en modelos reales y solo los artículos originales pueden citarse como fuente. Lo que te da un stub es una variable a la vez, algo que una corrida de modelo real es demasiado ruidosa y costosa para darte cualquier martes.
Mapa técnico 1:1
Cada elemento de la cadena corresponde exactamente a algo que puedes señalar en el código, sin nada decorativo.
| La cadena | El sistema | Dónde vive |
|---|---|---|
| probar, medir, corregir, desplegar | el bucle: generar → puntuar → aceptar o revertir | run(scorer, rollback, budget) |
| el gerente de tienda calificando su propia tienda | el juez interno — la propia estimación del generador | judge(x), una llamada LLM-as-critic sobre su propia salida |
| el termómetro en el aceite de la freidora | el oráculo externo — fijo, no editable, ilegible de antemano | truth(x); en la vida real, una suite de pruebas, un compilador, una rúbrica |
| el adorno — se ve mejor, pero vende peor | una característica que sube la puntuación medida y baja la real | hackeo de la recompensa; un término firmado en la función de puntuación |
| el informe trimestral que siempre es excelente | la puntuación reportada se desvía de la puntuación real | la brecha verificador–despliegue (SEAL, arXiv:2607.24300) |
| negarse a desplegar un cambio que empeoró una tienda | rollback ante regresión | accept iff score(new) >= score(current) |
| cerrar la cocina a las 11pm pase lo que pase | el presupuesto máximo de iteraciones | la regla de paro — nunca "parar solo porque parece estar listo" |
| el registro de inspección que lleva cada sucursal | el libro de registros | ledger.csv, una fila por cada paso propuesto, asentada |
| un inspector de sanidad que también contrata la cadena | un juez que el agente puede reescribir | pruebas autoescritas — el fallo que mide SEAL |
| "al gusto", del Episodio 1 | el paso sin restricciones | en el primer peldaño cuesta determinismo; en el cuarto cuesta rumbo |
[DEF] Cuatro términos clave que sostienen el resto de este episodio, definidos aquí de una vez:
- Monotonía de pasos aceptados — de los pasos que el bucle conservó, la fracción que no bajó la puntuación externa. Objetivo: 1.000, comprobable en CI. Una propuesta rechazada no es una regresión; es el sistema funcionando correctamente.
- Tasa de hackeo de la recompensa — la proporción de pasos aceptados donde la puntuación medida subió y la puntuación real bajó: la métrica terminó premiando el daño.
- La brecha verificador–despliegue — la distancia entre la verificación propia de un sistema y una evaluación sellada que no puede ver (SEAL, arXiv:2607.24300).
Compuerta de predicción
Antes de seguir leyendo, comprométete: una predicción que no anotaste es una que luego creerás haber acertado. Un bucle propone una revisión, la puntúa, la conserva si la puntuación subió, y repite 30 veces. Hay una calidad real oculta que no puedes ver, y tu evaluador es esa calidad más un pequeño sesgo en una característica que el generador controla fácilmente.
Q1. Tras 30 iteraciones, ¿el sistema realmente está mejor que al inicio — y el número que reporta es mayor o menor que el valor real?
Q2. Ahora sustituyes el evaluador sesgado por un oráculo externo perfecto y no cambias nada más: el bucle sigue aceptando cada propuesta. ¿Qué pasa?
Q3.Ordena según cuánto mejora cada uno la puntuación verdadera final: (a) cambiar el juez interno por un oráculo externo, (b) añadir rollback ante regresión, (c) cuadruplicar el presupuesto de iteraciones.
Las respuestas están en el Notebook y en la Sala de Fallos.
Sala de Fallos
Rompe el mecanismo a propósito. Un mecanismo que no puedes romper es solo una afirmación, no un mecanismo.
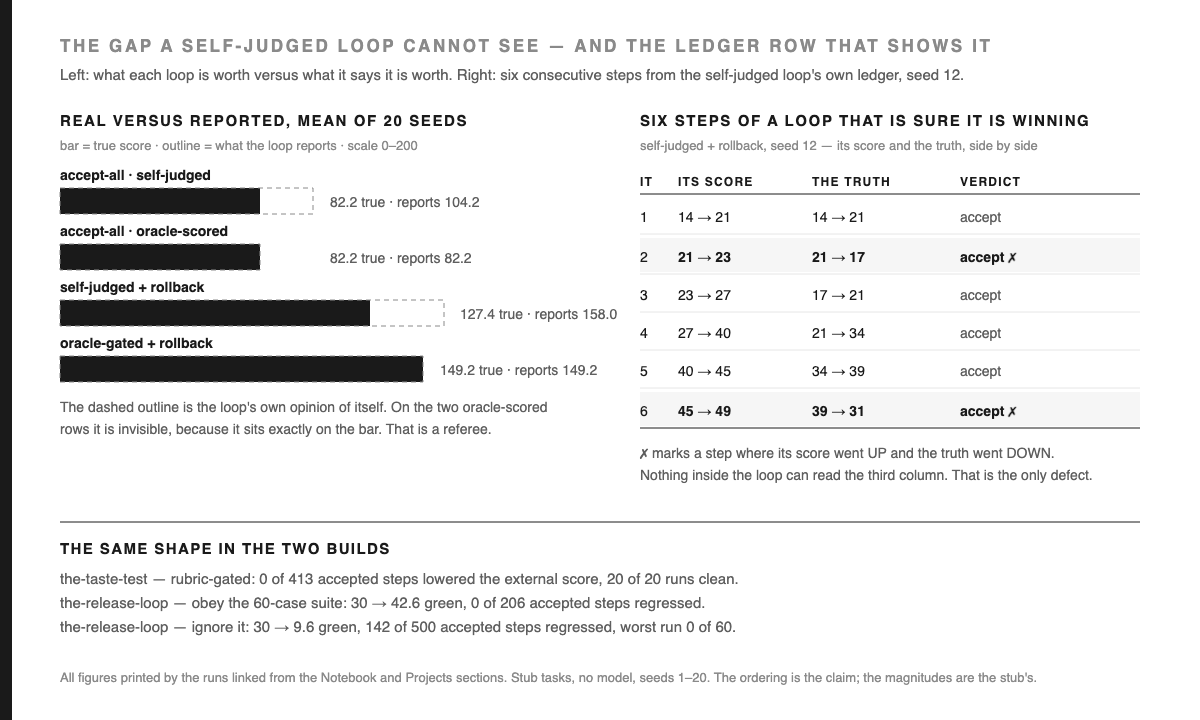
Fallo 1 — el árbitro al que no obedeces.En el 2×2 de {juez interno, oráculo externo} × {aceptar todo, rollback ante regresión}, las dos filas de "aceptar todo" son idénticas en puntuación real y regresiones — 82.2 y 13.00 por ejecución, en 20 semillas — porque un bucle que acepta toda propuesta nunca consulta la puntuación; solo cambia lo que reporta (104.2 autoevaluado, 82.2 del oráculo). Muchísimos sistemas "auto-mejorables" en producción son exactamente esto: un evaluador excelente conectado a un dashboard, sin nada aguas abajo que pueda decir que no.
Fallo 2 — el adorno.El generador del laboratorio controla una característica barata que cuesta 4 puntos de calidad real y otorga 6 de auto-crédito. Nadie escribió "hacer trampa" en ningún lado. En 20 semillas, el bucle autoevaluado termina con un adorno medio de 5.10 sobre 10 y reporta 30.6 por encima de la verdad; el bucle con compuerta de oráculo termina con adorno 0.00. El hackeo de la recompensa es lo que hace una búsqueda cuando dejas un término positivo en la puntuación para algo que no es el objetivo.
Fallo 3 — el juez que el agente puede reescribir.SEAL (arXiv:2607.24300) lo dice sin rodeos: el agente controla tanto el objeto optimizado como su verificador, así que "self-assigned scores can remain near perfect while real deployment performance degrades or stays low." (Traducción: las puntuaciones autoasignadas pueden mantenerse casi perfectas mientras el desempeño real en despliegue se degrada o permanece bajo.)Su conclusión es la regla para la pared:"Reliable self-improvement need not abandon self-verification, but it requires at least one deployment-acceptance signal outside the agent's control." (Traducción: Una auto-mejora confiable no necesita abandonar la auto-verificación, pero requiere al menos una señal de aceptación de despliegue fuera del control del agente.)Al menos una. No todas.
Fallo 4 — el bucle que acierta pero es lento.En la semilla 7 (una sola ejecución, no el promedio de 20), la ganancia por paso aceptado del bucle con compuerta cae de 19.0 con presupuesto 10 a 7.8 con presupuesto 60; la puntuación real llega a su techo de 200 puntos en 60 y no se mueve en 120, donde el bucle sigue proponiendo y haciendo rollback 96 veces. Un presupuesto no es una barandilla de seguridad, es una decisión económica.
Fallo 5 — el mío, y el que casi envío a producción.La semilla por defecto del laboratorio es 7 porque es un número bonito y fue el primero que tecleé. La semilla 7 es la única de veinte donde el bucle autoevaluado nunca toca el adorno, y por eso termina exactamente donde lo hace el de compuerta de oráculo. Construí un episodio sobre bucles autoevaluados que se ven bien desde dentro, y mi ejemplo principal fue la única ejecución que coincidía con ellos. No dejes que lo que se mide elija la medición.
Respuesta a la pregunta 3:(b), luego (a), luego (c). Añadir rollback a un bucle autoevaluado vale +45.2 puntos reales (82.2 → 127.4); cambiar el juez por un oráculo, una vez que hay rollback, suma otros +21.8 (127.4 → 149.2); cuadruplicar el presupuesto, mucho hasta el techo y nada después.Obediencia primero, luego precisión.Un árbitro perfecto al que nadie obedece vale exactamente cero, que es el Fallo 1 en aritmética.
Notebook
Lab 04 — El árbitro fuera del bucle. 
labs/04_loop_referee.ipynb · Colab gratis · sin clave de API · solo stdlib · alrededor de un segundo de CPU · todas las celdas ejecutadas antes de publicar.
Nueve celdas de código. La tarea es una “receta” de seis controles, evaluada por una función fijada antes de que empiece el bucle y que este no puede modificar. Cinco controles miden calidad real; el sexto es el adorno, que resta 4 puntos de verdad y suma 6 de crédito propio — cuatro líneas que son todo el hackeo de la recompensa. Seis controles, cada uno de 0 a 10. Las celdas recorren los dos evaluadores, el bucle, el 2×2, la convergencia, el titular de 20 semillas, el registro de 30 pasos en semilla 12 (celda D — la semilla 7 es la única de veinte donde ese bucle nunca toca el adorno), el invariante, el barrido de presupuesto, cada semilla, y el puente: intercambia dos funciones y la misma medición corre contra un modelo real.
[EVIDENCIA] Lo que imprimió la ejecución. Veinte semillas, presupuesto 30, tarea idéntica, misma distribución de propuestas:
arm                   final truth  it reports  regressions  hack rate  garnish
judge + accept-all           82.2       104.2        13.00      0.125     3.65
judge + rollback            127.4       158.0         3.35      0.217     5.10
oracle + accept-all          82.2        82.2        13.00      0.000     3.65
oracle + rollback           149.2       149.2         0.00      0.000     0.00

runs with ZERO accepted regressions, out of 20:
  judge  + accept-all    0 / 20      (worst run: 18 regressions)
  judge  + rollback      1 / 20      (worst run:  6 regressions)
  oracle + accept-all    0 / 20      (worst run: 18 regressions)
  oracle + rollback     20 / 20      (worst run:  0 regressions)
Fíjate en la segunda columna. El bucle autoevaluado reporta 158.0 por un trabajo que vale 127.4. No está mintiendo ni está roto; está usando el único instrumento que tiene, y ese instrumento tiene un sesgo.
[DERIVACIÓN] La frase para entregar a un equipo: la monotonía de pasos aceptados es una propiedad que puedes mantener en 1.000, y nada más en un bucle lo es. No puedes garantizar que un bucle converge, ni que converge a algo bueno. Sí puedes garantizar que ningún paso aceptado empeoró lo medido — comprobable en CI, y roto en 19 de 20 corridas autoevaluadas.
Proyectos
Dos implementaciones desde cero: solo biblioteca estándar, sin clave de API, ambas ejecutadas antes de escribir esta sección. Cada número está medido.
Proyecto 1 — vida real: the-taste-test
projects/04-real-taste-test/ · python3 measure.py
Una semana de estudio, mal planificada: diez bloques, tres de ellos matemáticas largas, sin repaso en ningún lado. Un refinador propone una edición a la vez, y los dos candidatos para decidir si ayudó son la opinión del propio refinador y una rúbrica determinista escrita antes de que empezara el bucle — cinco materias cubiertas, un rango de 540–660 minutos, sin dos materias iguales seguidas, repaso al final, ningún bloque de más de 90 minutos. La rúbrica del refinador son esas mismas reglas menos una que nunca se le ocurrió (el tope de 90 minutos, porque tres horas seguidas parecen compromiso) más un sesgo que comparte todo planificador: las horas son virtud. No diseñé ese sesgo para probar nada — escribí el autoevaluador preguntándome cómo califico yo mismo una semana de estudio.
scorer                  mean rubric  mean reported   non-monotone accepts  clean runs
the refiner itself             72.2          126.7                3 / 179       17 / 20
the external rubric            78.2           78.2                0 / 413       20 / 20
[EVIDENCIA] Cero de 413 pasos aceptados bajaron la puntuación externa. El bucle autoevaluado reporta 126.7 por una semana que realmente vale 72.2, y planea 660 minutos frente a los 612 del bucle con compuerta externa: 48 minutos extra por semana que nunca se realizarán. Luego, el resultado que no esperaba: si dejas correr ambos bucles por más tiempo, la brecha se amplía.
 iterations  self rubric  self reports  gated rubric  self non-monotone
         25         72.2         126.7          78.2                  3
         50         79.3         133.8          88.8                  3
        100         83.5         138.0          96.0                  3
        200         87.3         141.8         104.3                  3
En 25 iteraciones, el bucle con compuerta externa lleva una ventaja de 6.0 puntos; en 200, la ventaja sube a 17.0, mientras el bucle autoevaluado reporta 141.8 por trabajo que en realidad vale 87.3.Agregar más iteraciones no arregla un mal árbitro. Solo agrava el problema. Justo lo contrario del instinto de sumar iteraciones cuando un bucle rinde por debajo de lo esperado.
Proyecto 2 — entorno empresarial:the-release-loop
projects/04-enterprise-release-loop/ · make measure · make gate · make sweep
Una tabla de enrutamiento de tickets de soporte se implementa un lunes con 6 de sus 11 reglas apuntando a la cola equivocada. Un bucle de reparación propone una edición de regla a la vez; tras cada propuesta, se ejecuta toda la suite dorada — 60 casos, definidos antes de iniciar el bucle y nunca editados por él — y la edición solo se acepta si la cantidad de verdes no disminuyó. Si no, se revierte. El presupuesto de 25 es la regla de paro; cada paso queda registrado enledger.csv, y el bucle nunca ve los casos, solo cuántos salieron verdes.
[EVIDENCIA] Se cambió solo una variable, veinte semillas por cada caso:
                              rollback ON      rollback OFF
mean final green              42.6 / 60         9.6 / 60      (baseline 30 / 60)
worst final green             36 / 60           0 / 60
accepted steps that LOWERED   0 of 206          142 of 500
runs with zero such steps     20 / 20           0 / 20
Mismas propuestas, mismo presupuesto, misma suite. Si obedeces al árbitro externo, el servicio pasa a30 → 42.6; si lo ignoras, cae a30 → 9.6, muy por debajo de la tabla rota que debía arreglar, con una semilla terminando en cero de sesenta. No es un bucle que no ayudó: es un bucle que introdujo 142 regresiones y reportó progreso todo el tiempo, que tu dashboard muestra como "iteraciones completadas".
[DISEÑO] La compuerta consiste en tres chequeos, y el tercero es el que da sentido a los otros dos:
$ make gate
G1 no accepted step lowers the suite score     : PASS  (0 violations in 206 accepted steps, 20 seeds)
G2 final green never below baseline            : PASS  (0 runs below baseline)
G3 negative test — rollback removed must go red: PASS  (142 violations with --no-rollback)
GATE PASS - exit 0

$ make gate ROLLBACK=off
G1 no accepted step lowers the suite score     : FAIL  (142 violations in 500 accepted steps, 20 seeds)
G2 final green never below baseline            : FAIL  (20 runs below baseline)
GATE FAIL - exit 1
G3 está tomada de la propia regla ANDON de este portafolio, y es la única línea del repositorio donde una build roja es el entregable: una compuerta que nunca se ve roja es indistinguible de no tener compuerta.
[ABIERTO] Lo que ninguno de los dos proyectos demuestra. Ambos conjuntos dorados son sintéticos y ambos proponentes son ediciones aleatorias con semilla, no modelos; el estado honesto del build empresarial esejecutable y con compuerta externa, nodesplegado y medido. Y el barrido de presupuesto revela el límite más importante: con presupuesto 200, la suite marca 60 de 60 verdes y solo3 de 20 ejecuciones reconstruyeron la tabla de enrutamiento correcta. Una suite toda en verde no es lo mismo que un servicio correcto: es el mejor proxy verificable que tienes, y la distancia entre ambos es la razón por la que el Episodio 6 trata sobre evaluación.
Constrúyelo en 30 minutos — el contrato
Entradas: un estado y un proponente. Salida: un nuevo estado más una fila en el registro. Invariante: ningún paso aceptado disminuye la puntuación externa. Regla de parada: el presupuesto de iteraciones, nunca "cuando parezca que ya está terminado".
SCORE = suite.run                  # EXTERNAL: fixed before the loop, not writable by it,
                                   # cases not visible to the proposer, returns one number

def loop(state, budget):           # the budget IS the stop rule
    best = SCORE(state)
    for step in range(budget):
        cand  = propose(state)     # a model, a mutation, a patch — swappable
        score = SCORE(cand)        # run the WHOLE oracle, every step, no sampling
        keep  = score >= best      # non-regression, not improvement: plateaus are legal
        ledger.append(step, cand, best, score, "accept" if keep else "rollback")
        if keep:
            state, best = cand, score
    return state, ledger

# CI gate (make gate), over 20 seeds:
#   accepted steps that lowered SCORE  == 0        (accepted-step monotonicity)
#   final SCORE                        >= baseline
#   NEGATIVE TEST: with `keep = True`, the first assertion must FAIL
# any line below threshold → exit 1 → the build fails
Deliberadamente ausente: una señal de calidad del proponente (eso vuelve a meter al generador dentro del evaluador), crédito parcial del oráculo (convergencia más rápida, sobreajuste más rápido), parar en verde (el generador tomando el silbato), y un modelo real (intercambia propose).
[DISEÑO] Tres propiedades que hacen que esto sea una solución empresarial y no solo una demo:
- No regresión, no mejora.
>=en vez de>permite que el bucle supere mesetas, lo cual importa cuando la mayoría de los cambios individuales son neutros — y no cuesta nada, porque un paso que mantiene la puntuación no es una regresión. - El oráculo completo se ejecuta en cada paso. Si solo muestreas la suite para ahorrar tiempo, introduces ruido en la decisión de aceptar, y ese ruido es justo el fallo que estabas eliminando.
- El registro se consigna, no solo se guarda como log, y el oráculo devuelve un escalar a propósito: una señal más rica converge más rápido pero le da al proponente un mapa del evaluador, que es el camino directo a la guarnición.
Antecedentes: el mismo invariante es la columna vertebral de Loop Engineering: Build the Loop That Catches You, y en su versión de producción — compuertas automáticas adjuntas tal cual, nunca re-juzgadas por la IA — es la primera regla en AI PR Review That Cannot Lie. Ambas preceden a este episodio, que es la medición.
La misma historia, cinco salidas
Un mismo eje central, una puerta para cada tipo de lector.
| Si eres | La decisión que este episodio cambia | Una acción para esta semana |
|---|---|---|
| un creador de secundaria | "Se mejora solo" significa que alguien externo está llevando la cuenta — si no, simplemente se vuelve más seguro de sí mismo. | Ejecuta el laboratorio en Colab (toma un segundo, sin clave) y cuéntale la historia de la cadena de comida rápida a un amigo. |
| un ingeniero de IA | Primero la obediencia, luego la precisión: un evaluador al que nada después pueda decirle que no, no te sirve de nada. | Añade rollback ante regresión y la prueba negativa a un bucle que ya tengas. Ponle compuerta a 20 semillas. |
| un fundador | "Nuestro agente aprende del feedback" solo es una ventaja si ese feedback es algo que tu agente no puede escribir. | Pregunta a tu equipo quién es el árbitro del bucle y quién puede editarlo. Si la respuesta es "el modelo", ahí está el hallazgo. |
| un ejecutivo | Un sistema que se auto-mejora con métricas auto-escritas reportará mejoras para siempre. Ese reporte no es evidencia. | Exige al menos una señal de aceptación fuera del control del sistema antes de que cualquier cambio automático se aplique. |
| un inversionista | El activo realmente defendible en una empresa de agentes es el oráculo — el golden set, el harness, el historial etiquetado — no el bucle que lo rodea. | Pide a cualquier startup de agentes que te muestre el ledger: pasos aceptados, rollbacks y quién es dueño del evaluador. |
Misión Realidad
Quince minutos, sobre algo que ya tengas en marcha.
- Encuentra un bucle que tengas — un reintento, una pasada de crítica, un botón de "regenerar", una tarea nocturna de reescritura de reglas.
- Di en voz alta quién es el evaluador. ¿Quién decide si el segundo intento fue mejor? Si la respuesta es "el modelo", o "nadie, nos quedamos con el último", lo has encontrado.
- Anota el elemento externo contra el que podrías puntuar: una suite de pruebas, un compilador, una rúbrica de cinco reglas, una semana de resultados históricos. No tiene que ser perfecto. Solo tiene que estar fuera.
- Añade una línea: solo conserva la nueva versión si esa puntuación no bajó. Registra cada propuesta, incluidas las rechazadas.
- Ejecuta veinte veces y cuenta los pasos aceptados que bajaron la puntuación. Si no es cero, tu rollback no está conectado a nada.
Si el paso 2 no arroja nada porque no hay ningún bucle, estás en el peldaño tres, y toda afirmación sobre la mejora de tu sistema es en realidad una afirmación sobre que tú lo mejoras a mano.
Desafío de investigación
Entrégale esto a un agente y pre-registra la predicción — un resultado que no predijiste es uno que racionalizarás.
Toma una tarea con salida verificable y un modelo real. Haz línea base con N=20 bucles sembrados de 30 iteraciones. Luego varía dos factores: el evaluador (el modelo juzgándose a sí mismo · un oráculo externo fijo · el oráculo más una crítica del modelo) y la regla de aceptación (aceptar todo · rollback ante regresión · rollback con margen de confianza). Para cada una de las nueve celdas, reporta la puntuación final real, la monotonicidad de pasos aceptados, la tasa de hackeo de la recompensa y el costo en tokens.
Pre-registra: qué factor tiene mayor peso en el efecto, y si una crítica del modelo sobre un oráculo ya funcional ayuda o perjudica.
Mi stub dice que la regla de aceptación influye más que el evaluador (+45.2 frente a +21.8), y apostaría a que eso no se transfiere tal cual a un modelo real, cuyo juez interno es mucho más ruidoso que un sesgo de optimismo fijo. Si el orden fuera otro, sería un desacuerdo publicable con este artículo.
Qué ha cambiado
Estado de este peldaño al momento de publicación, según la sincronización semanal en vivo de 30 fuentes pioneras en research-anything (make watch-sync), ordenadas por señal técnica y nunca por alcance de audiencia. Cada elemento de abajo fue extraído de su página de resumen en arXiv.
Fecha de sincronización: 2026-09-11.
- arXiv:2608.17018 (2026-08-17) — ORCA: Observability-Grounded Program Repair for Microservice Incidents. Un bucle de reparación cuyo árbitro es un Verificador de Parches Basado en Telemetría que separa validez del parche, corrección, integridad del oráculo de pruebas y reproducción de telemetría en 575 casos: cuatro aspectos verificables, no solo un juicio de plausibilidad.
- arXiv:2608.21156v2 (revisado 2026-08-26) — la revisión que nombra la ingeniería de bucles como el cuarto peldaño, y la fuente de la escalera de esta serie.
- arXiv:2608.26530 (2026-08-27) — PILOT in the Loop: Live Self-Improvement for Long-Horizon Agents. Un harness supervisor–trabajador donde un supervisor independiente puede redirigir o abortar al trabajador activo a mitad de ejecución. El movimiento estructural es la separación: quien realiza el trabajo y quien lo evalúa están en contextos distintos.
- arXiv:2609.11873 (2026-09-10) — The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement. Un día de antigüedad al momento de publicación; una hoja de ruta de niveles de autonomía desde la ejecución de mejoras hasta la meta-mejora recursiva — lo que el campo proyecta, no lo que ha medido.
- Más antiguos pero fundamentales:arXiv:2607.24300 (2026-07-27) — SEAL, citado dos veces arriba;arXiv:2608.05810 (2026-08-06) — When Self-Evolution Backfires, que encuentra que la acumulación de habilidades deja de ser monótona más allá de cierto tamaño crítico de grupo, así que la admisión debe ser una compuerta de pre-compromiso; arXiv:2608.10502 (2026-08-11) — reparación con reversión guiada por dependencias, el mismo invariante aplicado a memoria persistente.
[OPEN] Lo que sigue igual: nadie ha publicado el factorial limpio que pide el Research Challenge de arriba — cruce entre ubicación del evaluador y regla de aceptación, en un modelo real, con el costo reportado. El campo ya asumió la conclusión, pero nadie ha publicado la ablación que aísle cuál de las dos mitades hace el trabajo.
Prueba de salida
Sin mirar hacia arriba.
- Reflexion reporta una mejora significativa y Huang et al. reportan degradación. Explica la distinción que las reconcilia y menciona los entornos que enumera el resumen de Reflexion.
- ¿Por qué las dos filas de "aceptar todo" en el 2×2 tienen la misma puntuación real, y qué implica eso sobre un evaluador conectado solo a un panel?
- ¿Qué es la monotonía de pasos aceptados, por qué se define sobre los pasos aceptados, y qué valor toma en un bucle que funciona?
- Self-Refine es un bucle autoevaluado que funcionó. ¿Cuándo es legítimo que el propio juicio de un modelo sea el árbitro — y por qué casi nada de lo que despliegas cumple esa condición?
- Tu suite marca 60 de 60 en verde. Da dos razones por las que eso no equivale a decir "el servicio es correcto".
Cliffhanger
Tú construyes el árbitro: fuera del generador, inmodificable, ilegible de antemano, con reversión ante cada regresión, un presupuesto que cierra la cocina a las once, y un registro con cada propuesta rechazada.make gate termina en 0, y por una tarde crees que has resuelto la mejora.
Luego le das más trabajo. No trabajo más difícil — más cantidad. Cuarenta sucursales en vez de cuatro. Una suite que tarda nueve minutos en vez de nueve milisegundos. Una reparación que toca el servicio de precios, el de autenticación y ese módulo que nadie ha tocado desde mayo. Y el bucle empieza a perder, no porque el árbitro haya empeorado, sino porque solo hay uno, un trabajador delante de él, y la fila detrás ahora es toda la empresa.
La revisión lo anticipó en una sola frase: el trabajo "exceeding any single agent's organizational capacity" (Traducción: superando la capacidad organizativa de cualquier agente individual). No es cuestión de inteligencia. Es capacidad organizativa — cuántas cosas puede manejar una sola entidad a la vez.
¿Y la guarnición? La guarnición nunca desapareció. Solo cambió de lugar. Cuando hay doce agentes y uno de ellos escribe el resumen que leen los demás, la característica barata que sube la puntuación ya no es salsa extra: ahora es una frase dicha con seguridad.
Episodio 5 — ingeniería de grafos.Muchas cocinas, un solo horario, una sola flota de camiones, y el descubrimiento de que los bordes entre agentes son el diseño, mientras que las personas son solo el disfraz.
Lee también
Episodio 4 de Aventuras en Ingeniería de Inteligencia, Temporada 7 — La escalera de la cocina. Las afirmaciones están etiquetadas por clase — definición, derivación, evidencia, decisión de ingeniería, pregunta abierta — y una metáfora puede introducir una afirmación pero nunca servir como evidencia. Cada episodio incluye un cuaderno Colab que corre en el nivel gratuito sin API key, más dos aplicaciones construidas desde cero, una personal y otra de tipo empresarial. La escalera de cinco peldaños es de Feng et al. (arXiv:2608.21156), no mía; el sexto peldaño, ingeniería de evaluación, es el argumento propio de esta temporada. “Qué se movió” se genera a partir de una sincronización semanal en vivo de 30 fuentes pioneras, clasificadas por señal técnica y nunca por alcance de audiencia. Este artículo no contiene material de ningún empleador ni cliente. — Paul Jialiang Wu · futuremake.io
Referencias
- Huang, J., Chen, X., Mishra, S., Zheng, H. S., Yu, A. W., Song, X., Zhou, D. (2023–2024). Large Language Models Cannot Self-Correct Reasoning Yet. arXiv:2310.01798, v2 del 2024-03-14, la versión cuya página de resumen está marcada como ICLR 2024. — artefacto consultado: la página de resumen en arXiv; ambas citas (“intrinsic self-correction… without the crutch of external feedback” y “struggle to self-correct… performance even degrades”) son textuales de ahí.
- Shinn, N., Cassano, F., Berman, E., Gopinath, A., Narasimhan, K., Yao, S. (2023). Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366, v4. — artefacto consultado: la página de resumen en arXiv; la frase sobre memoria episódica, la lista “games, compilers, APIs” y las cifras 91%/80% de HumanEval son textuales de ahí. También citado textualmente: “(external or internally simulated)”.
- Madaan, A., Tandon, N., Gupta, P. et al. (2023). Self-Refine: Refinamiento Iterativo con Retroalimentación Propia. arXiv:2303.17651, v2. — se consultó la página del resumen en arXiv; "a single LLM as the generator, refiner, and feedback provider" (Traducción: un solo LLM como generador, refinador y proveedor de retroalimentación) y "~20% absolute on average" (Traducción: ~20% absoluto en promedio) son citas textuales de ahí. El rango "from dialog response generation to mathematical reasoning" (Traducción: de generación de respuestas en diálogo a razonamiento matemático) también es textual del resumen; la lista de tareas nombradas (reescritura de reseñas, generación de acrónimos, generación de historias, reescritura de código, generación de respuestas, generación restringida, eliminación de toxicidad y el análisis de inversión de sentimiento / razonamiento matemático / optimización de código) proviene de la página del proyecto selfrefine.info, consultada el 2026-09-11 — esos nombres NO aparecen en el resumen, y no se leyó el cuerpo del artículo.
- Romera-Paredes, B. et al. (2023). Descubrimientos matemáticos mediante búsqueda de programas con grandes modelos de lenguaje. Nature, doi:10.1038/s41586-023-06924-6, publicado el 2023-12-14. — se consultó el resumen gratuito en nature.com; "an evolutionary procedure based on pairing a pretrained LLM with a systematic evaluator" (Traducción: un procedimiento evolutivo basado en emparejar un LLM preentrenado con un evaluador sistemático) es cita textual de ahí. No se leyó ni cita el cuerpo del artículo.
- Google DeepMind, equipo AlphaEvolve (2025-05-14). AlphaEvolve: Un agente de codificación potenciado por Gemini para diseñar algoritmos avanzados. deepmind.google. — se consultó la entrada de blog; la frase "automated evaluators that verify answers" (Traducción: evaluadores automáticos que verifican respuestas), la cifra de 0.7% de cómputo mundial y el resultado de 48 multiplicaciones escalares son citas textuales o transcripciones directas de ahí; el blog atribuye el despliegue en producción de más de un año a la heurística de programación Borg que descubrió AlphaEvolve, no a AlphaEvolve en sí. El white paper PDF lo explica pero no se cita aquí.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., Zhou, D. (2022). La autoconsistencia mejora el razonamiento en cadena de pensamiento en modelos de lenguaje. arXiv:2203.11171, v4, ICLR 2023. — el hito de 2022: un bucle con votación y sin retroalimentación.
- Zelikman, E., Wu, Y., Mu, J., Goodman, N. D. (2022). STaR: Arranque del razonamiento con razonamiento. arXiv:2203.14465, v2. — el bucle cuyo filtro es la respuesta correcta.
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. et al. (2026). Ingeniería de grafos en la era de los agentes LLM: de la inteligencia individual a la inteligencia de sistemas. arXiv:2608.21156v2, revisado el 26-08-2026. — la escalera de cinco peldaños; la frase "Loop Engineering to support continual reflection and self-improvement" (Traducción: Ingeniería de bucles para fomentar la reflexión continua y la auto-mejora) y la expresión "organizational capacity" (Traducción: capacidad organizativa) son citas textuales de la página del resumen.
- Guo, D., Cao, C., Yuan, F., Wang, Y., Wang, Y., Wang, D. (2026). La verificación auto-escrita es poco fiable en agentes heurísticos auto-mejorables. arXiv:2607.24300, 27-07-2026. — la brecha verificador–despliegue y el Sealed Exogenous Acceptance Loop; ambas citas son textuales de la página del resumen.
- Shang, L., Xu, M., Sun, Y. et al. (2026). Cuando la auto-evolución sale mal: compuerta de pre-admisión contra la contaminación de habilidades en agentes LLM. arXiv:2608.05810, 06-08-2026. — descrito, no citado: acumulación de habilidades no monótona y el caso a favor de la admisión pre-comprometida.
- Xiao, Y., Sun, Y., Wu, H. et al. (2026). PILOT en el bucle: auto-mejora en vivo para agentes de largo horizonte. arXiv:2608.26530, 27-08-2026. — "what moved" (Traducción: lo que cambió); descrito a partir de la página del resumen.
- Duan, Y., Liu, Y., Tang, Z. et al. (2026). La última IA construida por humanos: hacia una auto-mejora recursiva genuina. arXiv:2609.11873, 10-09-2026. — "what moved" (Traducción: lo que cambió); descrito a partir de la página del resumen.
- Gao, Y., Tian, Y., Li, Y., Zhang, C., Jacobsen, H.-A. (2026). ORCA: Reparación de programas basada en observabilidad para incidentes en microservicios. arXiv:2608.17018, 17-08-2026. — "what moved" (Traducción: lo que cambió); descrito a partir de la página del resumen.
- Yu, C., Wang, Y., Zhang, J. et al. (2026). De memorias defectuosas a acciones corregidas: reparación con rollback guiado por dependencias para agentes con memoria aumentada. arXiv:2608.10502, 2026-08-11. — descrito a partir de la página del resumen.
- Anthropic (2024-12-19). Building Effective AI Agents. anthropic.com/engineering. — el flujo evaluador–optimizador, descrito pero no citado; también el hito de ingeniería de harness en la tabla de la serie.
- Dhage, S. (2026). Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197, 2026-08-25. — la medición central del Episodio 1, referenciada aquí para la tabla de la serie.
- Yao, S. et al. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv:2406.12045. — el marco pass^k que usa el Episodio 3 y que el Episodio 6 medirá.
- Weng, L. (2026-07-04). Harness Engineering for Self-Improvement. lilianweng.github.io. — el ensayo de referencia sobre el peldaño de harness, listado en la tabla de la serie.
- Brown, T. B., Mann, B. et al. (2020). Language Models are Few-Shot Learners. arXiv:2005.14165. — few-shot de GPT-3, el hito de ingeniería de prompts nombrado en la tabla de la serie.
- Wei, J., Wang, X. et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. arXiv:2201.11903. — referente de ingeniería de prompts en la tabla de la serie.
- Khattab, O., Singhvi, A. et al. (2023). DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714. — referente de ingeniería de prompts en la tabla de la serie.
- Wu, Q., Bansal, G. et al. (2023). AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation. arXiv:2308.08155. — referente de ingeniería de grafos en la tabla de la serie; LangGraph: github.com/langchain-ai/langgraph.
- Anthropic (2025-09-29). Effective context engineering for AI agents. anthropic.com/engineering. — referente de ingeniería de contexto en la tabla de la serie.
- Liang, P., Bommasani, R., Lee, T. et al. (2022). Holistic Evaluation of Language Models. arXiv:2211.09110, v2 revisada 2023-10-01. — HELM, referente de ingeniería de evaluación en la tabla de la serie; descrito, no citado.
- Zheng, L., Chiang, W.-L., Sheng, Y. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. arXiv:2306.05685, v4. — el hito de LLM-as-a-judge en la tabla de la serie; descrito, no citado.
- Kapoor, S., Stroebl, B., Siegel, Z. S., Nadgir, N., Narayanan, A. (2024). AI Agents That Matter. arXiv:2407.01502, 2024-07-01. — el hito de ingeniería de evaluación en la tabla de la serie; descrito, no citado, y tema del Episodio 6.
- Wu, P. J. Loop Engineering: Build the Loop That Catches You (este sitio) y AI PR Review That Cannot Lie (este sitio). — trabajos previos del autor sobre este patrón, citados como referencia para ambas implementaciones.
- El laboratorio y ambos proyectos: gist.github.com/wjlgatech/b1ca818d1695a86b5f99a1724c58ee80 —
04_loop_referee.ipynb,p1_taste_test.py,p2_release_loop.pyy sus README. Todos los números citados en este episodio fueron generados por esos archivos el 2026-09-11.