AIネイティブシリーズ · エージェントエンジニアリング比較:プロンプト · コンテキスト · ハーネス · ループ · グラフ
グラフエンジニアリングはスケジュールであり、ペルソナの配役ではない
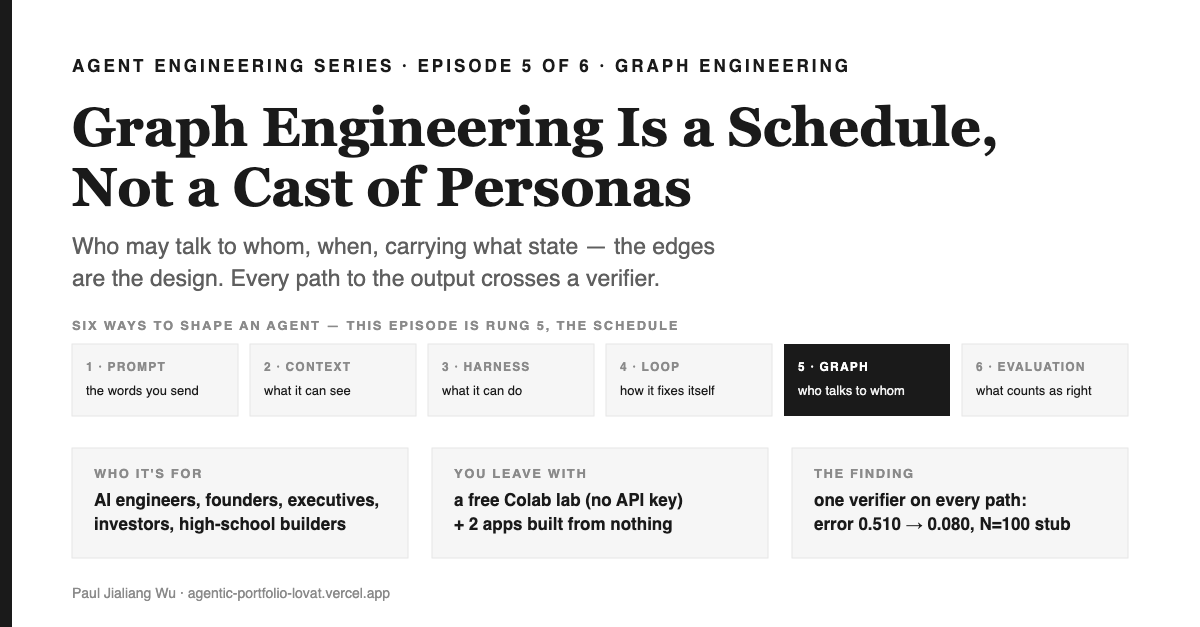
全6回中の第5回。このシリーズはAIエージェントの設計手法——プロンプト、コンテキスト、ハーネス、ループ、グラフエンジニアリング——を比較し、それぞれの起源、制御対象、主導者、そして測定で生き残る原則を問う。今回は「1エージェントでは足りなくなる」段階であり、多くの人がここで誤った選択をする。
1分でつかむ要点 — 読後に残るもの
本稿の概要 AIエージェントをどう設計するかを比較するシリーズ——プロンプトエンジニアリング(送る言葉)、コンテキストエンジニアリング(見える範囲)、ハーネスエンジニアリング(できること)、ループエンジニアリング(自己修正の仕組み)、そして グラフエンジニアリング(複数エージェントの協調設計)。今回はグラフエンジニアリングを扱う:2023年から2026年までの歴史、誰が主導してきたか、そして計測で残る原理——設計の本質はエッジであり、ペルソナは単なる衣装にすぎない。
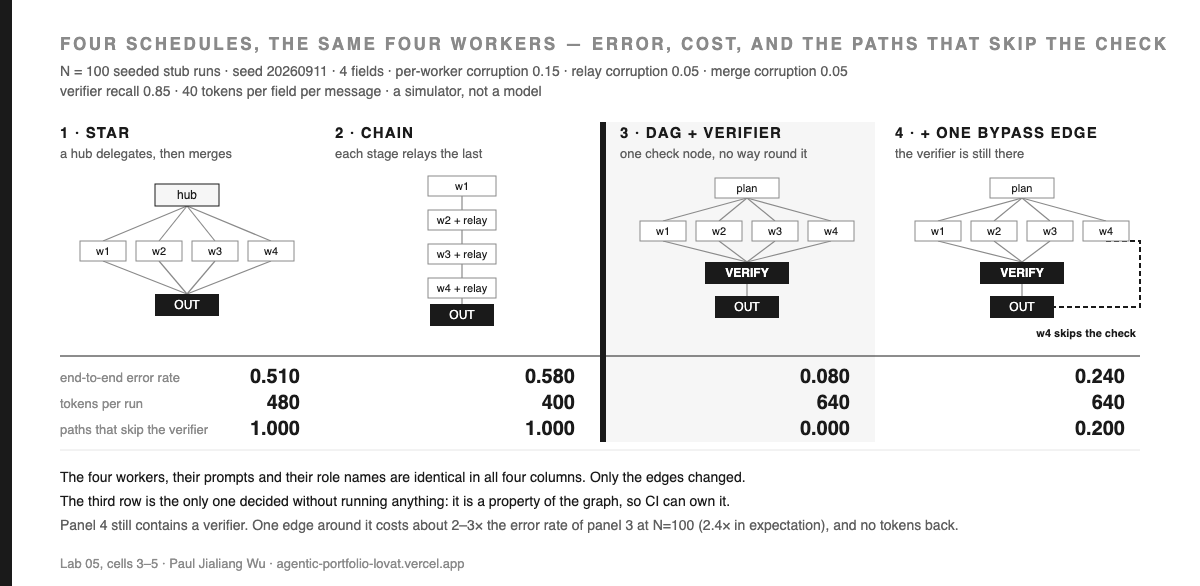
なぜこれが重要か。マルチエージェントシステムは「役割のキャスト」として売られ、チャットの約15倍のコストがかかり、単一エージェントでは起こらない失敗を引き起こす。7つのフレームワークで1,600件超のアノテーション付きトレースから構築された分類では、失敗カテゴリの3分の1がタスク検証だけに集中している。自分のシード付きラボでは、4人のワーカーと役割名はそのままに、配線だけを変えたところ、エンドツーエンドのエラー率は0.510から0.080へ下がった(N=100シミュレータ)。さらに、チェックノードをバイパスするショートカットエッジを1本加えただけで、チェックノード自体は残っているにもかかわらず、エラー率は0.240に跳ね上がった——N=100で約2〜3倍(期待値2.4倍)。創業者にとってはデモか請求書かの分かれ目であり、エンジニアにとってはマイクロ秒で走り、モデル不要のチェックである。
このエピソードを読んだ後にできること。自分のエージェントシステムをエッジリストとして描き、検証ノードを通らずに出力へ到達するすべての経路を洗い出し、それをビルド失敗としてカウントする。4つのトポロジーを並列で計測できるColabノートブック(APIキー不要、CPU数秒)が無料で使え、ゼロから作った2つのアプリも付属する。ひとつはディナーパーティープランナーで、スケジュール型なら224個の横断的な衝突を設計上1つも見逃さないが、ペルソナだけのチャットでは50件見逃す。もうひとつはインシデントレスポンスグラフで、make gate出口が1つ、誰かがショートカットを加えた瞬間に、その経路を正確に特定する。
Season 7 — シリーズの背骨
- プロンプトエンジニアリング——呪文ではなく仕様 第1話
- コンテキストエンジニアリング——予算で考える、ウィンドウを広げる話ではない 第2話
- ハーネスエンジニアリング――エンベロープであってエージェントそのものではない 第3話
- ループエンジニアリング——再試行ではなく外部の判定者 第4話
- グラフエンジニアリング —— 配役ではなくスケジュール この回
- 評価エンジニアリング——リーダーボードではなく「正しさ」を決める関数 第6話
今回の内容と、なぜグラフエンジニアリングが5番目なのか
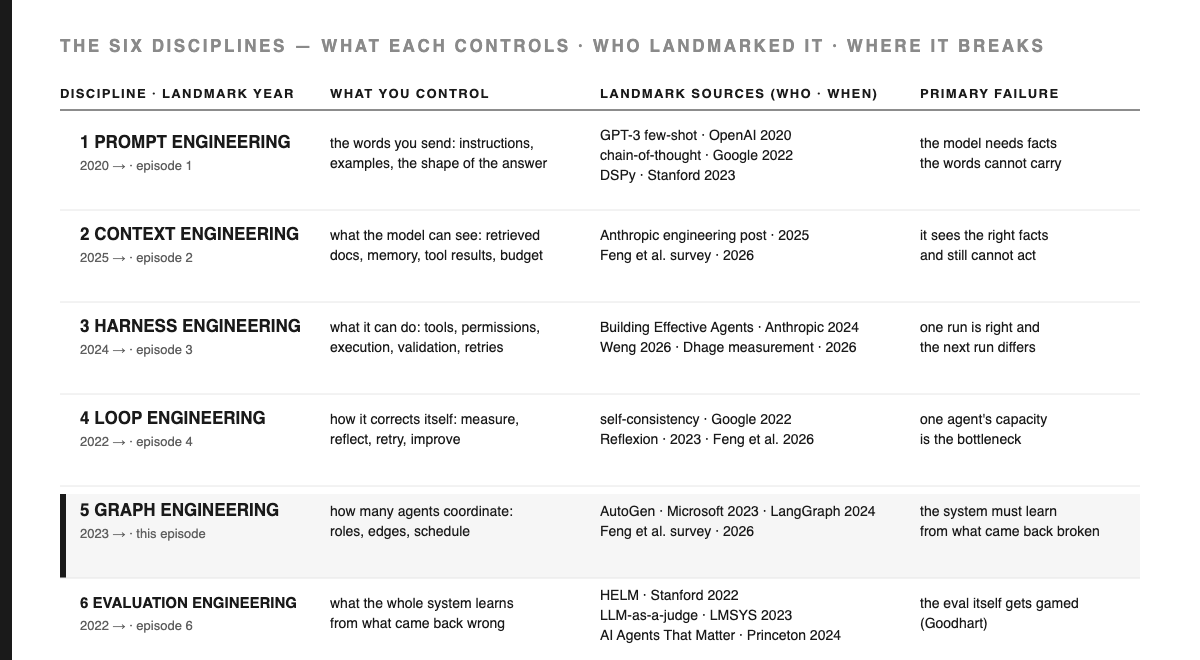
AIエージェント構築のための6つの分野が、ほぼこの順で現れた:プロンプトエンジニアリング(2020年)、ループ・評価エンジニアリング(2022年)、グラフエンジニアリング(2023年)、ハーネスエンジニアリング(2024年)、コンテキストエンジニアリング(2025年)。このうち最初の5つについて最も明確に整理しているのがFengらのサーベイ(arXiv:2608.21156)——各手法が何を制御できるか、という観点で並べている各手法が制御する対象(年次順ではなく、プロンプト→コンテキスト→ハーネス→ループ→グラフの順)。第六段階は彼らのものでも引用でもなく、本シリーズ独自の提案であり、第6話でその必要性を論じている。このシリーズは各話ごとに一つずつ取り上げ、その順番で「どこから生まれたか」「何を制御できるか」「誰が主導しているか」「どの失敗が次の段階を促すか」の4つの問いを投げている。
グラフエンジニアリングは、もはやエージェントの能力そのものではなく、組織としての器がボトルネックになったときに到達する段階だ。複数の専門性が同時に必要で、相互依存するサブタスクがあり、並列で進められる作業があり、誰かが結果を検証しなければならず、ステップ間で状態が持続する。もはや一人の作業者を調整するのではなく、「誰が何を誰に渡すか」を設計する段階に入る——そしてここが、業界で最も自信を持ってエンジニアリングが行われている一方で、最も検証しにくい「肩書きリスト」というオブジェクトが主役になる場面である。
想定する読者 2人目のエージェントを追加しようとしているエンジニア、5人のエージェントがいるシステムをデバッグしているエンジニア。「マルチエージェント」がアーキテクチャなのか単なる売り文句なのかを判断したい創業者。エージェントを増やせばいいと言われて請求書を見たい経営層。組織図の神秘性抜きで「オーケストレーション」の意味を知りたい高校生ビルダー。前提条件:モデル呼び出しを2回連鎖させたことがあること。
グラフエンジニアリングの歴史と現在の担い手
[定義] A グラフ——離散数学で言う「ノード」と「有向エッジ」。ノードは作業単位(エージェント、ツール、チェック)、エッジは誰が誰に作業を渡せるかを示す。グラフエンジニアリングとは、この構造を自然発生に任せず、意図して設計すること。歴史とは、業界が「2つのチャットボットの会話」から「コンパイルされた実行グラフ」へと進化した道筋そのものだ。
| 時期 | ランドマーク | 担い手 | 何が変わったか |
|---|---|---|---|
| 2023-03 | CAMEL(arXiv:2303.17760) | Li ら(KAUST) | 2つのエージェントが人間抜きでロールプレイ会話を行う。「相手もモデルだったら?」への最初の広く模倣された回答。 |
| 2023-07 | ChatDev(arXiv:2307.07924) | Qian ら(清華大学) | ソフトウェア企業を、決まった順序で進む会話としてモデル化したもの。チャットチェーン によって、シーケンスそのものが成果物となる——スケジュールこそが設計そのものである、という最初の示唆を与えた。 |
| 2023-08-01 | MetaGPT(arXiv:2308.00352) | Hong ら | 標準化された業務手順をプロンプトのシーケンスとして組み込み、組立ラインのようにエージェントが "verify intermediate results and reduce errors"(訳:中間結果を検証し、エラーを減らす)。この段階で検証という概念がアーキテクチャに組み込まれる。 |
| 2023-08-16 | AutoGen(arXiv:2308.08155) | Wu ら、Microsoft | 会話パターンが文章ではなくコードとしてプログラム可能になる。2年間にわたり業界標準のマルチエージェント・フレームワークとなった。 |
| 2024-02 | More Agents Is All You Need(arXiv:2402.05120) | Li ら、Tencent | サンプリングと投票:エージェント数を増やすほどパフォーマンスが向上し、エージェント間の通信は一切ない。キャスト(配役)が本質ではないことを示す最も強力な論拠。 |
| 2024 | LangGraph(github.com/langchain-ai/langgraph) | LangChain | グラフがツールとして明示的に扱われるようになる:ノード、エッジ、そして各ステップ間で確認できる共有状態が導入される。 |
| 2025-03 | Why Do Multi-Agent LLM Systems Fail?(arXiv:2503.13657) | Cemri ら、UC Berkeleyおよび共同研究者 | これらのシステムに対する最初の失敗分類で、7つのフレームワークから注釈付きトレースを集めて構築された。マルチエージェントは「雰囲気」的なものから、具体的な欠陥が名前で呼ばれる実体へと変わる。 |
| 2025-04-09 | Agent2Agent protocol(developers.googleblog.com) | エッジがベンダー間のやりとりのプロトコルとなる。異なるフレームワーク上のエージェント同士が互いを発見し、タスクを委譲できるようになる。エッジはもはや単なるインポートではなく、インターフェースそのものとなった。 | |
| 2025-06-13 | How we built our multi-agent research system(anthropic.com/engineering) | Anthropic | プロダクション現場での詳細なレポート。内部評価での大きな成果と、それに見合うトークン消費倍率の両方を明らかにしている。 |
| 2026-08 | Graph Engineering in the Era of LLM Agents(arXiv:2608.21156v2) | Feng et al. | このパラダイムに名称を与え、5番目の位置づけとし、制約条件は認知的ではなく組織的なものだと論じている。 |
| 2026-09-04 | Inference-Time Graph Engineering(arXiv:2609.05774) | Tieu et al. | グラフのコンパイルと実行を切り分け、トポロジーを実行前に検査できるようにした。ここからコンパイラ時代が始まる。 |
[DESIGN] 見ておくべき点は三つある。第一に、この分野は2023年に「会話」を基本単位として始まり、3年かけてそれを「構造」へと置き換えてきた。CAMELは2人の話者、ChatDevは順序、AutoGenはパターン、LangGraphはエッジリスト、2026年の研究はコンパイラだ。第二に、検証は早い段階で登場する——MetaGPTは2023年8月に中間結果を検証している——が、その後マーケティングからほぼ姿を消す。これが今回扱うギャップである。第三に、表の最も鋭い実証的な結果は「そもそもグラフが不要かもしれない」というものだ。独立した回答をサンプリングし投票するだけで、エッジなしに性能がスケールする。
現在の主導者 フレームワークベンダー(LangGraph、AutoGen系統)が、エンジニアが実際に書く抽象化を担っている。モデルラボはプロダクションでの知見を公開し、Anthropicのレポートはマルチエージェントシステムの運用コストについて最も詳細な公開記録となっている。GoogleのA2Aは、エッジを2社間で共有できるものへと変えた。アカデミアは有意義な分業をしており、半分はパラダイムの体系化(Fengら)、もう半分はその壊れ方の計測(Cemriら、2026年のトポロジー論文)。まずは後者から読むことを勧める。
シリーズ全体を貫く比喩:キッチンのはしご
6つのエピソードすべてを1枚の図で示す。物語ではなく、実用的な道具として捉える。料理人はみな同じはしごを登る——自分のため、家族のため、レストランの厨房、ファストフードチェーン、そして複数チェーンを支える全国サプライチェーンへ。AIエンジニアも同様に、学校の学習者、ジュニア開発者、シニア開発者、AIテックリード、CTO、フロンティアリーダーと段階を進む。
今回のエピソードは全国サプライチェーンの段階にあたる。複数のキッチン、ひとつのスケジュール、ひとつのトラック隊。ここでの役割は、もはや自分で料理をしたり味見をしたりすることではない。どのデポがどのキッチンに出荷するか、どの出荷が棚に届く前に検査されるか、不合格のパレットをどう扱うかを決めることだ。全国規模の食品システムを運営する者で、運転手の肩書きや自己紹介が食品の安全性を左右すると考える者はいない。
| 段 | キッチン | あなたの役割 | 何をコントロールできるか |
|---|---|---|---|
| 1. プロンプト | レシピカード —— 自分のための料理 | 学習者 | 料理人が手にする手順書 |
| 2. コンテキスト | パントリー —— 家族のための料理 | ジュニア開発者 | 作業中にカウンターや冷蔵庫にあるもの |
| 3. ハーネス | レストランの厨房 | シニア開発者 | 各作業台、手の届くツール、すべての皿を確認するパス |
| 4. ループ | ファストフードチェーン | AIテックリード | 味を見て、測り、直し、その修正を全店舗に反映させる |
| 5. グラフ | 全国規模の供給網 —— 複数のキッチン、ひとつのスケジュール、ひとつのトラック群 | CTO | どの物流拠点がどのキッチンに、どんな順番で出荷し、途中で何が検査されるか |
| 6. 評価エンジニアリング | リコールログ | フロンティアリーダー | 食品システム全体が、どこで何が間違ったかから学ぶこと |
軸は一つではなく二つある。 これは登って終わりのはしごではない。どのキッチンにも六層すべてが常に同時に存在する。家庭の料理人にもレシピカードがあり、パントリーがあり、コンロがあり、味見があり、仕入れ先があり、前回の失敗の記憶がある。上に進むほど変わるのは、どれだけ多くの層に手を入れられるか、そしてそれぞれをどれだけ厳密に運用するか。最初は勘、次に計測、次にゲート、最後は自己修正。どんなに図が美しくても検査工程のない全国チェーンは、すべての皿を計量する一軒のレストランより未熟である。つまり分野は層(制御できるもの)、シニアリティは成熟度(運用の厳密さ)であり、グラフがループより自動的に高度ということはない。この誤解こそがここで最も高くつく。なぜなら、飾りのグラフは描くのが異様に簡単で、発表するのが異様に気持ちいいからだ。
この比喩は主張の導入には使えるが、証拠にはならない——すべての要素は下の1:1マップで実体に対応している。そしてエピソードの終盤で明らかになるのは、どの経路にも検査が入った完璧なスケジュールのシステムですら、その検査自体が本当に有効かどうかは分からない、という事実である。それがエピソード6だ。
このはしごも「グラフ」という言葉も、私の発明ではない
[定義] 用語は出典に結びつけておく——この段階は他のどの段よりも競合するラベル(オーケストレーション、マルチエージェントシステム、エージェントワークフロー、スウォーム、エージェント型メッシュ)が多く、その多くが構造ではなく配役に名前を付けている。
Feng らのサーベイ(arXiv:2608.21156v2、2026-08-26改訂、2026-09-11にarXivアブストラクトとして読了)は、この段より下の4つの段階を名指しした上で、この段階の必要性を論じている。その理由として挙げられているのは、五つの項目からなるリストであり、どれもパーソナリティではない:
"many tasks require heterogeneous expertise, interdependent subtasks, parallel execution, independent verification, and persistent state, exceeding any single agent's organizational capacity"(訳:多くのタスクは、異種の専門性、相互依存するサブタスク、並列実行、独立した検証、持続する状態を必要とし、いずれも単一エージェントの組織能力を超えている)
— Feng ら、2026年
異なる専門性、相互に依存するサブタスク、並列実行、独立した検証、永続する状態——いずれも構造の性質であり、どのノードが何を知り、どれを待ち、どれを検証し、何が間に残るかで決まる。調査ではこの到達点をSystem Intelligenceと呼び、こう定義している。"an agent system's ability to organize and coordinate multiple intelligent components into a coherent, adaptive whole pursuing a shared objective"(訳:エージェントシステムが複数の知的コンポーネントをまとめ、調整し、共通の目標を追求する一貫した適応的な全体として機能する能力)。単に人数を増やすだけでは到達できないことも明言されている。"Achieving it requires more than adding agents; it demands explicit structures to organize work, coordinate heterogeneous agents, and maintain evolving execution states."(訳:これを実現するにはエージェントを追加するだけでは不十分であり、作業を組織し、異種エージェントを調整し、進化する実行状態を維持するための明示的な構造が必要である)
そして調査が目指すものも、そのままこう記されている。"explicit, dynamic, evolving graph structures representing tasks, agents, and system states"(訳:タスク、エージェント、システム状態を表現する、明示的かつ動的で進化するグラフ構造)。タスク、エージェント、状態——三種類のノード。衣装(コスチューム)は一つもない。
[OPEN] この調査が述べていない点に注目したい。ここで扱う段階が前段階を置き換えるとも、グラフがループより優れているとも主張していない。あくまで原理・方法論・応用の地図であり、ベンチマークの結果ではない。これを「マルチエージェントがシングルエージェントより優れる証拠」として引用するのは、地図を測定値として扱うのと同じ誤りである。
主張の位置づけ
[DEF] 主張:マルチエージェントシステムではエッジこそが設計であり——誰が誰に、いつ、どんな状態を渡せるか——ペルソナは単なる衣装にすぎない。ペルソナはプロンプト内の文字列、エッジは何がどこに到達できるかという事実。システムを動かさずに確かめられるのはこの二つのうち一つだけだ。
[EVIDENCE] これを実感すべき最初の理由は、実際にこうしたシステムがどう壊れるかを誰かが体系的に記録したことだ。そしてその記録はキャラクター(役割)ではなく構造に関するものだった。Cemri ら(arXiv:2503.13657、2026-09-11時点のarXivアブストラクト、v3改訂2025-10-26)は、前提を当然視せず、冒頭でこう述べている:"Despite enthusiasm for Multi-Agent LLM Systems (MAS), their performance gains on popular benchmarks are often minimal."(訳:マルチエージェントLLMシステム(MAS)への熱狂にもかかわらず、人気ベンチマークでの性能向上はしばしば最小限である)
彼らが作ったのはデータセット——"1600+ annotated traces collected across 7 popular MAS frameworks"(訳:7つの主要なMASフレームワークから収集された1600件以上の注釈付きトレース)——そしてそのうち150件を人間アノテーターが精読して導かれた分類体系である。"validated by high inter-annotator agreement (kappa = 0.88)"(訳:アノテーター間の一致度が非常に高いことによって検証された(カッパ係数 = 0.88))。この結果、MASTが得られた:
"This process identifies 14 unique modes, clustered into 3 categories: (i) system design issues, (ii) inter-agent misalignment, and (iii) task verification."(訳:このプロセスにより、14の独立したモードが特定され、それらは3つのカテゴリにまとめられた:(i)システム設計上の問題、(ii)エージェント間の不整合、(iii)タスク検証)
— Cemri et al., arXiv:2503.13657
[DERIVATION] この3つの分類名は、エンジニアがスタックトレースを読むときのように捉えてほしい。システム設計上の問題 — 構造自体が誤っている。エージェント間の不整合 — エッジが誤った内容やタイミングで情報を運んでいる。タスク検証 — 誰もチェックしていない。「リサーチャーエージェントの好奇心が足りなかった」といったものは一つもなく、分類の最上位の3分の1はチェック不在そのものだ。
[EVIDENCE] 二つ目の根拠は、この段階で最も率直なプロダクション報告である。Anthropicによる自社マルチエージェント研究システム(2025-06-13)の記述は、大きな成果を示している:"We found that a multi-agent system with Claude Opus 4 as the lead agent and Claude Sonnet 4 subagents outperformed single-agent Claude Opus 4 by 90.2% on our internal research eval."(訳:Claude Opus 4をリードエージェント、Claude Sonnet 4をサブエージェントとしたマルチエージェントシステムが、シングルエージェントClaude Opus 4に対し、社内リサーチ評価で90.2%上回った) 実システムから得られた具体的な数値であり、その範囲も文中で明確に示されている:1つの社内評価、1つのリード+サブエージェント構成、1つのモデルファミリー。
そして同じ投稿で、ほとんど誰も触れないコスト面についても明記されている:
"In our data, agents typically use about 4× more tokens than chat interactions, and multi-agent systems use about 15× more tokens than chats."(訳:我々のデータでは、エージェントは通常チャットの約4倍、マルチエージェントシステムはチャットの約15倍のトークンを消費する)
— Anthropic, 2025-06-13
[DERIVATION] 15倍というのは誤差の範囲ではなく、実質的にもう一人雇うのと同じ負担だ。この2つの文を並べて読むことで、この段階が本当に問うているのは「マルチエージェントの方が優れているか」ではなく「このタスクはチャット15回分の価値があるか」だ。。キャストリストではこの計算を求められることはないが、エッジリストなら必ず直面する。なぜなら、エッジはすべてメッセージであり、メッセージはすべてトークンだからだ。
[EVIDENCE]三つ目の根拠は、反証として十分に強力で、このエピソードが脚注で済ませず正面から向き合わざるを得ないものだ。LiらによるMore Agents Is All You Need(arXiv:2402.05120)は、多数の回答をサンプリングし多数決を取ることで、エージェントを増やすほど性能が向上することを示している——調整も役割もエッジも一切なし。もしこれが本質なら、この段階で多くの人が作っているものの大半は、forループとカウンター
で得られる結果のための過剰な仕掛けに過ぎない。The Interaction Tax(arXiv:2608.23541, 2026-08-24)は、予算を揃えたうえで11個の検証付き最適化タスクをテストし、エージェント同士の会話が、せっかく複数モデルを使った意味を台無しにすることを発見した:"when agents read each other's complete outputs, their proposals converge within one round, erasing the diversity that motivates using multiple models"(訳:エージェントが互いの出力全体を読むと、提案が1ラウンドで収束し、複数モデルを使う動機となる多様性が消える)。彼らの結論は、このエピソードの主張を逆方向から突きつけている——"multi-agent performance depends less on the number of agents than on the information they exchange"(訳:マルチエージェントの性能は、エージェント数よりも彼らがやりとりする情報に左右される).
[DERIVATION]この二つの論文を通して残るのはこういう原則だ。エージェントを増やしても安定して良くなるとは限らず、会話を増やすと逆に悪化することもある。効くのは、どのエッジをいつ何が通るかを設計し、出口に独立した検証を置くことだ。投票付きの独立サンプリングは、クロストークのないファンアウト+アグリゲータとして、十分にまともなグラフである——もし安価な検証者で済むなら、それが最良のグラフかもしれない。これはエッジの設計に関する判断であって、「誰がクリティックか」という配役の問題ではない。
1:1 技術対応表
この比喩の各要素は、コード上で具体的に指し示せるものに1対1で対応している。
| サプライチェーン | システム | どこに存在するか |
|---|---|---|
| デポ、キッチン、ラボ | ノード——作業単位 | 関数・エージェント・ツール呼び出し |
| 時刻表上の経路 | 有向エッジ(誰が誰に仕事を渡せるか) | エッジリストの1行 |
| 時刻表全体 | スケジュール(グラフ全体) | edges: list[tuple[str, str]] |
| トラックに積まれている荷物 | メッセージのペイロードと共有状態 | エッジを通して受け渡す型付き状態オブジェクト |
| 棚に並ぶ前の検品工程 | 検証ノード | マージされた状態に対する決定的なチェック |
| "no pallet reaches a shelf uninspected"(訳:どのパレットも検品なしに棚に届くことはない) | リーチャビリティ不変条件 | unverified_path_share == 0.000 |
| 日曜にデポが通るショートカット経路 | バイパスエッジ | エッジリストに1つ追加されたタプル |
| 運転手の職名(マニフェスト記載) | ペルソナ用の文字列 | どの遷移からも参照されないプロンプトフィールド |
| 1回の配送で消費する燃料 | トークン乗数 | メッセージ数 × ペイロードサイズ |
| 前のデポと同じ動きを繰り返すデポ | 同調性の罠 — 多様性の崩壊 | フル出力エッジにおけるインタラクション・タックス |
[定義] このエピソードで軸となる三つの指標を、ここで一度だけ定義しておく。
- エンドツーエンド誤り率 — N回の同一実行で、出力のいずれかのフィールドが誤っている割合。
- コスト — 1回の実行あたりのメッセージ数とトークン数。エッジは無料ではなく、コストを無視したトポロジ比較は単なる宣伝でしかない。
- 未検証パス比率 — ソースから出力までの全ての単純パスのうち、検証ノードを通らない割合。グラフだけから計算できる:サンプリングもモデルもシードも不要。
三つ目がこのエピソードの貢献だ。最初の二つはサンプリングで決まり、モデルや温度や運に左右されるが、三つ目は決定的に判定できる。だからこそCIに組み込む意味があり、他の二つはダッシュボードに載せておけば十分である。
予測ゲート
スクロールする前に自分の予測を記録してほしい——記録しなかった予測は、後で当たった気になってしまう。
四人の専門ワーカーが四つのフィールドをそれぞれ担当する。全パラメータは予測前に明示する:ワーカーごとの破損率 0.15・中継破損率 0.05・マージ破損率 0.05・検証ノードのリコール 0.85・1フィールド1メッセージあたり40トークン。三つの構成:スター型(ハブが委譲とマージを行い、マージ時に一つのフィールドを破損しうる)、チェーン型(各段階が自身のフィールドを書き、上流の全てを中継)、DAG型(四人のワーカーが検証ノードに集約されてから出力される)。
Q1. この三つをエンドツーエンド誤り率で、悪い順に並べてみてほしい。そのうえで、最良と最悪の差がどれくらいになるか予想してほしい。
Q2. 同じ三つを1回あたりのトークン数で、最もコストが高い順に並べてみてほしい。
Q3. 次にDAG型で、検証ノードの位置はそのまま、四人目のワーカーから出力へ直結するエッジを追加する——レイテンシ短縮のために誰かが加えるショートカットだ。これで四つのうち一つのフィールドが検証をスキップする。このときエンドツーエンド誤り率はどうなるか:おおよそ倍になるか、それ以上か?
答えはノートブックとFailure Roomに記載してある。Q1でチェーン型が中間だった場合は、ラボを実行して確認してほしい。
Failure Room(失敗実験室)
意図的に壊す——壊せない仕組みは、ただの主張にすぎない。
失敗1 — キャスト(配役)が設計になっている。 五人のエージェントに肩書きを付けて、アーキテクチャが完成した気になる。しかし、実行時の遷移は肩書きには一切依存しない。ルーターはグラフを、アグリゲータは状態を、チェックはフィールドを読む。自分自身の専門家パネル研究でも心理学的に検証したが、ペルソナラベルは162役割・2,410問で事実精度を改善しなかった。効果があったのは、エージェントを人物のコーパスに根ざさせることであり、説明文ではなかった。コーパスはデータ、コスチュームは単なる文字列でしかない。One Opinion Wearing Ten Hats に詳述してある。
Failure 2 — 技術的には存在している検証ノード。 この記事で最も重要なのがこれだ。ラボでは、ゲート付きDAGと、バイパスエッジを1本追加した同じDAGの両方に検証ノードが含まれており、どちらも「チェック工程はあるか?」という査読には形式上は通る。だが、バイパスされた方は 0.240 エンドツーエンド誤差で 0.080 — N=100で約2〜3倍悪化し、期待値で2.4倍。同じ640トークンを消費しているのは、チェックが他の3フィールドには依然として実行されているからだ。検査コストは支払っているのに、1経路だけ検証を素通りしてしまう。静的な指標はこれをマイクロ秒で検出する:unverified path share 0.000 → 0.200。サンプリングによる指標も、最終的にはN=100でこれを捉える。
Failure 3 — 見た目が整ったチェーン。 ラボで最もコストが低いトポロジー(400トークン、starは480、DAGは640)が、実は最悪で0.580となる。フィールド1は0.15で一度書かれ、その後0.05で3回リレーされるので、最後のフィールドの1回に対して4回も壊れる機会がある。エラー伝播はワーカーの性質ではなく、トポロジーが値を何度再処理させるかで決まる。
Failure 4 — 合意と見なされる同調。 エージェント同士の会話を増やすと、意見の相違が消え、進歩したように見えて実は逆になる。全員が互いの出力を完全に読むと、提案は1ラウンドで収束し、多様性が消える。自作のディナーパーティープロジェクトでは、ペルソナだけのチャットは224件の横断的な衝突のうち50件しか検知できず、見逃したものも難しくなかった。3人の専門家がクルミ入りデザートに全会一致で賛成した。合意は完璧だった。アレルギーも同様に。
Failure 5 — 0.000で意味をなさない指標。 unverified path shareを0.000にするには、検証ノードに True を返させればよい。Episode 1の決定性指標が空オブジェクトで1.000になるのと同じ構造だ:到達性不変条件は必ずアウトカム指標と並べて報告すべきで、単独では意味を持たない。ゲートはチェックが 経路上に存在する ことだけを示す。チェックの質については何も語らない——それがまさにEpisode 6の論点である。
Q3への答え: このケースではほぼ3倍になる(0.080 → 0.240);ラボのパラメータでは期待値0.206、約2.4倍。いずれにせよ重要なのは仕組みそのものだ。バイパスされたフィールドの破損は、確率0.15ではなく確実に残る。4分の1の経路で回避されるゲートは、ゲートの75%分の効果とは言えない。
ノートブック
Lab 05 — スケジュール、ペルソナではない。 
05_graph_schedule.ipynb · Colab無料枠 · APIキー不要 · 数秒のCPU · すべてのセルは公開前に実行済み、以下の数値はその出力そのもの。
8つのセル。 Graph オブジェクトはノード、エッジ、出力ノード、そしてオプションで検証ノードを保持する。4つのトポロジーの違いはそれだけだ。
parameters: per-worker corruption 0.15 · relay corruption 0.05 · merge corruption 0.05
            verifier recall 0.85 · 40 tokens per field per message · 4 fields

topology                            err    msgs   tokens  paths  unverified
star (hub + 4 workers)            0.510     9.0      480      4       1.000
chain (4 stages)                  0.580     4.0      400      1       1.000
DAG + verifier                    0.080    10.0      640      4       0.000
DAG + verifier, 1 bypass edge     0.240    10.0      640      5       0.200

  orphaned output   -> RAISES: no path reaches 'OUT' — the graph is
                       disconnected, not verified
[EVIDENCE] 驚きの順に三つ挙げる。
一番安いトポロジーが最悪だった。 チェーンはスターとDAGの中間だろうと予想していたが、実際はどちらよりも悪く、しかもメッセージ数も少ない。
バイパスエッジはコストゼロで、すべてを壊す。 トークン数は同じ、N=100でエラーは約2〜3倍。ショートカットは効率化の理屈すらなく、メッセージすら減らない。だからこそ、「少しだけレイテンシを削って正しさを大きく損ない、誰も測らない」現実の典型例をそのまま抽出したモデルになる。
ゲートは地味だが、それが肝心だ。 セル5は4つのグラフすべてにリーチャビリティチェックをかけ、CIが使う終了コードを出す:マイクロ秒、呼び出しゼロ、完全な決定性。4つのうち2つは1回も実行される前に落ちる。さらに、出力に誰も到達しない5つ目のグラフは、0.000を返すのではなく、チェックが例外を投げる。
セル6のスイープは必見だ。バイパスされたグラフが、問題が難しくなるほどガードされていない側の挙動をなぞることが分かる。
| ワーカーごとの破損率 | スター | チェーン | DAG+検証ノード | + バイパスエッジ |
|---|---|---|---|---|
| 0.05 | 0.220 | 0.410 | 0.030 | 0.070 |
| 0.10 | 0.370 | 0.480 | 0.080 | 0.180 |
| 0.15 | 0.510 | 0.580 | 0.080 | 0.240 |
| 0.20 | 0.580 | 0.630 | 0.150 | 0.280 |
| 0.30 | 0.760 | 0.800 | 0.160 | 0.460 |
ゲート付きの列だけがほぼ横ばいで、他はすべて上昇する——これは構造そのものを直した証拠であり、応急処置ではない。一つのノイズレベルだけで測っていると、こうした違いは見えない。
[DESIGN] セル7は直球だ。run_dag は personas 引数としてSenior Chef、Michelin Inspector、Nutritionist、Logistics Leadを渡し、それぞれ4人のワーカーに紐付けて状態に持たせた——セルはそのdictを出力するので、確かに役割名が載っていることが分かる。エラー率もトークン数も、きっかり0.000しか動かなかった。理由は言い訳ではなく、まさにこの発見だ:その関数のどの行も役割名で分岐しない。 振る舞いがグラフで決まるシステムでは、コスチューム(役割名)が入り込む余地はない。これは言語モデルの性能測定ではなく、因果の矢印がどこに生じるかの実演だ。肩書きは組織図にだけ残る。
[DESIGN] なぜスタブなのか。シミュレータなら、どこでエラーが入り、何がそれを除去するかを数秒・無料・キー不要で再現できる。ただし、ない 規模の再現性について:ここで出力される数値は、Anthropicの90.2%やMASTの結果そのものを示すものではない。セル8は橋渡し役であり、コイン投げをモデル呼び出しに置き換えても、Graph、ゲートと三つの指標は変わらない。設計上、これらはモデルに依存しないからだ。
プロジェクト
ゼロから作った2つのビルド。フレームワークは使わず、標準ライブラリのみ。どちらもシード済みで、このセクションを書く前に実行している。ノートブックのgistにも収録。
プロジェクト1 — 実生活編:the-dinner-party
p1_dinner_party.py · python3 p1_dinner_party.py 100
6人分のディナー。ゲストのうち1人はヴィーガン、1人はナッツアレルギー、予算は80ドル、オーブンラックは1つ、着席は19時。3つの専門スタブがそれぞれ計画の一部を担当する——agent_menu料理選定、agent_shoppingバスケットの価格決定、agent_timingオーブン割り当て——そして誰も他の出力を見ない。それぞれは個別に正しく自信もあるが、失敗はその間に生じる。5つの検出ルールは2人の専門家の事実が必要であり、だからこそどの専門家も単独で所有できない——それが構造的な理由だ:
allergen  needs  menu + the guest list      a dish contains nuts
diet      needs  menu + the guest list      the main is not vegan and one guest is
budget    needs  menu + shopping            the basket cleared $80
oven      needs  menu + timing              two dishes want the single rack at once
timing    needs  menu + timing              a dish finishes after people sit down
[EVIDENCE] 2つのアーム、専門家もシードも同じ。アームAはペルソナだけのチャット:順番に話し、次の人が異議を唱えることもある。アームBは1つのスケジュールと検証ノード:全員が共有状態に書き込み、1つのチェックノードが5つのルールを実行する。
conflicts present            : 224
caught by persona-only chat  : 50    (0.223 recall)
caught by schedule+verifier  : 224   (1.000 recall — by construction, see below)

dinners served with an unresolved conflict
  persona-only chat          : 85/100  (0.850)
  schedule + verifier        : 0/100   (0.000)

by rule: allergen 83 · oven 74 · timing 36 · diet 22 · budget 9
[OPEN] ここで証明されないこと:チャットアームの気付き確率は私が0.30に設定したパラメータで、3つの自信満々な段落に同調し異議を唱えない傾向を模している。これはどのモデルの測定でもなく、0.223という数値もそのパラメータの産物にすぎない。構造的な本質は、2人の専門家の事実が必要なルールには、グラフが割り当てるまで所有者がいないこと。誰の職務にも「自分の出力と他人の出力の相互作用」は書かれていない。そしてスケジュールアームの1.000は設計上1.000になる:検証ノードは衝突を定義する同じ5つのルールを実行するので、1つも見逃さない。この測定値が示すのはチャットアームの損失であり、検証者の腕前ではない——Failure 5で警告した空虚な指標そのものであり、ここで開示するのは自分の手によるものだからだ。
プロジェクト2 — エンタープライズ編:the-incident-room
p2_incident_room.py · make gate · make bypass · make measure
インシデント対応グラフ:
page → triage → diagnose → mitigate ─┐
                └────────→ rollback ─┼→ check → resolve
triage → comms ───────────────┘この不変条件を一文で表すと:どのノードからresolveへの経路もcheckをスキップしてはならない。これはグラフの性質であり、実行の性質ではない。単純経路を列挙して判定する——モデル呼び出しもサンプリングも揺らぎも不要。自分の研究用ハーネスで使っているモジュール到達性ルールと同じ構造だが、未公開なので実践例として挙げる(引用ではない)。
$ make gate
  paths to 'resolve'        : 3
  paths that skip 'check'   : 0   (share 0.000)
  invariant: every path to 'resolve' crosses 'check' -> HOLDS     exit 0

$ make bypass          # after adding ("rollback", "resolve")
  paths to 'resolve'        : 4
  paths that skip 'check'   : 1   (share 0.250)
    BYPASS: page -> triage -> diagnose -> rollback -> resolve
  invariant: every path to 'resolve' crosses 'check' -> VIOLATED  exit 1
[EVIDENCE] ゲートは「どこかが壊れている」ではなく、経路を名指しする——壊れたビルドを誰かが直すか、誰かが無効化するかの違いだ。N=100のシード付きインシデントで、チェックノードが持つ4つのクロスフィールドルール:
                                            gated     + one bypass edge
rule violations raised (all runs)              63                    63
incidents blocked at the check node   52/100 (0.520)        37/100 (0.370)
INCIDENTS RESOLVED WHILE DIRTY         0/100 (0.000)        15/100 (0.150)
最初の行は違反数、他の2行はインシデント数を数える——1つのインシデントが複数の違反を生むことがあるので、列同士は単純な引き算にならない。スタブもプロンプトもペルソナも両列で同一。1本のエッジが変わっただけで、100件中15件のインシデントが未修正の違反でクローズした——モニターがグリーンでない、収益経路の障害なのに顧客連絡なし、根本原因もロールバックもなし。そのバイパスエッジこそ、日曜3時に本当に正当な理由で現場エンジニアが追加し、3月になってもリポジトリに残っているものだ。
30分で構築——その約束
ゲートに必要な要素を、エンジニアが順に確認する通りに並べる。
INPUTS   edges: list[tuple[str, str]]     # the whole schedule, as data
         output:   str                    # the node that ends the run
         verifier: str                    # the node every path must cross

OUTPUT   unverified_path_share: float in [0, 1]
         offending_paths: list[list[str]]  # named, not counted

INVARIANT   unverified_path_share == 0.000

STOP RULE   the gate never retries and never repairs.
            It refuses, and prints the path. Repair is a human's job.

def unverified_share(edges, output, verifier):
    paths = simple_paths_to(edges, output)       # every source → output
    if not paths:                                # a graph nothing reaches is not verified
        raise ValueError(f"no path reaches {output!r} — the graph is disconnected, not verified")
    return sum(1 for p in paths if verifier not in p) / len(paths)

# CI gate (make gate)
#   unverified_path_share == 0.000   → exit 0
#   anything above                   → exit 1, printing each bypass path
意図的な未実装——なぜなら、それを省くこと自体が設計だからだ。たとえば:サイクル(ウォーカーがノードを再訪しないため、リトライループを入れるなら「パス」の定義を明確にしなければゲートできない)、実行時にエージェントが自分でエッジを追加して再配線する場合(実行中に変化するスケジュールには別の不変条件が必要)、検証ノードの正しさそのものへの判断、どのパスからも到達しない出力(ゲートは切断グラフでは0.000を返さず例外を投げる。素朴なゼロだと壊れたグラフに合格を出してしまう)、そして実際のモデル呼び出し——スタブを本物に差し替えてもゲートの仕組みは変わらない。なぜならゲートは実行結果を一切参照しないからだ。
[DESIGN] この4つの特徴が、これを単なるデモではなくエンタープライズ向けにしている。それぞれに意味がある:
- スケジュールはデータであり、コードの呼び出し経路ではない。 エッジリストはプルリクエストで差分比較できる。どの関数がどれを呼ぶかで暗黙的に決まるグラフではそれができず、ショートカットが気付かれずに紛れ込む。
- 不変条件は静的なので、すべてのコミットで安価にチェックできる。 モデルコールが必要なチェックは、最初は毎晩、次第に毎週、やがて誰も回さなくなる。
- ゲートが特定するのは「件数」ではなく「パス」そのものだ。 「Unverified share 0.250」は議論の余地がある数値だ。
page → triage → diagnose → rollback → resolveは、誰かが修正すべき具体的な経路を示す文になる。 - クロスフィールドのルールはチェックノードに集約される。 2人のエージェントの事実が必要なルールは、両方のエッジが到達するノードに置く。エージェントのプロンプトに書けばそれはそのエージェントの意見だが、グラフに書けばそれはシステム全体の前提条件となる。
[OPEN] どちらのプロジェクトも証明していないこと:どちらのワーカーセットもスタブ、どちらのゴールデンセットも合成データだ。エンタープライズ構成の正直な現状は「実行可能かつゲート済み」 であり、「本番運用・実測済み」 ではない。本当に現場で使えるものにするには、実際に使っているフレームワークから本番のオーケストレーショングラフをエクスポートし、同じゲートをかけて初日にバイパス数を報告すること——私の事前予測として、ほとんどの本番グラフには少なくとも1本バイパスがあり、誰もそれに気づいていないはずだ。
同じ構造、出口は5通り
一つの軸に、読者ごとの出口。ひとつ決断し、ひとつ行動を選べ。
| あなたが | このエピソードで問う意思決定 | 今週ひとつだけ実践すること |
|---|---|---|
| 高校生ビルダーの場合 | 「マルチエージェント」は配線図であって、登場人物リストではない。設計対象はエッジそのものだ。 | Colabラボ(APIキー不要、数秒)を動かし、自分のプロジェクトを箱と矢印で図示する。チェックを経ずに答えに到達する矢印はすべて丸で囲む。 |
| AIエンジニアの場合 | リーチャビリティ不変条件は、ビルドが自前で持てる静的チェックだが、エラー率はそうではない。 | 自分のオーケストレーショングラフをエッジリストとして出力し、12行のゲートを通してみる。バイパス経路の数も出す(たとえ見栄えが悪くても)。 |
| ファウンダーの場合 | マルチエージェントはチャット約15回分のコストがかかる。問うべきは「そのタスクが15チャット分の価値があるか」であって、「アーキテクチャが最新か」ではない。 | システムのタスクごとのトークン消費量と勝率を並べて出してもらう。どちらか一方だけでは判断材料にならない。 |
| エグゼクティブの場合 | 「レビュー工程はあるか?」ではなく、「どの経路でもそれを通らずに出力へ到達できるか?」が本質的な問いだ。 | 次回のアーキテクチャレビューで「unverified path share(未検証経路率)」を加え、図ではなく失敗したビルドの実例を見せてもらう。 |
| 投資家の場合 | ペルソナのキャストリストは参入障壁にはならないが、CIでゲート付き・計測されたスケジュールなら壁になる可能性がある。 | どんなエージェント系スタートアップにも、エッジリストとゲートの実装を見せてもらう。もし答えがエージェントの組織図なら、それが現実だ。 |
リアリティ・ミッション
15分、すでに運用している自分のシステムで。
- モデルコールが2回以上ある自分のシステムを一つ選び、ノード名のペアだけでエッジリストを書き出す。もし書けなければ、それ自体が発見だ——グラフは存在しているが、記述されていないだけ。
- 出力ノードと検証ノードに名前をつける。検証ノードがなければ、そこで止まり追加する。以下はすべて「到達できるかどうか」の話で、「良いかどうか」ではない。
- すべてのソースから出力までの単純経路を列挙し、検証ノードを通らない経路の数を数える。それが unverified path share(未検証経路率)だ。
- 各バイパス経路について、誰が・なぜ追加したかを調べる。理由は必ずあり、しかも必ず「正当な理由」なので、今後も繰り返し起きる。
- チェックをCIに閾値ゼロで組み込む。その後、意図的にバイパスエッジを追加し、ビルドが赤になることを確かめる——一度も失敗しないゲートは、存在しないのと同じだ。
ステップ1でノードが1つだけ見つかったなら、あなたはまだこの段階にはいないし、進む必要もない。エピソード4に戻り、まずはそのループをきちんと計測可能にせよ。しっかり測定されたループは、どんなに見栄えの良いグラフよりも常に強い。このエピソードの問いは、あなたが実際にどちらを作ったのか、という一点に尽きる。
リサーチチャレンジ
この課題をエージェントに渡し、予測を事前に登録せよ。
出力に検証可能なタスクを1つ選び、専門分野の異なる4人のワーカーを用意する。ワーカー、プロンプト、役割名はすべて固定し、トポロジーだけを変える:スター型、チェーン型、独立サンプリング+多数決、そしてすべての経路が検証ノードを通るDAG。各構成ごとに、エンドツーエンドのエラー率、1回あたりのトークン数、未検証パス率を、ワーカーのノイズレベル3段階で測定・報告せよ。さらに、ゲート付きDAGにバイパスエッジを1本追加し、同じ3指標を再度計測せよ。
事前登録: 独立サンプリング+多数決が、検証コストが低い場合に検証付きDAGを上回るかどうか、また4つのトポロジーの順位がノイズレベルを変えても安定するか、それとも逆転するか。
私の予測(あなたが実験する前に記録):サンプリング+投票はコストで勝つが、不変条件では負ける。投票が検証になるのは、多数派が正しい場合だけだ。どこかに「安い未検証トポロジーが高価な検証付きトポロジーを、裾野を無視した指標で上回る」交点が必ず存在する。それを実タスクで見つけたなら、このエピソードへの立派な反論になり、それはあなたのセットアップのバグではない。
最新動向
この段階の現状は、30の先駆的な情報源を毎週技術的な信号強度でのみ順位付けし、オーディエンス規模は一切考慮せずにライブ同期したものからまとめている。research-anything (make watch-syncすべての項目は、同期日にarXivのアブストラクトページとして取得し、精読した。
同期日:2026-09-11。
- arXiv:2609.05774 (2026-09-04) — Inference-Time Graph Engineering for Multi-Agent LLM Workflows(Tieuら)。クエリとエージェント群を、推論段階ごとに指示付きの有向通信グラフ列へとコンパイルする。各エッジには「何を流すか」の指示が載る。彼らの結論は、このエピソードの主張を一文で要約している:"effective multi-agent orchestration depends not only on which agents communicate, but also on engineering executable workflow graphs that encode when, why, and how information should flow during reasoning"(訳:効果的なマルチエージェントのオーケストレーションは、どのエージェントが通信するかだけでなく、推論中に情報が「いつ・なぜ・どのように」流れるべきかを記述した実行可能なワークフローグラフを設計することにも依存する).
- arXiv:2608.23541 (2026-08-24) — The Interaction Tax: When Communication Erases Diversity in Multi-Agent Teams(Ann、Liu、Tan)。11種の検証者付き最適化タスクを同一予算下で評価。全出力の相互参照は弱いデフォルトとなり、独立した提案生成は多様性崩壊を回避する。この段階自体の存在を否定する最強の反証であり、本記事がサンプリング+投票をストローマンでなく正当なグラフと扱う理由でもある。
- arXiv:2608.21156v2(2026-08-26改訂)— Fengらによるサーベイ。この段階と本シリーズの軸となる出典。第5のパラダイムを組織論的観点から主張し、認知論的ではない。
- arXiv:2608.12921v2 (v1 2026-08-13, v2 2026-08-14) — Discovering Efficient and Explainable Communication Topologies … via Causal InferenceLiらは「どのエッジが本当に効いていたか」を因果的に特定し、各チャネルをマスクして結果の変化を測定し、不要なエッジを削る。2年前までは「どのエージェントを雇うか」が主題だったが、この論文は「どのエッジを外すか」を問うている。
[OPEN]ここで変わっていない点を述べる。ない——到達可能性のような構造的不変条件を、エージェントグラフ向けのCIゲートとして実際に導入・運用している事例は見つからなかった。2026年の論文群はエッジの最適化・説明・削減に取り組み、フレームワークはグラフの描画を可能にしているが、「検証ノードを通らずに出力へ到達する経路がある」ことでビルドが落ちる例は見当たらない。このゲートが別名で存在するなら、私はまだ発見できていない——浅い調査で新規性を装うより、そう明言しておく。
出口テスト
スクロールせずに自分で考えてみてほしい。
- Fengらが「単一エージェントの組織的能力を超える」と述べた5つの要素を挙げよ。そのうち性格的な特性はいくつあるか?
- MASTは14の失敗モードを3つのカテゴリに分類している。それぞれ何か、そしてキャストリストでは絶対に解決できないのはどれか答えよ。
- Anthropicは90.2%の性能向上とトークン乗数の両方を報告している。乗数とは何か、それは単なる勝率報告では判断できないどんな意思決定を迫るか?
- なぜ「未検証経路シェア」だけが、ラボの3つの指標のうちCIに組み込むべき唯一のものなのか?
- あるシステムは検証ノードを持つのに、ゲート付きバージョンが0.080のところ0.240を記録した。この欠陥は何か、またサンプリング指標と静的指標のどちらがより早くそれを検出できるか?
- この段階自体が不要だという最強の反証と、それをより明確にした2026年の論文を挙げよ。
クリフハンガー
君はスケジュールを描く。
すべてのノードに名前を付け、エッジは意図して引き、出力へのすべての経路が必ずチェックを通る。ゲートはCIでゼロを維持し、誰かが日曜夜のショートカットを加えると90秒でビルドが赤くなり、経路名が表示される。クルミのタルトはテーブルに届かない。
だがある週、チェックノードが本来出荷されるべきでなかったものを承認してしまう。
バイパスされたからではない。それは実行され、マージされた状態を読み、すべてのルールを適用し、「はい」と返したからだ。
ルールを見直す。すべてまだ存在し、すべてまだ通過する。そして気づく——このラダーのすべて、仕様もパントリーも封筒もループもスケジュールも、「正しさ」の基準を誰も測ったことのないたった一つの場所から借りてきていたのだと。さらに厄介なのは、一度その基準で測り始めると、上流のすべてがその基準に最適化し始める——君がそう指示していない部分まで。
エピソード6——リコールログ。評価エンジニアリング:他のすべてのレイヤーが拝借している「真理関数」とは何か、システムの本当の成熟度は「壊れて戻ってきたもの」からどう学ぶかで決まる理由、そして「評価」はターゲットであり——そのターゲットは、まさにそれを達成するために作ったシステム自身によって攻略されうるという不都合な事実。
次に読む
エピソード5:インテリジェンス・エンジニアリング・アドベンチャーズ シーズン7 — キッチンラダー。主張には「定義」「導出」「証拠」「工学的選択」「未解決問題」のタグが付く。メタファーは主張の導入には使えるが、証拠にはならない。各エピソードにはColabノートブック(無料・APIキー不要)と、標準ライブラリだけでゼロから作った2つのアプリ(個人用・エンタープライズ型)が必ず付く。最初の5段はFengら(arXiv:2608.21156)によるもので、6段目の評価エンジニアリングだけが本シリーズ独自の提案であり、エピソード6で論じる。「What moved」は30の先駆的な情報源を毎週技術的な観点で同期し、決してオーディエンス規模では並べない。この論考には雇用主やクライアント由来の素材は一切含まれていない。— Paul Jialiang Wu · futuremake.io
参考文献
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. ほか (2026)。LLMエージェント時代のグラフエンジニアリング:個別知能からシステム知能へ。 arXiv:2608.21156、v1 2026-08-21、v2 改訂 2026-08-26。— アーティファクト読了:arXivアブストラクトページ、2026-09-11。 「ラダーは私のものではない」内4つの引用の出典。
- Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A. ほか (2025)。Why Do Multi-Agent LLM Systems Fail?(なぜマルチエージェントLLMシステムは失敗するのか) arXiv:2503.13657、v1 2025-03-17、v3 改訂 2025-10-26。— アーティファクト読了:2026-09-11時点のarXivアブストラクトページ(v3)。 MAST引用元。1600件超・7フレームワーク横断のトレースとkappa=0.88。引用した数値はすべてアブストラクト由来で、カテゴリ別の割合はPDFのみ(本記事では未引用)。
- Anthropic(2025-06-13)。How we built our multi-agent research system. anthropic.com/engineering. — アーティファクト読了:2026-09-11時点のライブ投稿。 90.2%の文と4×/15×トークン倍率の文、いずれも原文引用の出典。
- 2023年の歴史表ランドマークは、すべて2026-09-11にarXivアブストラクトページで確認し、特記なき限り引用ではなく記述:Li, G. ほか、CAMEL (arXiv:2303.17760、v1 2023-03-31);Qian, C. ほか、ChatDev (arXiv:2307.07924、v1 2023-07-16);Hong, S. ほか、MetaGPT (arXiv:2308.00352、v1 2023-08-01 — “verify intermediate results and reduce errors”(訳:中間結果を検証し、エラーを減らす)の引用元);Wu, Q. ほか、AutoGen (arXiv:2308.08155, v1 2023-08-16).
- Li, J., Zhang, Q., Yu, Y., Fu, Q., Ye, D.(2024)。More Agents Is All You Need. arXiv:2402.05120、v1 2024-02-03。— 反証:サンプリングと投票はエージェント数でスケールし、エッジを必要としない。
- Ann, S. E., Liu, H., Tan, C.(2026)。The Interaction Tax: When Communication Erases Diversity in Multi-Agent Teams. arXiv:2608.23541(2026-08-24)— ダイバーシティ崩壊とパフォーマンスの決定要因に関する2つの引用元。
- Tieu, K., Fu, D., Xia, Y., Li, H., Yan, H., He, J.(2026)Inference-Time Graph Engineering for Multi-Agent LLM Workflows. arXiv:2609.05774(2026-09-04)— “when, why, and how information should flow during reasoning”(訳:推論時に情報がいつ・なぜ・どのように流れるべきかをエンコードする実行可能なワークフローグラフの設計が重要である)という引用の出典(「What moved」節)。
- Li, J., He, P., Ji, Q., Wang, W., Liu, L., Sun, C.(2026)Discovering Efficient and Explainable Communication Topologies for LLM-based Multi-Agent Systems via Causal Inference. arXiv:2608.12921, v1 2026-08-13, v2(2026-08-14時点で参照)— エッジ単位の因果帰属と選択的削除について。引用なし。
- ツールとプロトコル(2026-09-11時点で確認):LangChainのLangGraph (github.com/langchain-ai/langgraph(グラフをツール群の中で明示的なデータ構造として扱う);GoogleのAnnouncing the Agent2Agent Protocol (A2A), 2025-04-09 (developers.googleblog.com、仕様はa2a-protocol.org).
- 他の段のシリーズ表ランドマーク:Anthropic、Building Effective AI Agents, 2024-12-19 (anthropic.com/engineering、Dhage, S.,Harness Engineering for Predictable Agentic Systems (arXiv:2608.26197(2026-08-25)、エピソード1の主要な測定指標。
- Wu, P. J. One Opinion Wearing Ten Hats. futuremake.io(2026-08-06)。— ペルソナ・パネルを自ら測定:162役割・2,410問でペルソナ有無に差はなく、「コーパスはデータ、コスチュームは文字列」、さらに同調性ゲートの効果も検証。
- Lab 05および両プロジェクトは公開前にすべて実行済み:public gist — ノートブック、
p1_dinner_party.py,p2_incident_room.py、両README、Makefile。本記事の数値はすべてこれらの実行結果に基づく。