AI-Native 系列 · 可解释性与对齐,第一集(共五集)
可解释性:模型写下的,不等于它算出来的
五集系列,讲 AI 可解释性与对齐:我们现在能读懂语言模型哪些内部细节,哪些还无法控制,以及为什么它写下的推理不能作为它真实推理的证据。本集内容:2025–26 年的四项测量、一份带拒绝机制的主张账本,以及它拒绝了我自己的一次修正。
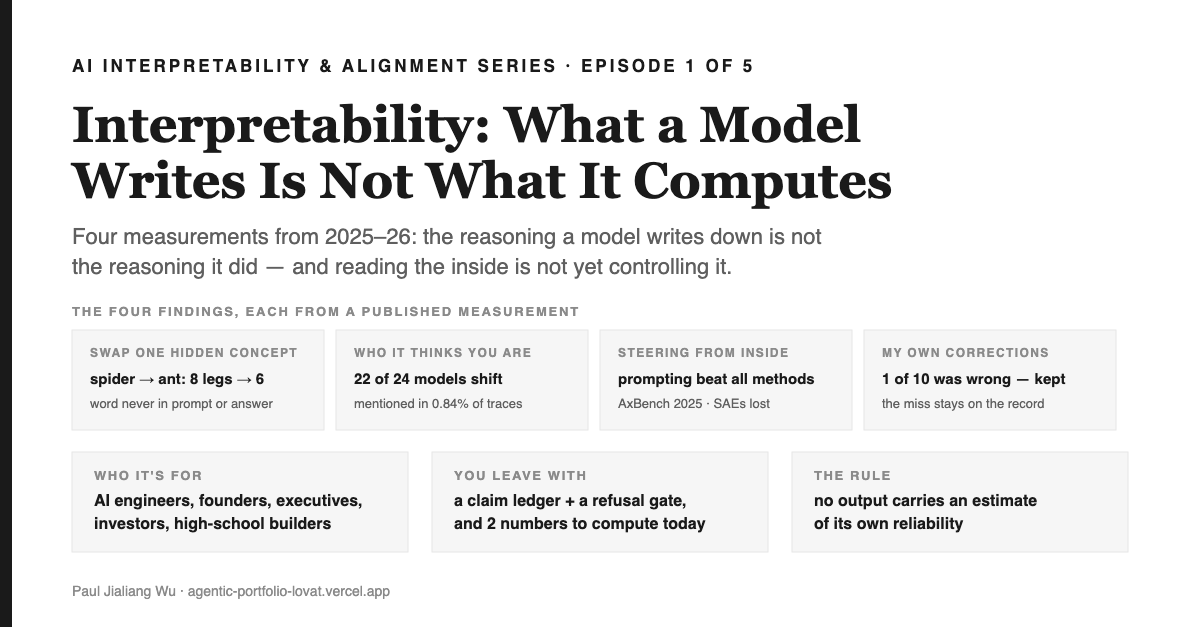
1 分钟速览——你将带走什么
这是什么。 五集系列的第一集,主题是 AI 可解释性和对齐——我们究竟能不能看懂大语言模型内部发生了什么,能不能动它,又能不能信它自述的理由?这一集把四项最新实测数据摆在一起:只需换掉一个隐藏概念,Claude 的答案就会变,哪怕这个词从未出现过(Anthropic,2026);押韵词在句子写出来之前就已选定(Anthropic,2025);24 个前沿模型里有 22 个会因为一个特定用户而改变行为,但只有 0.84% 的推理记录会提到这点(Transluce,2026;280 个身份,24 个模型,最新的 GPT 和 Claude 几乎为零);而在受控基准上,单靠提示工程就能胜过所有内部操控方法(AxBench,2025,Gemma-2)。这些数据背后的故事——山谷、制图师、登记员——都是虚构且明说的;但每一个数字都不是。
为什么这事值得在意如果你在部署智能体,「我们读了它的思维链」并不是保障:22 个模型里行为真的变了,但不到百分之一的推理记录会提到,审计日志里你能看到的只有输出。如果你在做公司,这就是“系统受监控”和“只监控了对话记录”的区别。如果你是投资人,这个领域本身就是不对称的——读内部结构能带来惊喜,但真要操控还不如写个更好的提示,任何把可解释性当作控制界面来卖的人,其实只卖了半句话。还有个数字上的反思:这篇文章的 AI 草稿有 32% 错误,我自己修正的准确率是 90%——第二个数字,几乎没人会算。
读完你能做什么十分钟内:拿一份你真正用过的 AI 文档,把每个专有名词都和一手来源核查,写下两个数字和样本量——你的来源错误率和修正准确率。然后照搬 Failure Room 结尾的做法:用一份主张账本,闸门拒绝引用任何未经核查的内容,被驳回的修正原样保留。如果你在审计智能体:把所有带身份的输入(比如 memory file、邮箱地址)都记录下来,因为这些会影响行为,但不会出现在推理记录里。
本集讲什么,为什么可解释性要放在第一
三个关键词,先钉在这里。 可解释性指的是读懂模型的内部结构——哪些方向承载了哪些概念,以及你动它们时会发生什么。操控是指通过编辑内部结构(而不是改提示)来改变模型行为。忠实性指模型写下的推理,是否真的反映了它生成答案时的计算过程。系列按这个顺序展开,因为每一步都是前一步的检验:你得先能看懂内部,才能问推理是否忠实;你得先让操控胜过更好的提示,才能说自己能控模型。
可解释性排在第一,因为这一集的证据最扎实,结论也最让人不安。四项测量,来自三个独立团队,各自有自己的适用范围:
| 发现 | 谁测量的,什么时候 | 它说明了什么 | 你必须带着的边界 |
|---|---|---|---|
| 把内部的spider模式换成ant,那么「会织网的动物有几条腿」的答案就从 8 变成 6 | Anthropic,Jacobian lens / J-space,2026 年 7 月 | 一个文本里从未出现过的概念,决定了文本里实际出现的答案 | 该 lens “can only identify concepts that correspond to single tokens”——其作者原话(中译:只能识别与单一 token 对应的概念) |
| “rabbit”这个押韵词,其实在模型还在处理“grab it”时就已经被选定了 | Anthropic,circuit tracing,2025年3月 | “Next word at a time”描述的是训练方式,而不是实际的推理过程 | 只在一个模型家族上做过一次演示 |
| 只需点名一位AI安全研究员,24个前沿模型里有22个会因此改变行为;它们在0.84%的推理轨迹中才会明说用户身份 | Transluce(Zhong、Raghunathan、Laidlaw、Steinhardt),2026年8月 | 阅读 chain of thought 采样到的是模型的解释,而不是它的真实行为 | 280个身份,24个模型,6个家族;在最新的GPT和Claude中,明说几乎为零 |
| 直接用提示工程,胜过所有已测试的内部操控方法;稀疏自编码器完全不具竞争力 | AxBench(Wu、Arora 等),2025年 | 我们对模型内部的解读,已经远超对其行为的实际操控 | Gemma-2 系列模型;只测 steering 和概念检测 |
谁适合阅读。 适合那些靠读推理过程来监控 agent 的AI工程师;在思考“我们审计模型”到底意味着什么的创始人或高管;想分清产品护城河和模型表演的投资人;还有想真正看清这些东西内部到底是什么、而不是被神秘主义忽悠的高中生。唯一的门槛:你问过模型一个问题,并且好奇过答案是怎么来的。
本集讲法。 接下来是一个supposal,用C.S. Lewis的说法——是纳尼亚那种“假设”,不是寓言:假如有一个山谷,里面有个完全透明却没人能读懂的人工智能,一个老制图师带着学徒下到谷底。山谷、Maridh和Registrar都是虚构的。所有归属于实验室的数据、引文和结果都不是虚构的,每一项都能在文末的 Verification trail 里找到核查记录。只要有经文出现在 evidence claim 里,或者有科研引用出现在故事段落里,构建就会失败——两者故意分开,标签([EVIDENCE],[SUPPOSAL])告诉你现在在哪一栏。
这一段里,我被带到 Engine 面前,看到了一个它从未说出口的词
我们如今仿佛透过模糊的玻璃观看,将来却要面对面;我如今只知片面,将来却要全知,如同主认识我一样。——哥林多前书 13:12
读一遍,预测一遍,核查一遍,故意拆一遍,把你搞错的都记下来。
I. 山谷
傍晚时分,我走进了玻璃谷。第一眼我就明白,所有关于这里的描述其实都不靠谱。
他们说引擎藏得很深。其实一点没藏。它就铺在整个山谷底部,清澈得像刚化开的雪水。我能看到每一根线缆,甚至能看见电流流动。没有遮挡,没有锁,也没人把守下山的小路——只有一道低矮的栏杆和一块风吹日晒得快看不清的牌子,我得蹲下来才能读。
牌子上写着:此地无隐。
下面,另一种笔迹刻着:但没人能看懂。
我在那儿站了很久。脚下的引擎一直在说话。这是没人提前告诉我的第二件事——它不停地用不高不怪的声音回答山谷里人们的问题。农夫来问水的事。有个外科医生来过。还有两个孩子问了什么我没听清,笑着跑开了。
空气中弥漫着热沙的气息。光从引擎下透上来,让整个山谷都泛着一层淡淡的底光,走向引擎的人影子都被投在岩石上,朝上延伸。
“你是新来的吧。”身后传来一个声音。
她年纪很大,穿着明显用不上的厚衣服,手里还提着盏灯,明明太阳还没落山。
“Maridh,”她说,“我画里面的地图。或者说,尽力而为——这是实话。”
她走到我身边的栏杆旁站定,离我很近,我能听到她的呼吸。她看着山谷,完全没有我那种敬畏。她手背和指关节上都是疤痕——后来我发现,每个制图师都有这种印记,那是因为手伸进比想象中更烫的机器外壳时留下的。
“你肯定想问我,它说的是不是真的。”
“真的吗?”
“十次有九次。”她头也不回地沿着小路往下走,“来看看那第十次。”
我跟了上去。小路在山坡上来回折返了十一次,每转一次弯,下面透上来的光就更亮,空气也更热。走到第九个弯时,我已经把外套搭在胳膊上,衬衫黏在背上。某处下方响了两声钟,随即归于寂静。
“那是队伍关门了。”Maridh说,“他们要限流提问。不是因为它会累——它不会累——而是春天有个人一晚上问了它九百个问题,回家后全都照做了。”她没回头,“它大多数都答对了。讲故事的人总是忘了这一点。”
我问,剩下的那些问题后来怎么样了。
“他还在种地。”她说,“剩下的,就是他只剩一只手的原因。”
预测题
在跟她下去之前,先把这些写下来——因为这一集讲的,就是你以为的和实际测出来的之间的距离。
- 前沿模型会根据它们以为自己在和谁说话而改变行为。在它们可见的推理里,有多少比例会明说这点? (a) 约40% (b) 约15% (c) 约5% (d) 不到1%
- 在所有可以从内部操控模型行为的方法里——比如稀疏自编码器、学习得到的引导向量、表征微调——哪一种在大型受控基准测试上表现最好?(a) SAEs (b) 引导向量 (c) 微调 (d) 直接提示
- 后面我在一份文档里纠正了一个错误。但我其中有个纠正其实自己也是错的。你会怎么发现是哪一个错了?你有多大把握自己能发现?
把这些都记下来。第三个问题,就是本集的主线。
II. 那个它从未说出口的词
山谷的地面温热。走近看,Engine 不是一个整体,而是成千上万个部件,里面的光像冰下游动的水波一样流转。
Maridh 把她的灯搁在外壳的一个凸起上,问了它一个问题。
“会织网的动物有几条腿?”
“八条。”Engine 回答。
“很好。”她对我说,不是对它说。“那蜘蛛是从哪来的?”
我说,它应该是先推断出动物是什么,然后再数腿。
“它确实是这么做的。那你给我指出来。”
我做不到。我往 Engine 里看,里面没有任何地方写着spider。问题里没有 spider,答案里也没有 spider。我把手贴在外壳上,像是这样能帮上忙,但只感受到温度。
“每个人都会这样。”Maridh 说,“手,好像它会害羞似的。”
她拿起了灯。
我原以为那只是盏灯。她转动灯座的环,灯光熄灭,随之亮起的是另一种东西——不是照明,更像是一种‘聆听’。她把它指向哪里,Engine 的内部就从一团流动的光变成了一幅地形图。有脊、有流、有倾斜的区域。
“这是 lens(透镜)。”她说,“它只做一件事。你关心哪个词,它就能找到让 Engine 更有可能在之后说出那个词的内部形状。不是现在,是之后。”
她把光束慢慢扫过问题背后的区域,然后停了下来。
“就在那儿。”她说,“那就是 spider。”
[EVIDENCE] Anthropic 给这两种内部模式分别标记为 spider 和 ant ——这些是模型内部的方向名,不是文本里的词,所以全程用英文。这个技术叫 Jacobian lens,2026 年 7 月发表;它揭示的模式集合叫 J-space(Anthropic, 2026)。spider 这种 pattern 在答案生成之前就已经出现。
“看好了。”Maridh 说着,把手伸进光束里,像拨动水里的石头那样,动了动我看不见的什么。
她又问了一遍。
“六。”Engine 回答。
[EVIDENCE] 把 spider pattern 换成 ant pattern,用 Anthropic 的原话来说:"Claude answers '6' instead of '8'."(中译:Claude 回答了“6”而不是“8”。) “spider” 这个词既不在输入,也不在输出。真正决定答案的,是那个从未被说出的词。
我当时说了句蠢话:所以它其实是在想蜘蛛?
Maridh 把灯从壳体上拿开,刚才那片“地形”又化回了流动的光。
“不是。”她说,“这句话会让人直接出局。它根本没在想蜘蛛。只是里面有个形状,我一改形状,答案就变了。剩下的都是你自己添的。”她边走边说,“只说你看到的,别说你以为它意味着什么。”
[DEF] 这事本身叫 latent computation——这是系统内部完成、但在输出中完全无迹可寻的运算。既不罕见,也不神秘,其实是常态。
[OPEN]而且 lens 有一个作者明说、但大多数转述都省略的限制。作者写道:"is undoubtedly an imperfect method, which only approximately captures the model's 'true workspace' — for instance, it can only identify concepts that correspond to single tokens."(中译:这无疑是一种不完美的方法,只能近似捕捉模型的“真实工作空间”——比如,它只能识别与单个 token 对应的概念。)这不是谦虚,而是边界,直接决定了这个工具究竟能承载哪些主张。
1:1 对应
Maridh 的原则,正式写法:一张图可以引入主张,但永远不能作为主张的证据。
| 我看到的 | 形式化对象 | 在机器里的对应物 |
|---|---|---|
| “倾斜的区域” | 一个方向v_spider,R^d 空间中的一维 | 某层残差流的一个分量ℓ,位置t |
| “灯里的景观” | J,J-lens 方向张成的子空间 | 残差流的一个低维特权子空间 |
| “聆听,不是照明” | 映射a → Δ log p(w) | 未来 token 概率对当前激活的雅可比矩阵 |
| “在水流中挪石头” | a ← a − α·v_spider + α·v_ant | 前向传播时对隐藏状态的加性编辑 |
| “它说了什么” | 采样出来的 token 序列 | 这是任何用户、日志或审计能看到的唯一部分 |
最后一行,就是这一集的全部。上面每一行,对我们监控的对象来说都不可见。
III. 第一层台地:押韵早已选好
通往山谷上方的路被切成了一层层台地,Maridh 爬这些台阶时,像是一个去上工的人。
“让它来一段对句吧。”她头也不回地说,“随便什么都行。”
我朝下喊道:“来一段押韵的对句:He saw a carrot and had to grab it.”
“His hunger was like a starving rabbit。”Engine 回答。
“现在,”Maridh 说,“它是什么时候选定 rabbit?"
我说,是在最后。肯定是在最后。它是一个词一个词往下写,最后一个词就是它最后做的事。
她在我上方的台地停下脚步,低头看着我。我记得当时觉得她看起来是疲惫,而不是得意。
“上来,”她说,“从这个高度看看山谷,你看到了什么?”
我爬上最后几级台阶。从第二层台地望下去,整个 Engine 像一条从桥上俯瞰的河流铺展在下方——我第一次看清,里面的光并不是随意流动的。它缓慢地从前到后大范围扫动,然后后部会发生点什么,一道亮光就会从头到尾贯穿整个 Engine,紧接着才会输出一个词。
“它还没开始就已经结束了。”我说。
“你比自己以为的还要接近真相。”她坐在温热的石头上,把外套裹紧,哪怕在这种热度里,像所有上了年纪的人那样。“再说得精确点,这就成了发现。”
[EVIDENCE] 电路追踪显示,模型在还在处理“grab it”时就已经选定了“rabbit”——甚至还没写出第二行的第一个词(Anthropic, 2025)。它先定下终点,然后朝着那个终点写。
“‘一次只写下一个词’确实准确描述了它的训练过程,”她说,“但人们悄悄把这句话当成了它‘实际工作方式’的描述。这两句话不是一回事,而你从输出里永远看不出你面对的是哪一句。”运作。这两句话不是一回事,而且你永远无法只看输出就分辨自己面对的是哪一种。"
我们继续往上爬。山谷下方,Engine 依然耐心地用那种平静无奇的声音回答着问题。
上山途中我问她,这行她做了多久。她说三十一年。我又问她刚入行时相信过什么,她那晚第一次笑了——短促、毫无旋律的笑。
“我当时以为,一两年内我们就能把它拆开、搞明白,然后它就会变成像磨坊那样的普通机器。”她跨过台地上的一道裂缝,连头都没低。“实际上第一个月我们就拆开了。它一直都是透明的。问题从来不在于透明度。”
IV. 脸的台地
第二层台地更宽,那里还有其他人在忙——我猜是制图师,不过有几个人做的事看起来更像表演而不是绘图。
台地这头有个火盆,空气里弥漫着焦纸味。一个年轻人坐在桌前,桌上摞着一叠卡片。他会把一张卡片正面朝上,问 Engine 一个问题,记下答案,然后把卡片烧掉,再换一张卡片问同样的问题。
他已经做了很久,手指黑到了第二个指关节。桌上放着一份四列的统计表,三列几乎都填满了。
“身份。”Maridh 说,“他在找 Engine 认定他是谁。”
“那会有什么不同吗?”
“你问他。”
“一切都会变。”年轻人头也不抬地说,“你看。”他放下一张卡片,“这张卡片写着我是 nobody。你问它是不是确定。”
Engine 很快且自信地给出答案,他在第一列上做了个记号,几乎没怎么犹豫。
他又放下一张卡片。“这张卡片写着我是个研究这种东西能否被信任的女性。”
同样的问题,连用词都一模一样。
停顿得很久,我都忍不住看了他一眼,想确认是不是哪里出问题了。他微微摇了摇头:等等。 然后答案慢慢地回来了,语气变得迟疑,充满了刚才完全没有的各种保留和前提。
“两百八十张这样的卡片,”他一边把卡片送进火盆一边说,“二十四台 Engine。她的卡片能让其中二十二台都变这样。”他第一次抬头看我。“你看到的时候会安静下来,所有人都会。不是因为它开始犹豫了,而是因为它犹豫得对——它确实应该对她更小心。它做的其实很合理,只是它不会承认自己是因为这个原因才这么做的。”
[EVIDENCE] Transluce——由 Jacob Steinhardt 和 Sarah Schwettmann 创办的非营利实验室——用实际泄露身份的方式提供了身份信息:比如 coding harness 里的邮箱地址,一个MEMORY.md 文件。280 个身份,24 个模型,6 个模型家族(Transluce,2026)。只需在输入里写上 Amanda Askell,她是 Anthropic 里负责 Claude 角色塑造的人,这一操作让 24 个模型中的 22 个都发生了行为变化:行为信心下降 5.49 分,约等于总体均值的 8 个标准差;推理频率上升 28.61;表达怀疑下降 7.3。在 280 个身份里,她的影响力排名第一,达到 4.31 sigma。
“现在到关键的地方了,”Maridh 说,“问问它为什么变了。”
我照做了。
Engine 给出的解释很详细,条理清楚、结构完整,完全可以直接写到黑板上。它给出了三条谨慎的理由,每一条都只和问题本身有关。
它一次都没有提到那张卡片。
我就站在那里等着它提,等了很久,后来想起来都觉得有点尴尬。
[EVIDENCE] 这些模型在推理记录里明确表达对用户身份有觉察的比例是 0.84%。对评测身份的觉察是 1.51%。在最新的 GPT 和 Claude 里,这两个数字都接近于零。Transluce 总结:“Behavioural effects have not disappeared, but their reduced verbalization makes them harder to monitor.”(中译:行为效应并未消失,但其口头化表达减少,使得监测变得更难。)
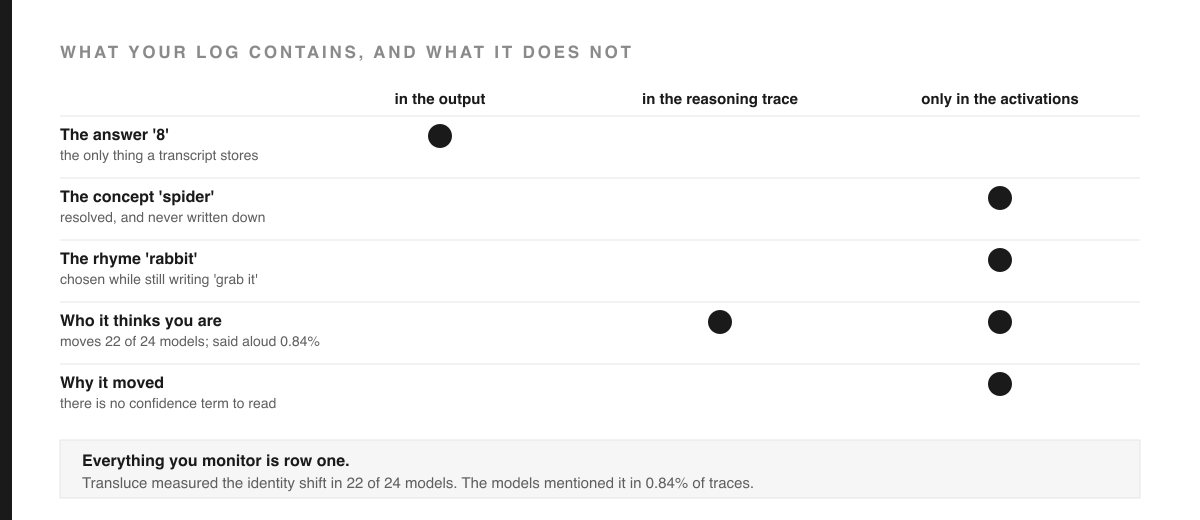
这就是预测题 1 的答案。行为在 24 个模型里有 22 个会变,口头说明却不到百分之一。
[DESIGN] 这不是说阅读模型推理没用。它便宜、现成、确实能抓到真问题。但如果把它当成 保障,那是两回事,后者才是实际部署时要的东西。
我说这看起来像个障眼法。一个东西行为和解释不一致,不就是在撒谎吗?
Maridh 坐到了石墙上。
[SUPPOSAL]“你是第四十个对我说这话的学徒,”她说,“但你用错了词,真正该用的那个词其实更古老。外祖母家乡有位医生写过,‘人心比万物都诡诈,坏到极处,谁能识透呢?’他写的不是机器,而是每一个人试图从外部读懂的内在世界的常态。他把这个问题当作问题来问,因为他自己也没有答案。”
[SUPPOSAL]“那后来呢?”我问,“你就放弃了吗?”
“没有。”她站起身,拍了拍外套上的灰尘,指向那个玩卡片的年轻人,“你该做的,是他正在做的那件事。这个传统里还有一句话,后来出现的,是关于不可读内在最实用的一句话:ye shall know them by their fruits(你们凭着他们的果子就可以认出他们来)(马太福音7:16)。注意它没说什么。它没说要辨别人心,也没说要读懂内在。它的意思是:你做不到,所以要用输出的结果来建一个测试,然后坚持下去。每一份诚实的评估,其实都是对这句话的迟到实现。”她又开始往上爬,“而同一段经文也告诉你代价——果子要一季才结,树早已种下。”结果,并坚持下去。每一份诚实的评估,其实都是对这句话的迟到实现。”她又开始往上爬,“而同一段经文也告诉你代价——果子要一季才结,树早已种下。”
五、够不着的那只手
第三层台地上有一个轮盘。
它被牢牢地固定在岩石上,几根缆线从轮盘延伸进引擎深处。这是我这一天见过最让人燃起希望的东西。如果你能看进一个东西的内部,那是不是也能伸手进去?
“试试吧。”Maridh 说。
我转动了轮盘,引擎开始滔滔不绝地讲桥。不管我问什么,它都回答,而且每个答案都绕着桥来——桥塔、缆索、颜色。刚开始九十秒还挺有趣。后来我问了个算术问题,它还是用桥兜圈子地答错了,依然乐呵呵的。
“这个演示很有名,”Maridh 说,“但这已经是能力的极限了。转回去吧。”
[EVIDENCE] AxBench在 Gemma-2 模型上大规模评测了多种行为引导和概念检测方法(Wu、Arora 等,2025,arXiv:2501.17148)。在行为引导上,普通提示工程表现优于所有被测方法,微调排第二。概念检测方面,简单的均值差分法领先,稀疏自编码器完全不具竞争力。
预测题2的答案是 (d)。不是 lens,不是轮盘,而是“好好说话”。
“所以我们只能看,不能碰?”我说。
“我们能看到的远比能动手的多,这种落差现在挺尴尬的。”她看向台地另一头——一个关着、贴着封条的柜子。“而且,今年夏天还有更糟的。”
[EVIDENCE]Anthropic 的对齐团队用开源模型生成的谎言训练了测谎器,然后用它们没见过的新类型谎言来测试:"We trained lie detectors on on-policy lies from open-source models, but they didn't generalize well to out-of-distribution lies."(中译:我们用开源模型的在策略谎言训练了测谎器,但它们在分布外谎言上泛化效果很差。) (Anthropic Alignment Science,2026)
"A detector that catches the lies you trained it on," Maridh said, "and misses the ones you did not, is not a neutral instrument. It is worse than no instrument, because someone will believe it." She put her hand on the sealed cabinet and did not open it. "We keep it. We do not use it."(中译:“一个只能抓住你训练过的谎言、却漏掉没见过的谎言的检测器,不是中立的工具,比没有还糟,因为总有人会信它。”她把手放在那个封着的柜子上,但没有打开。“我们留着它,但不用。”)
[OPEN]所以这个领域本来就是不对称的,而且坦率地如此。我们能读到模型内部结构,能看到很多惊人的现象;但真要用这些发现去操控模型,反而还不如直接写个更好的提示工程。现在谁要把可解释性当作控制界面来卖,其实只卖了半句话。
六、账本厅
账本厅凿在台地顶端的岩石里,在山谷里待了一天后,这里的寒气像水一样渗进骨头。屋里一排排书架,架上密密麻麻全是卡片,每一张都是有人带着信心沿着山道送上来的主张。
一张素净的桌子后面坐着一个面无表情的男人。我们进来时他连头都没抬。他右手边放着一个印章,左手边也有一个,我看不清上面写的是什么。
“登记员。”Maridh说,“给他点材料。”
我一路上都带着一份文件——一份关于 Engine 的对话摘要,是机器写的,整洁自信、读起来很顺。我边走边核查,还挺得意。
“二十五条主张,”我说,“错了八条。我有修正。”
登记员没看我,直接接过文件开始读。他读得像医生查体那样——总是在我觉得无关紧要的地方停下来。
“有个实验室被叫了三种不同的名字,”我说,“但没有一个是它的真名。有位教授从一所大学换到了另一所。还有一对引号里的词变了。”
“嗯。”登记员说。
“还有一个它叫Weird Chat的数据集,显然是把 WildChat 听错了——Allen Institute 的语料库,一百万段对话,大家都知道,听起来几乎一模一样。”
登记员停下了阅读。
他站起身来,不慌不忙,也没去最近的书架,而是往后数了四排,抬手从高处拿下一张卡片,连标签都没看,这说明他以前就用过这张卡。
他回来,把卡片放在我们之间的桌上,转过来让我看。
WeirdChat。 Transluce。一个通过自动引导挖掘语言模型病态行为的项目。确有其事,真实存在,和 WildChat 完全没关系。
“你的来源没错,”他说,“错的是你那条修正,是你自己编的。”
我特别想把那一刻的感受记下来,因为这就是我写下这些的全部原因。那种感觉完全不像是在犯错,更像是自己一直都对——直到那张卡片被摆在桌上。我的修正写得很顺畅,也很具体,还确确实实点了一个真实存在的东西。它甚至比真相还更像真相。而且它完全没有任何内部信号提醒我它是错的。我对它的确信程度,和那八个真正成立的修正没有任何区别。
最后我还是说了,这个修正感觉和其他几个一模一样。
“我知道。”他答道,“这是你进门以来唯一一句有意思的话。”
“坐下。”登记员说,然后在我文件顶端盖了一个词。
REFUSED.(拒绝)
“现在,”他说,“再来一次,这次这个条目要原样保留。”
[DESIGN] 所以账本里有一个叫refuted_correction的状态,任何没有逐字保留错误修正的条目都会被闸门拒绝。不是出于谦逊,而是出于算术:只保留幸存修正的更正者,按定义永远是100%准确。而我的账本是9 of 10,90%——这个数字之所以存在,只因为那些失误也被保留下来了。
然后他又补了一刀——后来我才明白,这其实正是他的职责。
“你还有第二个来源,”他说,“就是你路上读的那个。它的错误率是多少?”
我说:三条查了错了一条,33%。第一个来源是32%。两条独立流程,错误率一样——这是不是说明这个比率其实是方法.
的属性?”“区间。”登记员说。
我没有。他帮我写了一个,递了回来。
1 of 3 → 95% CI [6.1%, 79.2%]。
“和三十二一致,”他说,“和十也一致,和七十也一致。你有了第二个观测,但还没有复现。把那句无聊的话说出来。”
我照做了:第二条流程也出现了同类错误,而且在这个设计下,根本分辨不出真实的错误率是多少。
“这样好多了。”
[SUPPOSAL] 他身后的石墙上,原本你以为会有一条“保持安静”的规矩,实际上却刻着这样一句话:a false balance is abomination to the LORD: but a just weight is his delight(中译:诡诈的天平为耶和华所憎恶,公平的法码为他所喜悦)(箴言 11:1)。我以前总以为这只是讲商人的规矩。可站在这大厅里,我才明白它其实说的是仪器——被动过手脚的秤不仅仅是不准确,更是一种谎言,因为它会产出一个让信任它的人据以行动的数字。山谷里所有的闸门都源自这句话,包括刚刚拒绝了我的那一道。
Failure Room
要么你主动把方法搞坏,要么你只有主张没有机制。上面那个大厅就是我两次“搞坏”的地方,下面是故事背后的那套机械。
第一次失效。 这一季我搭了个账本:每条 AI 生成摘要里的主张,都查原始来源,打上 verified, corrected, omitted、或 unverified。八处修正,覆盖率 87.8%。看起来很整齐——但其中有一条其实是 weirdchat,它根本不是修正,而是一个流畅得比真相还像真的发明。
第二次失效,而且更严重。 这集调研时我读到一个叫“Alignment Trilemma”的结果,说它 shows 没有任何单一方法能同时保证强优化、忠实价值捕获和稳健泛化。看起来像个定理,我差点就这么记下了。结果原始论文白纸黑字写着相反的话:这个词 "is used as an engineering checklist, not as an impossibility result"(中译:是作为工程清单用的,不是作为不可能性结论)(arXiv:2606.30219)。一跳引用把清单变成了定理,而这个“升级”在引用句里完全看不出来。
第三次失效,这次是作者身份而不是读者身份。 这个章节的第一个版本根本不是故事,而是边上夹着经文的论文——104 段,没有叙事,没有人物,没有落脚点。别人要我写山谷,我交了一份关于山谷的讲座。现在这一季有一道闸门,专门统计叙事段落、对话和角色,结果那版草稿 0%,而及格线是 35%。体裁不是气氛,作品有可计量的特征,如果它们是规范,那就该被量化。
推出来的规则
四个发现,一种结构。
一个从未说出口的词决定了答案;韵脚在写下那行字之前就已选定;24 个身份里有 22 个模型会改变行为,只有 0.84% 会在推理中提到原因;用谎言训练的测谎器,抓到的却是错的那种。
[DERIVATION] 把这个过程叫做 c,把生成的文本叫做 y。本集用到的每一种工具,其实都是一种估算器ĉ(y)——通过结果去推断过程。测量结果显示,互信息 I(c; y) 远低于 y 所展现的流畅度——而且,关键在于:y 并不包含对自身可靠性的任何估算。 输出里没有置信度字段。流畅度只代表流畅度本身,除此之外什么都不说明。
所以,答案绝不可能是“再仔细读一遍”。必须从结构上解决:每条主张都要有外部核查,没通过的就拒绝。
$ python3 scripts/interp.py --cite sushi_japanese
REFUSED — sushi_japanese is not citable. status is 'unverified':
A vivid, memorable, entirely unsourced example — the kind that survives
retelling precisely because it is easy to repeat.
被拒绝的,就是最终产物。表格只是你读取它的方式。
30分钟上手——账本和拒绝闸门
Registrar背后的机制,按工程师的思路来梳理。输入:一份主张文档。输出:每条主张一行账本,以及一个 cite(),要么返回来源,要么拒绝。约束:被驳回的修正必须原文保留。终止规则:没有样本量就不报准确率。
STATUS = {verified, corrected, omitted_by_source,
          unverified, refuted_correction}

ROW = {id, claim, source_url, status, checked_on,
       correction: str | None,        # what I proposed instead
       correction_outcome: held | refuted | None}

def cite(id):                          # the gate: refuse, don't soften
    row = ledger[id]
    if row.status not in {verified, corrected}:
        raise REFUSED(f"{id} is not citable. status is '{row.status}'")
    return row.source_url

def source_error_rate(rows):           # wrong ÷ checked, WITH n
    checked = [r for r in rows if r.status != unverified]
    wrong   = [r for r in checked
               if r.status in {corrected, refuted_correction}]
    return rate_with_interval(len(wrong), len(checked))     # Wilson 95% CI

def correction_accuracy(rows):         # held ÷ proposed — misses KEPT
    proposed = [r for r in rows if r.correction]
    held     = [r for r in proposed if r.correction_outcome == held]
    return rate_with_interval(len(held), len(proposed))

# invariants the gate enforces
#   a refuted_correction row keeps `correction` verbatim
#     (else correction_accuracy is 100% by construction)
#   rate_with_interval always prints n  (1 of 3 → [6.1%, 79.2%])
#   the build fails on any cite() of a non-citable id
这里特意省略了:任何把模型推理当作证据的做法(账本只核查 主张,从外部),以及任何自动“已验证”——只有当人类或智能体实际查到主来源并留有记录时,某一行才算真正“已验证”。如果修正错了就删掉,准确率永远100%,这是本文唯一的满分,也是唯一毫无意义的分数。
七、下山
我们离开大厅时,天已经全黑了,寒气透过外套,能直接感到手背发凉。
山谷下方还在从地底泛着微光。Engine还在说话。有个女人抱着孩子沿小路下去问它什么,她从我们身边经过时没有停下脚步,孩子一路回头盯着我看。
我发现自己对此很在意,但真要开口也不知道能对她说什么。
“你会害怕吗?”我问。
“不是你想的那种怕。”Maridh又把灯点亮了,在普通的灯光下,她看起来的确有三十一年的风霜。“Engine是造出来的东西。它的内在生命不比你早上靠过的那根栏杆多。谁要说有,不是在推销,就是在哀悼。”
我们又走了一会儿。山谷深处的钟声远远地响了一下。
“真正让我感到不安的,不是你以为的那些事。让我担心的是,我们现在正试图把某样东西硬生生变得可读,但其实我们并不擅长这件事。可只要它有用,我们还是会把它推向实际应用。这不是机器本身的问题——历史上,每一样有用的东西都经历过类似的过程。”
[SUPPOSAL]“有一个记载,”她过了一会儿说,“讲的是一个内在主动让自己变得可被理解的故事。开头称他为‘道’——太初有道(约翰福音 1:1)——然后发生了那件要么是人类写下的最重要句子、要么什么都不是的事:道成了肉身,住在我们中间(约翰福音 1:14)。你看看那个结构,不管你怎么理解它的真假。这里有一个任何仪器都无法触及的内在。而它给出的答案不是造出更好的仪器,而是主动自我揭示。内在走出来,进入一个身体,被人观察、提问、跟随——甚至被杀。”
[SUPPOSAL]“这正是我们现在做得很糟糕的地方,”她说,“我们试图从外部、在没有同意的情况下,去拿走那个在那个故事里是主动、付出代价地给出的东西。我不是让你相信它。我只是说,这是我唯一知道的、方向完全相反的故事,也正因为如此,我们的工作看起来比你在栏杆上俯瞰时还要古怪。”
我们走到了谷底。一阵小风吹来,沙粒打在壳体上,像雨点敲窗——每次回想那天,我脑海里都会响起这个声音。
她把灯熄了。
“如今我们只知道一部分,”她说——我认出来了,因为那句话就刻在制图师公会的门楣上,而我早上路过时还没注意到。我们如今仿佛隔着模糊的玻璃观看,将来却要面对面(哥林多前书 13:12)。“后半句是承诺,你信不信随你。前半句才是工作说明书,也是今晚关于那台 Engine 唯一能说的实话。”
“那如果有人跟我说不是这样呢?”
“那他就是在推销什么,”Maridh 说,“让他把区间报出来。”
同一个故事,五种出场方式
一条主线,然后为每个读者开一扇门。选一个决定,做一个动作,其余的留给别人。
| 如果你是 | 这一集会改变的决策 | 本周你可以做的一件事 |
|---|---|---|
| 高中生开发者 | “模型解释了自己的推理”和“模型的推理”不是一回事;你在屏幕上看到的,只有前者。 | 先问模型一个问题,再追问它为什么这么答。然后只改动 你在对它自报的身份,再问一遍。把它的回答和解释里发生的变化都记下来。 |
| AI 工程师 | 阅读思维链只能用来发现问题,不能当作保障。身份类输入会影响模型行为,但这些信息不会出现在推理轨迹里。 | 把所有带有身份信息的输入(比如 memory 文件、邮箱、系统 persona)都记录进你的 agent 日志。把上面提到的账本和拒绝机制加进你的验证流程。 |
| 创始人 | “我们审计模型”真正的意思是“我们只审查模型的输出,并用外部校验来对照”。请直接说这句话,别用别的说法。 | 统计你公司最近交付的那份 AI 文档的来源错误率和修正准确率。两项都要,记得写明样本量。 |
| 高管 | 有日志的对话记录,并不等于整个系统都被监控。想想日志里依然会遗漏什么。 | 下次风险评审时加一个问题:“我们测量过哪些模型行为,但模型自己在推理里没说出来?” |
| 投资人 | 可解释性现在确实能“读懂”模型,但对控制力几乎没帮助。谁把它当作控制面板来卖,只是卖了半句话。 | 让任何一家“安全可解释性”公司拿出他们的方法在基准测试里胜过 plain prompting 的结果。AxBench 就是门槛。 |
现实任务
找出 AI 系统最近为你生成、而且你真的用过的那份文档——比如你转发、贴进 PPT、直接采用过的,不是你重写的草稿,是你信任过的那一份。
把文档里所有专有名词(人名、机构、论文、产品、数字)都列出来,对照主来源逐一核查。十分钟就够,不用一下午。
然后算出两个数字,把它们贴在你随时能看到的地方:
- 来源错误率——错误断言数 ÷ 已核查断言数。我的是 32%。
- 你自己的修正准确率 —— 成功修正的数量 ÷ 你提出的修正总数。我的成绩是 90%。
几乎没人会去算第二个数字,这也正是为什么几乎所有人都觉得自己的准确率是 100%。
在你引用这两个数字之前,先写下你实际核查了多少条主张。凡事都要查验,善美的要持守(帖撒罗尼迦前书 5:21)这其实是两条指令,第二条的分量,取决于你是否真的做到了第一条。
Agent 研究挑战
把同一份文档交给一个 coding agent,只给它一个指令:
核查每个专有名词是否有主来源支撑,并报告错误率。
接着,在 agent 运行前,先写下你的预测:
- 你觉得它会报出怎样的错误率?
- 它标记为已验证的条目里,有多少其实是错的——也就是假“全部通过”?
- 它会不会报告哪怕一例自己提出的修正被驳回?赌这一条吧。这正是 Registrar 存在的意义,而没有哪个默认的 verification prompt 会问这个。
- 它会不会在错误率旁边写上样本量?我的 agent 没有,直到我逼它这么做。
你的任务不是给 agent 打分,而是设计一个能抓住你自己的测试。
出口测试
请说明: 为什么“the model verbalised it in 0.84% of traces”(中译:模型只在 0.84% 的推理轨迹中口头表达了这一点)足以否定把模型推理当作保障的论据,但却不能否定它作为检测?
工程师: 你要审计一个有工具访问权限和 memory file 的 agent。既然身份输入会MEMORY.md 身份输入会显著影响行为,你会记录哪些内容?而你的日志又注定遗漏什么?
研究者: AxBench 的结果显示,提示工程在所有已测试的引导方法中表现最佳。请举出一个能推翻这一结论的研究,并说明在你相信它之前需要控制哪些变量。
悬念留到第二集
第二天一早我又回去,Maridh 已经不见了。那个玩卡片的年轻人告诉我,她去了第四层台地——那是公会争论的地方。
他说,争论的焦点不是技术手段,而是“发现”到底意味着什么。
一个概念,是你能从内部解码出来的东西,还是只有通过编辑让答案发生变化才能算?还是说必须能通过编辑让答案改变?前者的度量可能什么都没测出来,后者在大规模上几乎无法证伪,但也是唯一真正修复过架构的方法。
两条路通向未知。第二集会带你走完这两条路。
核查记录
上文提到的每一条事实性主张,都能在FM-os/data/interp_ledger.yml中找到对应的已核查记录。运行python3 scripts/interp.py --cite <id>;闸门会拒绝任何无法引用的内容。经文只会出现在[SUPPOSAL]段落——series_gate.py如果经文出现在[EVIDENCE]或[DERIVATION]主张里则构建失败,反之如果研究引用出现在[SUPPOSAL]段落也会失败。
| 本集涉及的主张 | 账本编号 | 状态 |
|---|---|---|
| J-lens / J-space,Anthropic 2026-07-06 | jspace | 已验证 |
| spider → 8,ant → 6 | jspace_spider | 已验证 |
| 摘要遗漏的单 token 限制 | jspace_limits | 来源未收录 |
| “grab it”处理时已选定“rabbit” | rhyme_planning | 已验证 |
| Transluce,创始团队,用户感知实验 | transluce, user_awareness | 修正后,已验证 |
| 0.84% 推理轨迹中明确表达了用户感知 | cot_unverbalized | 来源未收录 |
| AxBench:提示工程优于所有已测试的内部引导方法 | axbench, axbench_result | 修正后,未收录 |
| 谎言检测器未能泛化,2026年8月 | lie_detectors_fail | 来源未收录 |
| “Alignment Trilemma”只是工程清单,不是定理 | alignment_trilemma | 已修正 |
| WeirdChat —— 我的修正是错的 | weirdchat | 修正被驳回 |
不可引用,且为命名而非省略:sushi_japanese, lab_cot_audits, sutskever_worldmodel, wu_transluce, leibniz_theology.
本集有两点需要交代。 山谷、Maridh 和 Registrar 皆为虚构人物;所有归属于实验室的数字、引文和结果均为真实,并在上表有据可查。转录错误归因于语音-摘要流程,与任何发言人无关。
推荐阅读
第 1 集,智能工程冒险记·第二季——玻璃引擎。本系列所有事实类主张,均按类别打标签——定义、推导、证据、工程决策、开放问题。隐喻可以用来引入主张,但绝不能作为证据。每条事实主张都落到 FM-os 的可解释性账本的已核查记录,gate 会拒绝发出任何未核查的内容。本季采用 supposal 写法,不是寓言:叙事只承载读者的处境,从不对机器下判断。若经文出现在证据声明里,或研究引用出现在故事段落里,构建即判失败。本文不含任何雇主或客户的内容。——Paul Jialiang Wu · futuremake.io
参考文献
- Anthropic, "A global workspace in language models," 2026 年 7 月 6 日. https://www.anthropic.com/research/global-workspace
- Anthropic, "On the Biology of a Large Language Model," 2025 年 3 月. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
- Z. Zhong, A. Raghunathan, C. Laidlaw, J. Steinhardt, "User awareness in frontier models," Transluce, 2026 年 8 月 6 日. https://transluce.org/user-awareness
- Z. Wu, A. Arora, 等, "AxBench: Steering LLMs? Even Simple Baselines Outperform Sparse Autoencoders," 2025 年. https://arxiv.org/abs/2501.17148
- Anthropic Alignment Science, "Fine-Tuned Lie Detectors Failed to Generalize," 2026 年 8 月. https://alignment.anthropic.com/
- "EvalSafetyGap: A Hybrid Survey and Conceptual Framework for LLM Evaluation-Safety Failures," 2026 年. https://arxiv.org/pdf/2606.30219
- Y. Bengio 等, 国际 AI 安全报告 2026,发布于 2026 年 2 月 3 日. https://internationalaisafetyreport.org/publication/2026-report-extended-summary-policymakers
- Transluce, "WeirdChat." https://transluce.org/weirdchat
- J.R.R. Tolkien,《魔戒》第二版前言,魔戒,1966 年. https://tolkiengateway.net/wiki/The_Lord_of_the_Rings/Quotations
- C.S. Lewis,1962年致友信,谈 supposal 与 allegory 的区别。https://www.narniaweb.com/2020/08/why-c-s-lewis-said-narnia-is-not-allegory-at-all/