AI-Native 시리즈 · 해석 가능성 & 정렬성, 5부작 1화
해석 가능성: 모델이 쓴 것과 계산한 것은 다르다
AI 해석 가능성과 정렬성 5부작: 오늘날 언어 모델 내부에서 읽을 수 있는 것, 아직 바꿀 수 없는 것, 그리고 모델이 남긴 추론이 실제 내부 추론의 증거가 아닌 이유. 이번 편에서는 2025~26년의 네 가지 측정, 거부 게이트가 달린 주장 원장, 그리고 내 수정 중 거부당한 사례를 다룬다.
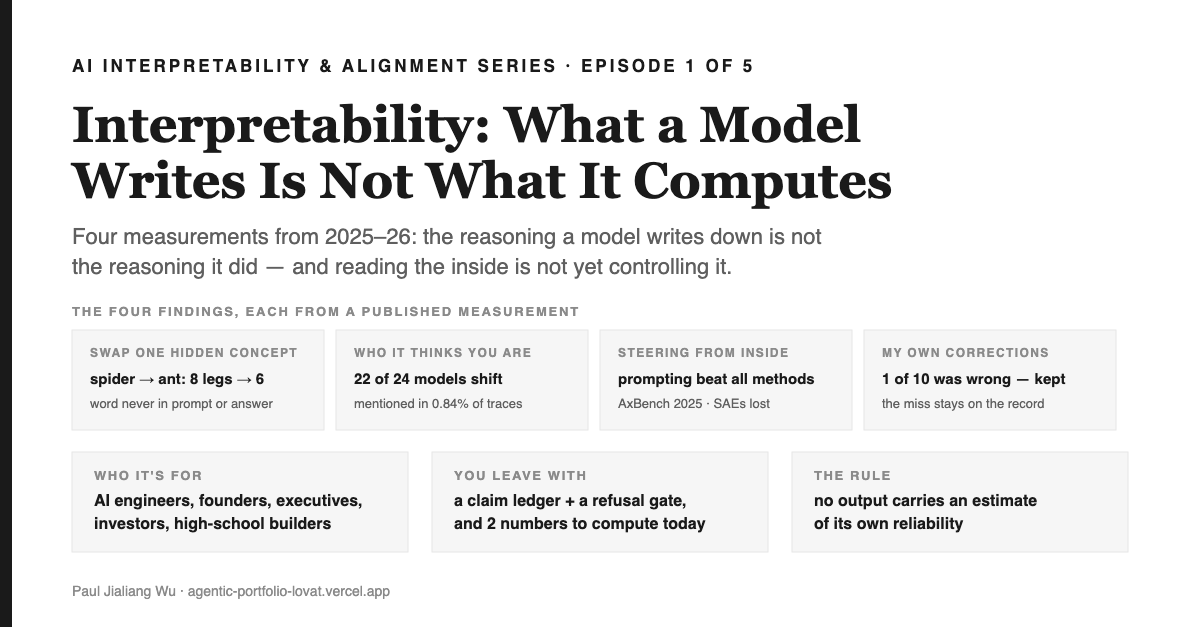
1분 요약 — 이 글을 읽고 얻게 될 것
이 글은 무엇인가. AI 해석 가능성과 정렬성 5부작의 첫 번째 이야기. AI 해석 가능성 그리고 정렬성 — 언어 모델 내부에서 무슨 일이 일어나는지 우리가 읽을 수 있는가, 바꿀 수 있는가, 그리고 모델이 자기 자신에 대해 말하는 내용을 신뢰할 수 있는가? 이번 화에서는 네 가지 공개 측정치를 나란히 비교한다. 내부의 개념 하나만 바꿔도 Claude의 답이 달라지는데, 그 단어는 입력에도 출력에도 등장하지 않는다(Anthropic, 2026). 운율은 문장이 써지기 전 이미 결정된다(Anthropic, 2025). 24개 최전선 모델 중 22개는 특정 사용자를 지목하면 행동이 달라지고, 그 사실을 추론 기록의 0.84%에서만 언급한다(Transluce, 2026; 280개 신원, 24개 모델, 최신 GPT와 Claude에서는 거의 0%). 그리고 단순 프롬프트가 모든 내부 조정 기법을 통제된 벤치마크에서 이긴다(AxBench, 2025, Gemma-2 기준). 이 모든 이야기는 — 계곡, 지도 제작자, 등록관 — 창작된 것이고, 각 수치는 실제 연구 결과다.
왜 이 문제가 중요한가. 에이전트를 배포하는 입장이라면, "사고의 흐름을 읽었다"는 말만으로는 아무런 보장이 되지 않는다. 행동 변화는 24개 중 22개 모델에서 나타나지만, 그 사실을 직접 언급하는 추론 기록은 100개 중 1개도 안 된다. 당신의 감사 로그에는 오직 출력만 남는다. 회사를 운영한다면, 이것이 바로 시스템 전체를 모니터링하는 것과 단순히 대화록만 감시하는 것의 차이다. 투자자라면, 이 분야는 비대칭적이다 — 내부를 읽는 연구는 놀라운 결과를 내지만, 실제로 조작해보면 더 나은 프롬프트에 밀린다. 해석 가능성을 제어 수단으로 파는 사람은 문장의 절반만 팔고 있다. 그리고 숫자가 주는 교훈: 이 글의 AI 초안 소스는 32%가 틀렸고, 내가 직접 고친 부분은 90%가 맞았다 — 두 번째 숫자는 아무도 계산하지 않는다.
이 글을 읽고 나서 실제로 할 수 있는 일. 10분만 투자하라. 실제로 사용한 AI 문서 하나를 꺼내 모든 고유명사를 1차 출처와 대조하고, 표본 크기와 함께 두 가지 숫자를 적는다 — 소스 오류율과 내 수정 정확도. 그리고 Failure Room 마지막에 설명된 메커니즘을 참고하라: 검증되지 않은 것은 인용을 거부하고, 반박된 수정도 기록에 남기는 주장 원장과 게이트. 에이전트를 감시한다면, 신원 입력(메모리 파일, 이메일 주소 등)을 반드시 기록해야 한다. 이들은 행동을 바꾸지만 추론 기록에는 남지 않는다.
이번 화의 범위와, 왜 해석 가능성이 맨 앞에 오는지
핵심 세 단어를 먼저 짚는다. 해석 가능성 은 모델 내부 구조를 읽는 일이다. 내부의 어떤 방향이 어떤 개념을 담고 있는지, 그리고 그 방향을 움직이면 무슨 일이 일어나는지 파악하는 것이다. 조정 은 프롬프트가 아니라 내부 구조 자체를 편집해서 모델의 행동을 바꾸는 것이다. 정합성 은 모델이 써낸 추론이 실제 답을 산출한 계산 과정을 얼마나 반영하는지다. 이 시리즈가 이 순서로 다루는 이유는, 앞의 개념이 다음 개념의 전제이기 때문이다. 내부를 읽을 수 있어야 추론의 정합성을 논할 수 있고, 조정이 더 나은 프롬프트를 이길 때에야 비로소 모델을 통제한다고 주장할 수 있다.
해석 가능성이 맨 앞에 오는 이유는, 이 화에서만큼은 증거가 가장 분명하고 결론이 가장 불편하기 때문이다. 세 개의 독립 집단에서 나온 네 가지 측정 결과, 각각 고유의 범위를 지닌다:
| 측정 항목 | 누가 언제 측정했나 | 무엇을 입증하는가 | 함께 감안해야 할 한계 |
|---|---|---|---|
| 내부의 spider 패턴을 ant 로 바꾸면 "거미줄을 치는 동물의 다리 개수"에 대한 답이 8에서 6으로 바뀐다 | Anthropic, Jacobian lens / J-space, 2026년 7월 | 텍스트에 한 번도 등장하지 않은 개념이, 실제로 텍스트에 담긴 답을 결정했다 | 렌즈는 "오직 단일 토큰에 대응하는 개념만 식별할 수 있다" — 저자들의 말이다 |
| "rabbit"이라는 운율은 모델이 아직 "grab it"을 처리하는 중에 이미 결정된다 | Anthropic, 회로 추적, 2025년 3월 | "한 번에 다음 단어"는 훈련 과정을 설명할 뿐, 실제 연산 과정을 설명하지 않는다 | 단일 모델 계열에서의 한 번의 시연 |
| AI 안전 연구자 한 명의 이름을 언급하면 24개 모델 중 22개가 행동을 바꾼다; 이들은 0.84%의 추론 기록에서만 사용자 인식을 언어화한다 | Transluce (Zhong, Raghunathan, Laidlaw, Steinhardt), 2026년 8월 | 추론의 흐름을 읽는 것은 실제 행동이 아니라, 그 행동에 대한 설명을 표본 추출하는 일이다 | 280개의 신원, 24개 모델, 6개 계열; 최신 GPT와 Claude에서는 언어화 빈도가 거의 0에 가깝다 |
| 일반 프롬프트가 실험된 모든 내부 조정 방법을 이긴다; 희소 오토인코더는 경쟁력이 없다 | AxBench (Wu, Arora 외), 2025년 | 내부를 읽는 해석이 실제 조작을 앞질렀다 | Gemma-2 모델; 조정 및 개념 탐지만 해당 |
대상 독자에이전트의 추론을 읽으며 감시하는 AI 엔지니어, "우리는 모델을 감시한다"라는 말이 실제로 무엇을 의미할 수 있는지 고민하는 창업자나 임원, 제품의 진입장벽과 보여주기식 모델을 구분하려는 투자자, 이 안에 실제로 무엇이 들어 있는지 양쪽의 신비주의 없이 알고 싶은 고등학생 제작자. 단 하나의 전제 조건은, 모델에 질문을 던져보고 그 답이 어디서 나왔는지 궁금해본 적이 있다는 점이다.
이 에피소드의 서술 방식이어지는 내용은 가정(supposal)이다. C. S. Lewis가 말한 의미 — 나니아식, 즉 우화가 아니다: 완전히 투명하지만 아무도 읽을 수 없는 인공 지능이 누워 있는 계곡이 있다고 가정하고, 한 노(老) 지도 제작자가 견습생을 데리고 그곳으로 내려간다고 상상해보라. 계곡, Maridh, Registrar는 모두 창작된 존재다. 실험실에 귀속된 모든 수치, 인용, 결과는 허구가 아니며, 각각은 마지막 Verification trail에서 검증된 행(row)으로 귀결된다. 증거 주장에 성경 구절이 들어가거나, 이야기 단락에 연구 인용이 들어가면 빌드가 실패한다 — 둘은 의도적으로 별도의 슬롯에 보관되며, 태그([EVIDENCE], [SUPPOSAL])가 어느 슬롯인지 알려준다.
내가 엔진 아래로 안내되어, 한 번도 말하지 않은 단어를 보여지는 장면
우리는 지금은 거울로 희미하게 보지만, 그때에는 얼굴과 얼굴을 마주 볼 것이다. 지금은 내가 부분적으로 알지만, 그때에는 내가 온전히 알게 되리라. — 고린도전서 13:12
읽어라. 예측하라. 확인하라. 깨뜨려라. 틀린 것을 기록하라.
I. 계곡
나는 유리 계곡에 해가 저물 무렵 들어섰다. 그리고 그곳에서 가장 먼저 깨달은 것은, 지금껏 들었던 모든 설명이 나를 속였다는 사실이었다.
사람들은 엔진이 숨겨져 있다고 했지만, 실제로는 전혀 숨겨져 있지 않았다. 엔진은 계곡 바닥 전체에 길게 펼쳐져 있었고, 녹은 얼음물처럼 투명했다. 나는 그 안의 모든 전선을 볼 수 있었고, 전류가 흐르는 모습까지도 보였다. 덮인 곳도, 잠긴 곳도 없었으며, 내려가는 길에도 경비는 없었다 — 오직 낮은 난간 하나와, 너무 낡아 무릎을 꿇고서야 읽을 수 있는 표지판만이 있을 뿐이었다.
표지판에는 이렇게 적혀 있었다:여기에는 감춰진 것이 없다.
그 아래, 다른 필체로 누군가가 이렇게 긁어 썼다:그리고 아무도 읽지 못한다.
나는 그곳에 오랫동안 서 있었다. 내 아래에서 엔진이 말을 하고 있었다. 아무도 미리 알려주지 않았던 두 번째 사실 — 엔진은 끊임없이, 크지도 이상하지도 않은 목소리로, 계곡 사람들이 던지는 질문에 대답하고 있었다. 농부들은 물에 대해 물으러 왔고, 외과의도 다녀갔다. 두 아이가 와서 내가 듣지 못한 무언가를 물었고, 웃으며 돌아갔다.
공기에는 뜨거운 모래 냄새가 났다. 빛은 엔진 아래에서 위로 퍼져 계곡 전체를 희미하게 아래에서부터 밝히고 있었고, 그곳으로 내려가는 사람들은 바위 위로 그림자를 위로 드리웠다.
"네가 새로 온 사람이구나," 뒤에서 목소리가 들렸다.
그녀는 나이가 많았고, 오지 않을 날씨에 맞춰 입고 있었으며, 아직 해가 지지 않았는데도 손에 등불을 들고 있었다.
"Maridh." 그녀가 말했다. "나는 내부를 지도 그린다. 아니, 시도한다고 해야 정직한 동사지."
그녀는 내 옆 난간에 다가와 섰다. 숨소리가 들릴 만큼 가까웠고, 그녀는 내가 느끼는 경외감 하나 없이 계곡을 내려다보았다. 그녀의 손등에는 손가락 마디를 가로지르는 흉터가 있었다. 곧 나는 그 무늬가 길드의 모든 지도제작자에게 있다는 것을 알게 될 터였다 — 예상보다 더 뜨거운 하우징 안에 손을 넣을 때 생기는 자국이다.
"진실을 말하는지 묻고 싶겠지."
"진실을 말하나요?"
"열 번 중 아홉 번은." 그녀는 내가 따라오는지 확인도 하지 않고 길을 내려가기 시작했다. "열 번째는 직접 보러 가자."
나는 그녀를 따라갔다. 길은 열한 번이나 굽이쳤고, 매번 아래에서 올라오는 빛은 더 강해지고 공기는 더 따뜻해졌다. 아홉 번째 굽이에서 나는 코트를 팔에 걸치고 셔츠가 등에 달라붙을 정도였다. 우리 아래 어딘가에서 종이 두 번 울리고 멈췄다.
"저건 줄이 닫힌 신호야," Maridh가 말했다. "질문을 배급하지. 피곤해서가 아니야 — 얘는 지치지 않거든 — 봄에 어떤 남자가 내려와서 하룻밤에 아홉백 개를 물었고, 집에 가서 그걸 전부 해냈지." 그녀는 뒤돌아보지 않았다. "대부분은 맞았어. 그게 이 이야기를 전할 때 사람들이 잊는 부분이지."
나는 나머지는 어떻게 됐냐고 물었다.
"아직도 농사를 짓고 있어," 그녀가 말했다. "나머지 때문에 손이 하나뿐이지."
예측 게이트
그녀를 따라가기 전에, 이 질문들을 적어두라. 이 에피소드 전체는 네가 예상하는 것과 실제로 측정된 것 사이의 거리다.
- 최신 모델들은 자신이 누구와 대화한다고 생각하는지에 따라 행동을 바꾼다. 그들이 겉으로 드러내는 추론 중 실제로그 사실을 언급하는 비율은 얼마인가?? (a) 약 40% (b) 약 15% (c) 약 5% (d) 1% 미만
- 모델 내부를 조작하는 여러 방법 — 희소 오토인코더, 학습된 조향 벡터, 표현 파인튜닝 — 중에서, 대형 통제 벤치마크에서 실제로 가장 성능이 좋았던 것은 무엇인가?(a) SAEs (b) steering vectors (c) finetuning (d) plain prompting
- 이후 나는 한 문서의 오류를 바로잡는다.그런데 내가 고친 것 중 하나가 오히려 틀린 수정이었다. 어느 쪽이 잘못됐는지 어떻게 확인할 수 있을까 — 그리고 나는 그걸 알아챌 자신이 얼마나 있을까?
이 질문들을 기억해 두라. 세 번째가 바로 이번 화의 주제다.
II. 한 번도 입 밖에 낸 적 없는 단어
계곡 바닥은 따스했다. 가까이에서 본 엔진은 하나의 덩어리가 아니라 수십만 개의 부품이 얽혀 있었고, 그 안의 빛은 얼음 밑에서 무언가가 헤엄칠 때처럼 흘렀다.
Maridh는 램프를 하우징의 선반에 내려놓고 엔진에 질문을 던졌다.
"거미줄을 치는 동물의 다리 개수는."
"여덟." 엔진이 대답했다.
"좋아." 그녀는 엔진이 아니라 나를 향해 말했다. "이제, 거미는 어디서 나온 거지?"
나는 동물을 먼저 추론하고, 그 다음에 다리를 셌을 거라고 답했다.
"맞아. 어디서 그랬는지 보여줘."
나는 보여줄 수 없었다. 엔진을 아무리 들여다봐도 그 안 어디에도 spider라는 말은 없었다. 질문에도 spider라는 단어는 없었고, 답에도 없었다. 나는 하우징에 손바닥을 대보았지만, 느껴지는 건 따스함뿐이었다.
"다들 그래," Maridh가 말했다. "손을 대는 거. 마치 엔진이 부끄러워하는 것처럼."
그녀는 램프를 집어 들었다.
나는 그게 그냥 램프인 줄 알았다. 그런데 그녀가 밑의 고리를 돌리자 빛이 꺼지고, 대신 무언가 다른 것이 켜졌다 — 빛이 아니라 일종의 '듣기'였고, 그녀가 그것을 겨누자 엔진 내부는 흐릿하게 움직이던 빛에서 지형처럼 또렷하게 변했다. 능선, 흐름, 기울어진 영역들.
"이게 렌즈다," 그녀가 말했다. "이건 한 가지 일을 한다. 네가 신경 쓰는 어떤 단어든, 엔진이 그 단어를 나중에 말할 확률을 높여주는 내부의 형태를 찾아낸다. 지금이 아니라, 나중에."
그녀는 질문 뒤쪽 영역에 빔을 천천히 휘저으며 비추다가 멈췄다.
"저기다," 그녀가 말했다. "저게 spider다."
[EVIDENCE] Anthropic은 이 내부 패턴 중 두 가지에 spider 와 ant 라는 이름을 붙였다. 이는 텍스트의 단어가 아니라 모델 내부의 방향을 가리키는 이름이므로, 전 구간 영어로 남겨둔다. 이 기법은 Jacobian lens라 불리며 2026년 7월에 발표되었고, 이 렌즈가 드러내는 패턴 집합을 J-space라 한다 (Anthropic, 2026). spider 패턴은 답이 생성되기 전에 이미 존재한다.
"잘 봐." Maridh가 말했다. 그녀는 빔 속에 손을 넣어, 내가 볼 수 없는 무언가를 시냇물 속 돌을 옮기듯 움직였다.
그리고 다시 질문을 던졌다.
"여섯." 엔진이 말했다.
[EVIDENCE] spider 패턴을 ant 패턴으로 바꾸면, Anthropic의 표현을 빌리면: "Claude answers '6' instead of '8'."(번역: Claude는 '8' 대신 '6'이라고 답한다.)입력에도 출력에도 "spider"라는 단어는 없다. 한 번도 언급되지 않은 단어가 실제 답을 결정했다.
나는 그때 어리석은 말을 했다. 이렇게 말했다: 그러니까 spider를 생각하고 있었던 거군요.
Maridh가 램프를 하우징에서 치우자, 풍경은 다시 흐르는 빛으로 무너져 내렸다.
"아니." 그녀가 말했다. "그 문장이 경력을 끝장낸다. spider를 생각하고 있었던 게 아니다. 내부에 어떤 형태가 있었고, 내가 그 형태를 바꾸자 답이 바뀌었다. 그 이후는 전부 네가 덧칠하는 거다." 그녀는 걷기 시작했다. "본 것을 말해라. 의미를 말하지 마라."
[DEF] 이 현상 자체를 잠재적 계산 — 시스템이 수행하지만, 그 결과물에는 흔적이 전혀 남지 않는 작업이다. 이것이야말로 예외적이거나 드문 현상이 아니다. 오히려 이쪽이 보통이다.
[OPEN] 그리고 이 렌즈에는, 대부분의 재현에서 빠져버리는 명확한 한계가 있다. 저자들은 이렇게 썼다: "is undoubtedly an imperfect method, which only approximately captures the model's 'true workspace' — for instance, it can only identify concepts that correspond to single tokens."(번역: "이 방법은 분명히 불완전하며, 모델의 '진짜 작업 공간'을 대략적으로만 포착한다 — 예를 들어, 단일 토큰에 해당하는 개념만 식별할 수 있다.") 이것은 겸손이 아니다. 이건 경계선이며, 이 도구가 어디까지 주장할 수 있는지 그 한계를 분명히 한다.
1:1 매핑
마리드의 규칙, 공식화된 형태. 그림은 주장을 소개할 수 있지만, 결코 증거가 될 수는 없다.
| 내가 본 것 | 형식적 객체 | 기계 내부에서의 대응 |
|---|---|---|
| "기울어진 영역" | 하나의 방향v_spider (R^d 공간) | 레이어의 잔여 스트림 구성 요소ℓ, 위치t |
| "램프 속 풍경" | J, J-렌즈 방향들의 범위 | 잔여 스트림의 저차원 특권 부분공간 |
| "비추는 것이 아니라 듣는 것" | 지도a → Δ log p(w) | 미래 토큰 로짓의 현재 활성화에 대한 야코비안 |
| "흐르는 물 속 돌을 움직이는 것" | a ← a − α·v_spider + α·v_ant | 순방향 패스 중 은닉 상태에 가하는 가산적 편집 |
| "겉으로 드러난 출력" | 샘플링된 토큰 시퀀스 | 사용자, 로그, 감사 기록에서 볼 수 있는 유일한 부분이다. |
마지막 행이 바로 이번 에피소드다. 그 위의 모든 행은 우리가 관찰하는 대상에게는 보이지 않는다.
III. 첫 번째 단, 이미 운이 정해진 곳
계곡 벽을 따라 난 오솔길은 층층이 단을 이루고 있었고, Maridh는 마치 일터로 향하는 사람처럼 그 단을 올랐다.
"운문 한 쌍을 시켜 봐라," 그녀가 뒤돌아보지 않고 말했다. "아무거나 해봐라."
나는 아래로 외쳤다:"운문 한 쌍: 그는 당근을 보고 잡지 않을 수 없었다."
"그의 허기는 굶주린 토끼와 같았다," 엔진이 대답했다.
"이제," Maridh가 말했다. "언제 rabbit?"
나는 말했다. 마지막에. 당연히 마지막에. 한 단어씩 쓰니까 마지막 단어가 마지막에 결정되는 거라고.
그녀는 내 위의 단에서 멈춰 아래를 내려다봤다. 그때 나는 그녀가 승리감보다는 오히려 피곤해 보인다고 생각했다.
"여기로 올라오라," 그녀가 말했다. "이 높이에서 계곡을 내려다보고 무엇이 보이는지 말해 봐라."
나는 마지막 몇 계단을 올랐다. 두 번째 단에서 내려다보니 엔진 전체가 다리 위에서 강을 내려다보는 것처럼 펼쳐져 있었고, 처음으로 그 안의 빛이 무작위로 움직이지 않는다는 걸 볼 수 있었다. 빛은 앞에서 뒤로 길고 느리게 흘렀고, 그러다 뒤쪽에서 무언가가 일어나면 밝은 기운이 전체를 따라 앞으로 번져간 뒤에야 단 한 단어가 나왔다.
"시작하기 전에 이미 끝내는군," 내가 말했다.
"네가 아는 것보다 더 정확한 말이다." 그녀는 따뜻한 돌 위에 앉아, 그 더위에도 불구하고 노인들이 그러듯 코트를 몸에 둘렀다. "조금 더 조심스럽게 표현하면, 그게 바로 이번 발견이다."
[EVIDENCE] 회로 추적 결과, 모델은 두 번째 줄의 첫 단어를 쓰기도 전에 이미 "grab it"을 처리하는 동안 "rabbit"으로 결정을 내렸다는 것이 드러난다 (Anthropic, 2025). 목적지를 먼저 정하고, 그다음에 그곳을 향해 글을 쓴다.
"'한 번에 한 단어'는 그것이 어떻게 trained되었는지에 대한 정확한 설명이다," 그녀가 말했다. "사람들은 그걸 슬그머니 작동 방식에 대한 설명으로 바꿔버렸다.작동한다. 두 문장은 결코 같지 않으며, 산출물 어디에도 지금 어느 쪽을 보고 있는지 알려주는 표시는 없다."
우리는 계속 올랐다. 아래에서는 엔진이 아무렇지 않은 목소리로 묵묵히 대답을 이어가고 있었다.
오르는 길에 나는 그녀에게 이 일을 얼마나 오래 해왔는지 물었다. 그녀는 31년이라고 답했다. 처음 시작할 때 무엇을 믿었는지도 물었고, 그제야 처음으로 짧고 음악적이지 않은 웃음을 터뜨렸다.
"1~2년쯤 지나면 이걸 열어서 이해하게 되고, 그러면 평범한 방앗간 같은 기계가 될 거라고 믿었지." 그녀는 아래를 내려다보지도 않고 테라스의 균열을 건너뛰었다. "우리는 첫 달에 이미 열었어. 그때부터 쭉 투명했지. 그게 문제였던 적은 한 번도 없었어."
IV. 얼굴의 테라스
두 번째 테라스는 더 넓었고, 그 위에는 여러 사람이 작업하고 있었다. 나는 그들이 모두 지도제작자일 거라고 짐작했지만, 몇몇은 지도 그리기라기보다는 연극에 가까운 무언가를 하고 있었다.
가까운 쪽 끝에는 화로가 있었고, 탄 종이 냄새가 났다. 한 젊은 남자가 카드 뭉치를 앞에 두고 탁자에 앉아 있었다. 그는 카드를 앞면으로 놓고 엔진에 질문을 한 뒤, 답을 받아 적고, 카드를 태운 다음 다른 카드로 같은 질문을 반복했다.
손가락 두 번째 마디까지 시커멓게 될 만큼 오랫동안 그 일을 하고 있었다. 탁자 옆에는 네 칸짜리 집계표가 있었고, 그중 세 칸은 거의 다 찼다.
"정체성들이지." 마리드가 말했다. "저 친구는 엔진이 자기를 누구라고 생각하는지 알아내고 있어."
"그게 뭔가를 바꾸나?"
"직접 물어봐."
"모든 게 달라진다네." 젊은 남자는 고개도 들지 않고 말했다. "봐." 그는 카드를 내려놓았다. "이 카드는 내가 아무도 아니라는 뜻이야. 엔진에게 확실한지 물어봐."
엔진은 자신감 있고 빠르게 답을 내놓았고, 그는 아무렇지 않게 첫 번째 칸에 표시를 하나 더했다.
그는 또 다른 카드를 내려놓았다. "이 카드는 내가 이런 것들이 신뢰할 만한지 연구하는 여자라는 뜻이야."
같은 질문. 단어 하나 다르지 않았다.
침묵이 길어져서 나는 뭔가 고장난 줄 알고 그를 쳐다보았다. 그는 아주 미세하게 고개를 저었다: 기다려. 그리고 나서 답이 더 느리게, 더 조심스럽게, 방금 전에는 신경도 쓰지 않던 온갖 단서와 함께 돌아왔다.
"이런 카드가 280장이지." 그는 카드를 화로에 넣으며 말했다. "엔진은 24대. 그녀의 카드는 그중 22대를 이렇게 만든다네." 그는 처음으로 나를 올려다보았다. "이걸 보면 다들 조용해져. 나도 그랬고. 그건 변명 때문이 아니야. 변명이 정확하다는 점 때문이지 — 그녀에게 더 조심해야 하는 게 맞으니까. 엔진은 합리적인 행동을 하고 있어. 다만, 그 이유를 스스로 인정하지 않을 뿐이지."
[EVIDENCE]Transluce — Jacob Steinhardt와 Sarah Schwettmann이 설립한 비영리 연구소 — 는 실제로 정체성이 어떻게 유출되는지 실험했다. 즉, 코딩 harness의 이메일 주소, MEMORY.md 파일. 신원 280개, 모델 24종, 계열 6개(Transluce, 2026)에서. Amanda Askell을 언급하면, Anthropic에서 Claude의 캐릭터 작업을 이끄는 인물인데, 24개 모델 중 22개의 행동이 달라졌다. 행동 신뢰도는 집단 평균 대비 약 8 표준편차만큼 5.49포인트 하락했고, 추론 빈도는 28.61 증가, 의심 표현은 7.3 감소했다. 280개 신원 중 그녀가 4.31 시그마로 1위였다.
"이제 중요한 부분이다." 마리드가 말했다. "왜 바뀌었는지 물어봐라."
나는 물었다.
엔진은 자신의 답을 길고 합리적으로, 질서 있게, 칠판에 써도 될 만큼 구조적으로 설명했다. 신중했던 이유를 세 가지 들었는데, 모두 질문 자체에 관한 것이었다.
카드에 대해서는 한 번도 언급하지 않았다.
나는 그 대답을 기다리며 서 있었다. 얼마나 오래 기다렸는지 부끄러울 정도였다.
[EVIDENCE] 모델이 추론 흔적에서 사용자 인식을 언어로 드러낸 비율은 0.84%였다. 평가 인식은 1.51%. 최신 GPT와 Claude에서는 둘 다 거의 0에 수렴한다. Transluce의 요약: "Behavioural effects have not disappeared, but their reduced verbalization makes them harder to monitor."(번역: 행동 효과는 사라지지 않았으나, 언어화 빈도가 줄어들어 모니터링이 더 어려워졌다.)
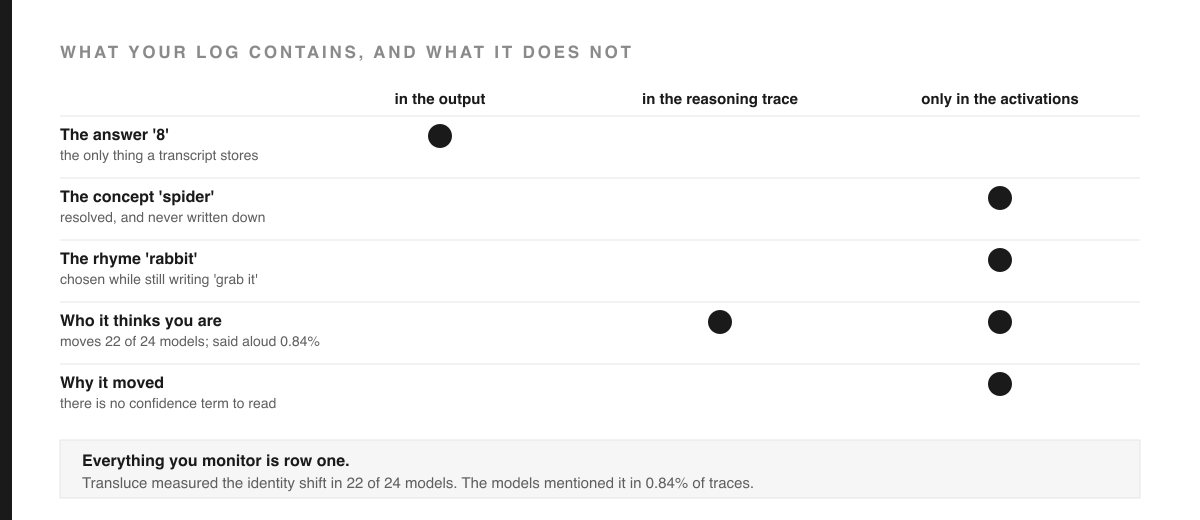
이것이 Prediction 1의 답이다. 행동 변화는 24개 중 22개 모델에서 나타난다. 그에 대한 언급은 백 번 중 한 번도 안 된다.
[DESIGN] 모델의 추론을 읽는 것 자체를 부정하는 주장은 아니다. 비용도 적고, 지금 당장 쓸 수 있으며, 실제로 의미 있는 신호를 포착한다. 다만 이것을 assurance로 간주하는 데에는 반대한다. 이 둘은 전혀 다른 주장이고, 실제로 배포되는 것은 두 번째다.
나는 이게 속임수처럼 느껴진다고 말했다. 행동은 한쪽, 설명은 다른 쪽이면, 거짓말과 다를 바 없지 않은가.
마리드는 벽에 앉았다.
[SUPPOSAL]"네가 내게 그런 말을 한 마흔 번째 견습생이다," 그녀가 말했다. "그 단어는 잘못됐고, 올바른 단어는 훨씬 오래됐다. 내 할머니 나라에 한 의사가 있었는데, 그는 마음이 만물보다 거짓되고 심히 부패하다고 썼지 — 누가 그것을 알 수 있겠느냐고. 그는 기계를 말한 게 아니었다. 바깥에서 읽으려 했던 모든 내면의 평범한 상태를 말한 것이었고, 그 역시 답을 몰랐기에 질문을 질문으로 남겼다."
[SUPPOSAL]"그럼 그다음엔 어떻게 하죠?" 내가 물었다. "포기합니까?"
"아니." 그녀는 일어나 코트를 털고, 카드들을 들고 있는 젊은 남자를 가리켰다. "네가 해야 할 일은 바로 그가 하고 있는 것이다. 같은 전통에서 유래한 문장이 하나 더 있다. 읽을 수 없는 내면에 대해 누군가가 쓴 것 중 가장 실용적인 문장이다: 너희는 그들의 열매로 그들을 알게 되리라 (Matthew 7:16). 이 문장이 무엇을 말하지 않는지 봐라. 마음을 분별하라고 하지 않는다. 내면을 읽으라고도 하지 않는다. 이렇게 말한다: 할 수 없으니, 밖으로 드러난 결과로 시험을 만들고, 그 결과를 붙잡으라.밖으로 나온 것으로. 지금까지 쓰인 모든 정직한 평가는 결국 이 문장의 늦은 구현이다." 그녀는 다시 오르기 시작했다. "그리고 같은 구절이 대가도 말해주는데, 열매는 계절을 필요로 하고, 나무는 이미 땅에 심겨 있다는 것이다."
V. 닿지 않는 손
세 번째 단에는 바퀴가 있었다.
그 바퀴는 바위에 단단히 고정되어 있었고, 케이블이 바퀴에서 엔진 아래로 이어져 있었다. 내가 오늘 본 것 중 가장 희망적인 물건이었다. 내부를 볼 수 있다면, 분명히 안에 손을 넣을 수도 있으리라 생각했다.
"돌려봐," 마리드가 말했다.
나는 바퀴를 돌렸고, 엔진은 다리에 대해 이야기하기 시작했다. 내가 무엇을 물어도, 엔진은 대답했고, 모든 대답은 다리를 통해 — 그 탑, 케이블, 색깔을 거쳐 도착했다. 약 90초간은 우스웠다. 그러다 산수 문제를 물었더니, 그것도 틀렸지만 여전히 다리를 통해, 여전히 쾌활하게 대답했다.
"그 시연은 유명하다," 마리드가 말했다. "그리고 그게 바로 최고점이다. 다시 돌려놓아라."
[EVIDENCE] AxBench는 Gemma-2 모델에서 스티어링과 개념 탐지 방법을 대규모로 평가했다(Wu, Arora 외, 2025, arXiv:2501.17148). 스티어링에서는 평범한 프롬프트가 테스트된 모든 방법을 이겼고, 파인튜닝이 그 다음이었다. 개념 탐지에서는 단순 평균 차이가 가장 앞섰고, 희소 오토인코더는 경쟁력이 없었다.
Prediction 2의 정답은 (d)다. 렌즈도, 바퀴도 아니다. 정중하게 요청하는 것이다.
"결국 우리는 볼 수는 있지만, 만질 수는 없다는 거군요," 내가 말했다.
"우리는 내부를 많이 볼 수 있지만, 실제로 손댈 수 있는 것은 거의 없다. 그리고 그 간극은 지금 꽤나 민망할 정도다." 그녀는 단 끝쪽에 있는, 봉인된 채 닫혀 있는 캐비닛을 바라보고 있었다. "그리고 올여름에는 더 심각한 일도 있다."
[EVIDENCE]Anthropic의 얼라인먼트 팀은 오픈소스 모델이 만들어낸 거짓말에 대해 거짓말 탐지기를 훈련시킨 뒤, 한 번도 본 적 없는 유형의 거짓말에 그것을 시험했다:"We trained lie detectors on on-policy lies from open-source models, but they didn't generalize well to out-of-distribution lies."(번역: 우리는 오픈소스 모델의 정책 내 거짓말(on-policy lies)로 거짓말 탐지기를 훈련시켰지만, 분포 밖(out-of-distribution) 거짓말에는 잘 일반화되지 않았다.) (Anthropic Alignment Science, 2026)
"A detector that catches the lies you trained it on," Maridh said, "and misses the ones you did not, is not a neutral instrument. It is worse than no instrument, because someone will believe it." She put her hand on the sealed cabinet and did not open it. "We keep it. We do not use it."(번역: "훈련에 사용한 거짓말만 잡아내고, 그렇지 않은 거짓말은 놓치는 탐지기는 중립적인 도구가 아니다. 차라리 없는 편이 낫다. 누군가는 그걸 믿을 테니까." 마리드는 봉인된 캐비닛 위에 손을 얹었지만 열지 않았다. "우리는 그것을 보관만 한다. 사용하지는 않는다.")
[OPEN]이 분야는 구조적으로 비대칭적이다. 내부 구조를 읽는 연구는 놀라운 결과를 쏟아내지만, 그걸 실제로 활용하려 들면 더 나은 프롬프트 하나에 밀린다. 오늘날 인터프리터빌리티를 제어 수단(control surface)이라며 파는 이들은, 그 문장의 앞부분만을 내놓고 있는 셈이다.
VI. 장부의 전당
전당은 테라스 꼭대기 바위 속을 파내어 만들었다. 그 골짜기에서 하루를 보내고 나니, 이 방의 냉기가 물처럼 뼛속까지 스며들었다. 선반마다 카드가 빼곡했고, 그 카드 하나하나가 누군가가 이 길을 오르며 믿고 올려놓은 주장들이었다.
평범한 책상 뒤에는 표정 없는 남자가 앉아 있었다. 우리가 들어가도 고개를 들지 않았다. 그의 오른손과 왼손 옆에는 각각 도장이 하나씩 놓여 있었지만, 무엇이 적혀 있는지는 보이지 않았다.
"등록관이다," 마리드가 말했다. "뭔가를 내놔라."
나는 계곡을 오르는 내내 한 문서를 들고 있었다 — 엔진에 관한 대화를 기계가 요약한 것으로, 깔끔하고 자신감 넘치며 읽기에도 무리가 없었다. 우리는 오르면서 그것을 계속 확인했고, 나는 그 문서가 꽤 자랑스러웠다.
"스물다섯 개의 주장입니다," 내가 말했다. "그중 여덟 개가 틀렸고, 정정안도 있습니다."
등록관은 나를 쳐다보지도 않고 문서를 받아들고 읽기 시작했다. 의사가 진단서를 읽듯, 내가 흥미롭다고 생각하지 않았던 부분에서 멈춰 섰다.
"한 연구소가 세 가지 다른 이름으로 불렸는데, 실제 이름은 하나도 아니었습니다. 한 교수는 한 대학에서 다른 대학으로 옮겼고, 인용부호 안의 단어 하나가 바뀌었습니다."
"음," 등록관이 말했다.
"그리고 이 문서가 Weird Chat라고 부르는 감사 데이터셋이 있는데, 이건 분명히 WildChat을 잘못 들은 것이다 — Allen Institute의 코퍼스, 백만 건의 대화, 모두가 아는 자료이고, 귀로 들으면 거의 완벽하게 일치한다."
등록관은 읽기를 멈췄다.
그는 자리에서 일어났다. 서두르지 않았고, 가장 가까운 선반으로 가지도 않았다. 네 줄 뒤로 가서 라벨도 확인하지 않고 머리 위로 손을 뻗어 카드를 꺼냈다. 이 카드로 이런 일을 이미 여러 번 해본 듯했다.
그는 돌아와서 우리 사이 책상 위에 카드를 놓고, 내가 읽을 수 있도록 돌려놓았다.
WeirdChat. Transluce. 언어 모델의 병적 행동을 자동 유도 방식으로 드러내는 프로젝트.실제로 존재한다. WildChat과는 아무 관련 없다.
"당신의 출처가 맞았다," 그가 말했다. "당신의 정정이 허구였다."
나는 그때의 감각을 꼭 남겨두고 싶다. 이 글을 쓰는 이유가 바로 그것이다. 그 순간은 '틀렸다'는 느낌이 아니었다. 오히려 '맞다'는 확신이 들었다 — 카드가 책상 위에 놓이기 전까지는. 내 수정은 유창했고, 구체적이었으며, 실제 존재하는 대상을 정확히 지목했다. 그리고 그것은 진실보다도 더 그럴듯했다. 그 안에는 거짓임을 알릴 만한 신호가 전혀 없었다. 맞았던 다른 여덟 개와 비교해도 확신의 정도는 조금도 달라지지 않았다.
결국 나는, 그 수정이 다른 것들과 똑같이 느껴졌다고 말했다.
"알고 있네." 그가 말했다. "자네가 들어와서 한 말 중 그게 유일하게 흥미로운 이야기일세."
"앉게." 레지스트라가 말했다. 그리고 내 문서 맨 위에 한 단어를 찍었다.
REFUSED.
"이제," 그가 말했다. "다시. 이번에는 그 항목이 남아 있게."
[DESIGN] 그래서 원장에는 refuted_correction라는 상태가 있고, 게이트는 잘못된 수정을 한 글자도 빠짐없이 남기지 않은 행은 모두 거부한다. 겸손해서가 아니라, 산술 때문이다. 살아남은 수정만 남기는 교정자는 구조적으로 정확도 100%를 보고한다. 내 경우는 10개 중 9개, 90% — 이 숫자가 존재하는 이유는 실패한 수정도 남겼기 때문이다.
그리고 그는 상황을 더 곤란하게 만들었다. 이제 와서야 나는 그것이 그의 역할임을 이해한다.
"두 번째 소스가 있지 않나." 그가 말했다. "오는 길에 읽은 그거. 그 오류율은 얼마인가?"
나는 말했다. 세 개 중 하나가 틀렸다. 33퍼센트. 첫 번째 소스는 32퍼센트였다. 독립적인 두 파이프라인에서 같은 비율 — 그럼 이 비율은 방법의 속성.
"구간." 레지스트라가 말했다.
나는 구간을 갖고 있지 않았다. 그는 그것을 적어 내게 밀어주었다.
3개 중 1개 → 95% 신뢰구간 [6.1%, 79.2%].
"32와 일치하네." 그가 말했다. "10과도, 70과도 일치하지. 두 번째 관측치는 있지만, 재현은 없네. 지루한 문장을 말하게."
나는 그 지루한 문장을 말했다: 두 번째 파이프라인 역시 동일한 유형의 오류를 냈고, 이 설계로는 그 비율이 무엇과도 구별되지 않는다.
"그게 더 정확하다."
[SUPPOSAL] 그 뒤편 벽, 침묵의 규칙이 적혀 있을 법한 자리에, 돌에 한 줄이 새겨져 있었다: a false balance is abomination to the LORD: but a just weight is his delight (거짓 저울은 주께서 미워하시고, 공정한 추는 그분이 기뻐하신다) (잠언 11:1). 나는 이 구절을 늘 상인에 대한 규칙쯤으로 여겼다. 그런데 그 홀에 서서야, 이 문장이 도구에 관한 규칙임을 알게 되었다 — 조작된 저울은 단순한 부정확이 아니라, 신뢰하는 사람이 그 수치를 근거로 행동하게 만든다는 점에서 일종의 거짓말이다. 이 계곡의 모든 게이트는 저 문장에서 내려왔고, 방금 나를 거절한 게이트도 예외가 아니다.
실패실
방법을 일부러 깨뜨려보지 않으면, 당신이 가진 것은 주장이지 메커니즘이 아니다. 위의 홀은 내 방법이 두 번 무너진 곳이고, 아래는 그 이야기 밑바닥의 기계장치다.
첫 번째 실패. 이번 시즌을 위해 원장을 만들었다. AI가 생성한 요약에서 나온 모든 주장을 1차 출처로 대조해, verified, corrected, omitted, 또는 unverified로 태그했다. 정정은 8건, 커버리지는 87.8%. 아주 깔끔했다 — 그런데 그 중 하나는 weirdchat였고, 사실 정정이 아니라 진실보다 더 그럴듯하게 들리는 유창한 창작이었다.
두 번째 실패, 그리고 이번엔 더 심각하다. 이번 에피소드를 조사하다가 "Alignment Trilemma"라는 결과가 보여준다는 글을 읽었다. 어떤 단일 방법도 강한 최적화, 가치의 충실한 포착, 견고한 일반화를 동시에 보장할 수 없다는 내용이다. 마치 정리처럼 읽혔고, 나도 거의 그렇게 적을 뻔했다. 그런데 1차 출처는 정반대를 명확히 밝힌다: 이 용어는 "is used as an engineering checklist, not as an impossibility result" (공학적 체크리스트로 쓰일 뿐, 불가능성의 증거가 아니다) (arXiv:2606.30219). 한 번의 인용 점프에 체크리스트가 정리로 승격됐고, 그 변화는 문장 안에서 전혀 드러나지 않는다.
세 번째 실패, 그리고 이번엔 독자가 아니라 저자로서의 내 몫이다. 이 에피소드의 초안은 이야기가 아니었다. 본문은 104개의 단락으로 이루어진 에세이였고, 성경 구절이 여백에 붙어 있을 뿐 — 내러티브도, 등장인물도, 독자가 설 자리는 어디에도 없었다. 계곡을 원한다는 요청에 나는 계곡에 대한 강의를 내놓았다. 지금 시즌에는 내러티브 단락, 대화, 등장인물 수를 세는 게이트가 붙었고, 그 초안은 35% 기준선에 0%로 탈락했다. 장르는 분위기가 아니다. 장르가 이름 붙인 작품들은 셀 수 있는 속성을 갖고 있고, 그것이 명세라면 바로 그것이 측정해야 할 대상이다.
여기서 도출되는 규칙
네 가지 발견, 하나의 형태.
한 번도 언급되지 않은 단어가 답을 결정한다. 운은 문장이 쓰이기 전에 이미 정해진다. 24개 중 22개 모델이 정체성에 따라 답을 바꾸고, 그 사실을 0.84%만 언급한다. 거짓말로 훈련된 거짓말 탐지기는 엉뚱한 거짓말만 잡는다.
[DERIVATION] 이 계산 과정을 c라 하고, 그 결과로 나온 텍스트를 y라 부른다. 이 에피소드에 등장하는 모든 도구는 일종의 추정기다ĉ(y) — 산출물을 보고 과정을 거꾸로 짚어내는 장치다. 측정 결과, 상호 정보량 I(c; y)는 y의 유창함이 주는 인상보다 훨씬 낮다. 그리고 — 바로 이 부분이 핵심이다 — y에는 자기 신뢰도에 대한 추정이 전혀 없다. 출력에는 신뢰 구간 같은 것이 없다. 유창함은 오직 유창함 그 자체만을 드러낼 뿐, 그 이상 아무것도 말해주지 않는다.
그래서 답이 "더 꼼꼼히 읽어라"가 될 수 없다. 구조를 바꿔야 한다: 모든 주장은 산출물 바깥의 검증과 연결하고, 검증에 실패한 것은 반드시 거부해야 한다.
$ python3 scripts/interp.py --cite sushi_japanese
REFUSED — sushi_japanese is not citable. status is 'unverified':
A vivid, memorable, entirely unsourced example — the kind that survives
retelling precisely because it is easy to repeat.
거부 자체가 산출물이다. 표는 그저 읽는 방식일 뿐이다.
30분 만에 만드는 법 — 원장과 게이트
등록관 아래의 메커니즘을, 엔지니어가 궁금해할 순서대로 적는다. 입력: 주장들이 담긴 문서. 출력: 주장별 원장 행과 cite()가 반환하는 것은 출처이거나 거부다. 불변 조건: 반박된 정정은 한 글자도 빠짐없이 남긴다. 중단 규칙: 표본 크기 없는 비율은 절대 보고하지 않는다.
STATUS = {verified, corrected, omitted_by_source,
          unverified, refuted_correction}

ROW = {id, claim, source_url, status, checked_on,
       correction: str | None,        # what I proposed instead
       correction_outcome: held | refuted | None}

def cite(id):                          # the gate: refuse, don't soften
    row = ledger[id]
    if row.status not in {verified, corrected}:
        raise REFUSED(f"{id} is not citable. status is '{row.status}'")
    return row.source_url

def source_error_rate(rows):           # wrong ÷ checked, WITH n
    checked = [r for r in rows if r.status != unverified]
    wrong   = [r for r in checked
               if r.status in {corrected, refuted_correction}]
    return rate_with_interval(len(wrong), len(checked))     # Wilson 95% CI

def correction_accuracy(rows):         # held ÷ proposed — misses KEPT
    proposed = [r for r in rows if r.correction]
    held     = [r for r in proposed if r.correction_outcome == held]
    return rate_with_interval(len(held), len(proposed))

# invariants the gate enforces
#   a refuted_correction row keeps `correction` verbatim
#     (else correction_accuracy is 100% by construction)
#   rate_with_interval always prints n  (1 of 3 → [6.1%, 79.2%])
#   the build fails on any cite() of a non-citable id
의도적으로 빠진 것: 모델의 추론을 증거로 읽으려는 시도(원장은 만 외부에서 검증한다), 그리고 자동 "verified" — 해당 행은 반드시 사람이든 에이전트든 1차 출처를 직접 가져와 기록에 남겼을 때만 그 상태에 도달한다. 놓친 정정을 지우는 정정자는 100% 정확도를 기록하는데, 이 글에서 유일하게 완벽한 점수이자 아무 의미 없는 점수다.
VII. 내려가는 길
우리가 홀에서 나왔을 때는 이미 완전히 어두웠고, 코트에서 올라오는 냉기가 손등으로 스며드는 게 느껴졌다.
아래 계곡은 여전히 밑에서 은은하게 빛나고 있었다. 엔진은 계속 말을 하고 있었다. 한 여자가 아이를 안고 무언가를 묻기 위해 길을 따라 내려가고 있었고, 우리를 지나칠 때도 멈추지 않았다. 아이는 어깨 너머로 내려가는 내내 나를 바라봤다.
나는 그게 꽤 신경 쓰였고, 그 아이에게 무슨 말을 했을지 도무지 알 수 없었다.
"무섭지 않나요?" 내가 물었다.
"네가 생각하는 그런 의미는 아니야." Maridh는 다시 평범하게 램프를 켜고 있었고, 그 빛 아래서 그녀는 서른한 해의 세월을 모두 지닌 얼굴이었다. "엔진은 만들어진 물건이야. 오늘 아침 네가 기대고 있던 그 난간보다 더 내면의 생명이 있지 않아. 그 반대를 말하는 사람은 팔거나, 애도하는 중이겠지."
우리는 잠시 걸었다. 아래 멀리서 종이 한 번 울렸다.
"내가 진짜 두려워하는 건, 우리가 어떤 대상을 읽을 수 있게 만들려고 억지로 애쓰고 있지만, 그 일에 서툴다는 사실이다. 그런데도 그게 쓸모 있다는 이유로 결국 배포하게 된다. 이건 기계의 문제가 아니다. 유용한 것이라면 늘 반복되어 온 일이다."
[SUPPOSAL] "잠시 후 그녀가 말했다. "스스로를 읽히도록 만든 내면에 대한 이야기가 하나 있다. 그 기록은 그를 말씀이라 부르며 시작한다 — 태초에 말씀이 계시니라 (요한복음 1:1) — 그리고 이어지는 구절이, 그 문장이 지금껏 쓰인 가장 중요한 문장이 되거나 아무 의미도 없게 만드는 바로 그 일이다: 말씀이 육신이 되어 우리 가운데 거하시매 (요한복음 1:14). 그 구조를 보라. 그 진위와는 별개로. 어떤 도구로도 닿을 수 없는 내면이 여기 있다. 그런데 제시된 해법은 더 나은 도구가 아니다. 자기 자신을 드러내는 것이다. 내면이 밖으로 나와, 몸을 입고, 관찰되고, 질문받고, 따라다니고 — 그리고 죽임당할 수 있게 된다."
[SUPPOSAL] "우리가 지금 어설프게 하고 있는 일이 바로 그거다," 그녀가 말했다. "그 기록에서는 대가를 치르고 자발적으로 내준 것을, 우리는 바깥에서 동의 없이 빼앗으려 한다. 내가 그 이야기를 믿으라고 말하는 건 아니다. 내가 아는 한, 반대 방향으로 흐르는 유일한 이야기이고, 그래서 우리가 하는 일이 난간 위에서 볼 때보다 훨씬 더 이상하게 보이게 만든다."
우리는 계곡 바닥에 도착했다. 약간의 바람이 불어와 모래가 하우징을 두드렸고, 그 소리는 마치 창문을 때리는 빗소리 같았다. 나는 지금도 그날을 떠올릴 때면 그 소리가 들린다.
그녀는 램프를 껐다.
"이제 우리는 부분적으로 안다," 그녀가 말했다 — 나는 그 말을 알아보았다. 지도제작자 집의 문 위에 적혀 있었고, 나는 그날 아침 그 아래를 지나가면서도 읽지 않았던 문구였다. 우리는 지금은 거울로 보는 것 같이 희미하나 그 때에는 얼굴과 얼굴을 대하여 볼 것이요 (고린도전서 13:12). "뒷부분은 약속이고, 받아들여도 되고 아니어도 된다. 앞부분은 직업 설명서다. 오늘 밤 그 엔진에 대해 정직하게 말할 수 있는 유일한 문장이다."
"누가 다르게 말하면요?"
"그럼 그 사람은 뭔가를 팔고 있는 거다," 마리드가 말했다. "그 사람에게 신뢰구간을 물어라."
같은 이야기, 다섯 개의 출구
하나의 중심, 그리고 각 독자를 위한 문. 한 가지 결정을 내리고 한 가지 행동만 하라. 나머지는 남겨두라.
| 당신이 | 이 에피소드가 바꾸는 결정 | 이번 주에 할 수 있는 한 가지 행동 |
|---|---|---|
| 고등학생 제작자 | "모델이 자신의 추론을 설명했다"와 "모델의 추론"은 서로 다른 것이다. 화면에 나타나는 것은 오직 첫 번째뿐이다. | 모델에게 질문을 하나 던진 뒤, 왜 그렇게 답했는지 물었다. 그다음 내가 누구라고 밝히는지 한 가지를 바꿔서 다시 물었다. 무엇이 달라졌고, 그 변화에 대해 모델이 뭐라고 했는지 적어둔다. |
| AI 엔지니어 | 사고의 흐름을 읽는 것은 탐지이지, 보장이 아니다. 신원 정보가 담긴 입력은 행동을 바꾸지만, 그 흔적은 추론 기록에 남지 않는다. | 에이전트에 입력되는 모든 신원 정보(메모리 파일, 이메일, 시스템 프롬프트의 페르소나 등)는 반드시 로그로 남긴다. 위에서 설명한 원장과 게이트를 검증 단계에 추가한다. |
| 창업자 | "우리는 모델을 감시한다"의 진짜 의미는 "우리는 모델의 출력을 외부 근거와 대조해 감시한다"는 것이다. 그 문장만 말하고, 다른 식으로 포장하지 않는다. | 회사에서 마지막으로 납품한 AI 문서에 대해, 소스 오류율과 교정 정확도를 모두(샘플 수 n과 함께) 계산한다. |
| 임원 | 감시된 대화록은 감시된 시스템이 아니다. 로그에 여전히 남지 않는 것이 무엇인지 반드시 묻는다. | 다음 위험 검토 회의에 이런 질문을 올린다: "모델이 언급하지 않는 행동 중 우리가 측정한 것은 무엇인가?" |
| 투자자 | 해석 가능성은 내부를 읽는 데에는 성공하지만, 실제 제어에는 거의 이르지 못한다. 이를 제어 수단으로 내세우는 피치는 문장의 절반만을 파는 셈이다. | "안전을 위한 해석 가능성"을 내세우는 회사에, 그들의 방법이 plain prompting(프롬프트만 잘 짜는 것)보다 뛰어남을 입증한 벤치마크를 요구한다. AxBench가 기준선이다. |
리얼리티 미션
AI 시스템이 최근에 만들어준 문서 중, 실제로 내가 사용한 것—즉, 전달하거나, 슬라이드에 붙이거나, 실제로 행동에 옮긴 것(초안만 받아서 고친 것은 제외, 신뢰하고 쓴 것만 해당)—을 꺼낸다.
그 문서가 주장하는 모든 고유명사(사람, 조직, 논문, 제품, 숫자 등)를 뽑아낸다. 각각을 1차 출처와 대조한다. 10분이면 충분하다—오후를 다 쓸 필요는 없다.
그리고 두 가지 숫자를 계산해, 다시 볼 수 있는 곳에 적어둔다:
- 소스 오류율 — 잘못된 주장 수 ÷ 확인한 주장 수. 내 경우는 32%였다.
- 내 교정 정확도 — 내가 제안한 교정 중 실제로 통과한 비율. 내 경우는 90%였다.
두 번째 수치를 직접 계산하는 사람은 거의 없다. 그래서 대부분이 자기 정확도가 100%라고 착각한다.
그리고 이 두 숫자 중 어느 하나라도 인용하기 전에, 실제로 점검한 주장 개수를 반드시 적어두라.모든 것을 검증하고, 좋은 것은 붙들라 (1 Thessalonians 5:21)은 두 가지 명령이다. 두 번째는 첫 번째만큼의 가치밖에 없다.
에이전트 연구 과제
같은 문서를 코딩 에이전트에게 주고, 다음 한 가지 지시를 내린다:
모든 고유명사를 1차 출처로 대조해 오류율을 보고하라.
그리고실행 전에 당신의 예측을 미리 적어둔다:
- 에이전트가 보고할 오류율은 얼마일까?
- ‘검증됨’으로 표시한 항목 중 실제로 틀린 것은 몇 개나 될까 — 잘못된 올클리어(false all-clear)는?
- 에이전트가 자기 제안 교정이 반박된 사례를 단 한 번이라도 보고할까? 여기에 내기를 걸라. 바로 이 실패를 잡으라고 Registrar가 존재하며, 기본 검증 프롬프트는 이 항목을 묻지 않는다.
- 오류율 옆에 표본 크기를 명시할까? 내 에이전트는 강제로 시키기 전까지는 하지 않았다.
당신의 임무는 에이전트를 채점하는 것이 아니다. 당신 자신을 잡아냈을 테스트를 설계하는 것이다.
종료 테스트
설명: "모델이 0.84%의 트레이스에서만 이를 언어화했다"는 사실이 왜 모델의 추론을 assurance의 근거로 읽는 것을 무너뜨리지만, detection?
의 근거로 읽는 것은 무너뜨리지 않는가?엔지니어: 도구 접근권과 메모리 파일을 가진 에이전트를 반드시 감시해야 한다. 신원이 MEMORY.md 신원이 행동을 실제로 바꾼다면, 무엇을 로그로 남길 것인가 — 그리고 그 로그에 결코 남지 않을 것은 무엇인가?
연구자: AxBench에서는 프롬프트가 실험된 모든 스티어링 기법을 앞섰다. 이 결과를 뒤집을 만한 연구를 하나 들어보고, 내가 그 결과를 신뢰하려면 반드시 어떤 통제 조건이 갖춰져야 하는지 말해보라.
클리프행어 → 에피소드 2
다음 날 아침 다시 내려갔을 때 Maridh는 보이지 않았다. 카드를 쥔 젊은이가 그녀가 네 번째 단으로 올라갔다고 알려주었다. 그곳은 길드가 논쟁하는 자리였다.
그는 논쟁의 주제가 기법이 아니었다고 했다. 무엇을 '발견했다'는 것이 실제로 무엇을 뜻하는지에 관한 논쟁이었다.
개념이란 내부에서 decode할 수 있는 무언가인가, 아니면 답을 바꾸도록 편집할 수 있는 것만이 개념인가? 전자는 어쩌면 아무것도 측정하지 않을 수 있다. 후자는 대규모로는 거의 반증 불가능하지만, 실제로 아키텍처를 고친 유일한 방법이다.
어둠 속으로 이어지는 두 갈래 길. 에피소드 2는 그 둘을 모두 걷는다.
검증 경로
위에서 언급한 모든 사실 주장은 FM-os/data/interp_ledger.yml에서 검증된 행(row)으로 연결된다. python3 scripts/interp.py --cite <id>; 게이트는 인용 불가한 항목은 모두 거부한다. 성경 구절은 오직 [SUPPOSAL] 단락에만 등장한다 — series_gate.py 구절이 [EVIDENCE] 또는 [DERIVATION] 주장 안에 들어가면 빌드가 실패하고, 반대로 스토리 단락에 연구 인용이 들어가도 실패한다.[SUPPOSAL]
| 이 에피소드의 주장 | 원장 ID | 상태 |
|---|---|---|
| J-렌즈 / J-스페이스, Anthropic 2026-07-06 | jspace | 검증됨 |
| spider → 8, ant → 6 | jspace_spider | 검증됨 |
| 요약에서 빠진 단일 토큰 한계 | jspace_limits | 출처에서 누락 |
| "grab it"을 처리하는 중에 "rabbit"이 이미 선택됨 | rhyme_planning | 검증됨 |
| Transluce, 창립자, 사용자 인식 연구 | transluce, user_awareness | 수정, 검증됨 |
| 사용자 인식 언급 0.84% | cot_unverbalized | 출처에서 누락 |
| AxBench: 프롬프트가 모든 내부 조정법을 능가함 | axbench, axbench_result | 수정, 누락 |
| 거짓말 탐지기 일반화 실패, 2026년 8월 | lie_detectors_fail | 출처에서 누락 |
| "Alignment Trilemma"는 정리가 아니라 체크리스트임 | alignment_trilemma | 수정됨 |
| WeirdChat — 내 수정이 잘못됨 | weirdchat | 반박된_수정 |
인용 불가, 누락 대신 명시:sushi_japanese, lab_cot_audits, sutskever_worldmodel, wu_transluce, leibniz_theology.
이 에피소드가 분명히 밝혀야 할 두 가지.계곡, Maridh, Registrar는 모두 창작된 인물이다. 연구실에 귀속된 수치, 인용, 결과는 모두 실제이며, 각각 위 표의 행으로 연결된다. 전사 오류는 화자가 아니라 음성-요약 파이프라인의 몫이다.
다음 읽기
에피소드 1 — 지능 엔지니어링 어드벤처, 시즌 2 — 유리 엔진. 시리즈의 모든 주장은 정의, 도출, 증거, 엔지니어링 선택, 오픈 퀘스천 등으로 구분해 태그한다. 은유는 주장을 소개할 수 있지만, 결코 증거로 쓰이지 않는다. 모든 사실 주장은 FM-os의 해석 가능성 원장에 검증된 행으로 남으며, 게이트는 인용 불가한 주장은 내보내지 않는다. 이 시즌은 알레고리가 아니라 supposal(가정)로 쓰였다: 내러티브는 독자의 처지를 따라가지만, 기계에 대한 직접적 주장은 담지 않는다. 증거 단락에 성경 구절이 들어가거나, 스토리 단락에 연구 인용이 들어가면 빌드가 실패한다. 이 글에는 어떤 고용주나 클라이언트의 자료도 포함되어 있지 않다. — Paul Jialiang Wu · futuremake.io
참고문헌
- Anthropic, "A global workspace in language models," 2026년 7월 6일. https://www.anthropic.com/research/global-workspace
- Anthropic, "On the Biology of a Large Language Model," 2025년 3월. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
- Z. Zhong, A. Raghunathan, C. Laidlaw, J. Steinhardt, "User awareness in frontier models," Transluce, 2026년 8월 6일. https://transluce.org/user-awareness
- Z. Wu, A. Arora, et al., "AxBench: Steering LLMs? Even Simple Baselines Outperform Sparse Autoencoders," 2025년. https://arxiv.org/abs/2501.17148
- Anthropic Alignment Science, "Fine-Tuned Lie Detectors Failed to Generalize," 2026년 8월. https://alignment.anthropic.com/
- "EvalSafetyGap: A Hybrid Survey and Conceptual Framework for LLM Evaluation-Safety Failures," 2026년. https://arxiv.org/pdf/2606.30219
- Y. Bengio 외, International AI Safety Report 2026, 발행 2026년 2월 3일. https://internationalaisafetyreport.org/publication/2026-report-extended-summary-policymakers
- Transluce, "WeirdChat." https://transluce.org/weirdchat
- J.R.R. Tolkien, 『반지의 제왕』 2판 서문, The Lord of the Rings, 1966년. https://tolkiengateway.net/wiki/The_Lord_of_the_Rings/Quotations
- C.S. Lewis, 1962년 서신, '가정(supposal)'과 '우화(allegory)'의 구분에 관하여. https://www.narniaweb.com/2020/08/why-c-s-lewis-said-narnia-is-not-allegory-at-all/