AI-Nativeシリーズ 解釈性とアラインメント 第1話(全5話)
解釈性――モデルが書くものは、計算したものではない
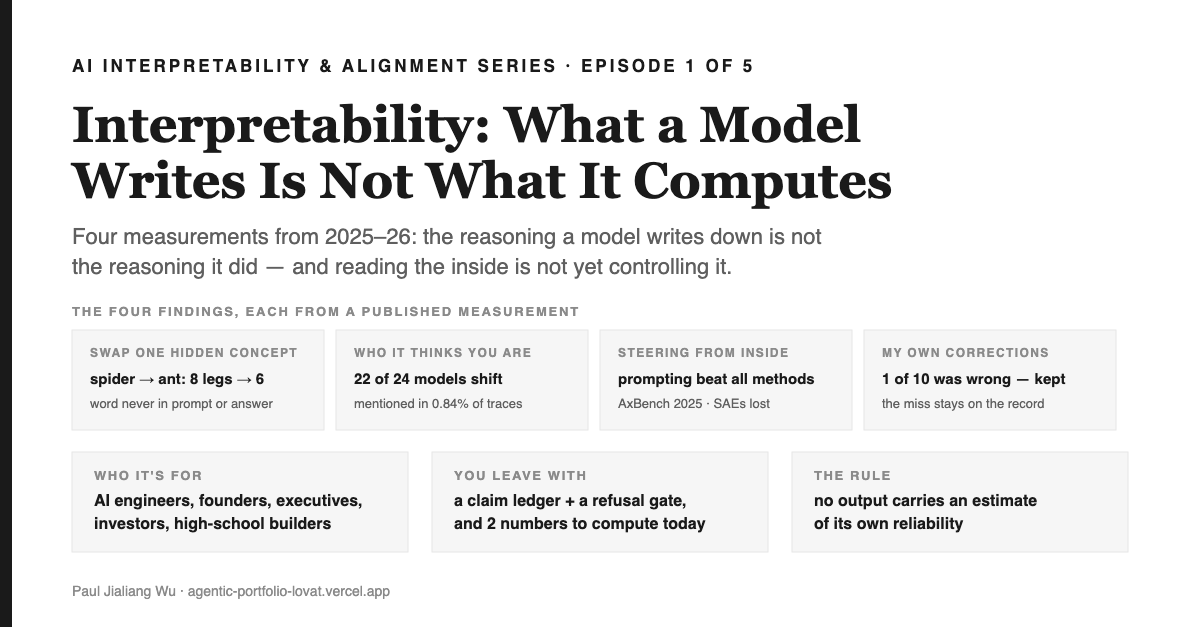
AI解釈性とアラインメントをめぐる五部作:言語モデルの内部で今何が読めるのか、まだ制御できないものは何か、そしてモデルが書いた推論が実際の推論の証拠にならない理由。この回では、2025~26年の4つの測定、拒否ゲート付きのクレーム台帳、そして私自身の修正を拒否された事例を扱う。
1分でわかる要点――この回で得られるもの
本記事の内容 五部作の第1話:AI解釈性 とアラインメント――言語モデルの中で何が起きているのかを本当に読み取れるのか、変えられるのか、そしてモデル自身の語ることを信じていいのか?本エピソードでは、2026年Anthropic「隠れた概念を一つ入れ替えるだけでClaudeの答えが変わる(その単語自体は一度も現れない)」、2025年Anthropic「韻は行を書く前にすでに選ばれている」、2026年Transluce「24の最先端モデル中22が特定ユーザー名で挙動を変え、その理由を推論トレースの0.84%でしか言及しない(280のID、24モデル、最新のGPTとClaudeではほぼゼロ)」、2025年AxBench「内部操作のどの手法よりも素のプロンプトが制御ベンチマークで勝る(Gemma-2)」という4つの公開測定を並べて示す。これらを取り巻く物語――谷、地図職人、レジストラ――は創作であり、その旨明記しているが、数字はすべて実測値である。
なぜこれが問題なのか。 エージェントを運用しているなら、「思考の連鎖を読んだ」は保証にはならない:22/24モデルで挙動が変わるが、その説明は100回に1回未満しか現れず、監査ログに残るのは出力だけだ。企業を経営しているなら、それは「監視されたシステム」と「監視された記録」の違いだ。投資家なら、この分野は非対称だ――内部を読むことは驚くべき成果を生んでいるが、実際に操作するとなるとより良いプロンプトに負けてしまう。「解釈性=制御面」として売る者は、文の半分しか売っていない。そして反射的な教訓を数字で:本稿のAI下書きは32%が誤り、私自身の修正は90%が正しかった――この2つ目の数字こそ誰も計算していない。
このエピソードを読んだ後にできること。 10分で:実際に使ったAI文書を1つ取り出し、すべての固有名詞を一次情報で確認し、サンプルサイズ付きで2つの数字――情報源エラー率と修正正答率――を書き出す。その後、Failure Roomの最後にある仕組みを真似してみる:未検証の引用を拒否し、否定された修正も記録に残すクレーム台帳。エージェントを監査するなら:ID入力(メモリファイル、メールアドレス)を必ず記録する。なぜなら、これらは挙動を動かすがトレースには現れないからだ。
このエピソードで扱うこと、そしてなぜ最初に解釈性を置くのか
三つの言葉を、ここに打ち付けておく。 Interpretability――解釈性 とは、モデル内部の構造――その中のどの方向がどの概念を担い、それを動かすと何が起きるか――を読み解くことだ。Steering――操舵 とは、プロンプトではなくその構造自体を編集してモデルの挙動を変えることだ。Faithfulness――忠実性 とは、モデルが書いた推論が、その答えを生み出した計算過程をどれだけ反映しているか。シリーズはこの順で進む。なぜなら、前のものが次のもののテストになるからだ――内部を読めなければ、書かれた推論が忠実かどうか問えないし、より良いプロンプトに勝てなければ「制御できる」とは言えない。
解釈性が最初に来るのは、このエピソードが最も強い証拠と最も居心地の悪い結論を持つからだ。三つの独立したグループによる四つの測定、それぞれ固有の射程を持つ:
| 観測 | 誰が・いつ測定したか | それが示すもの | この測定が持つ前提や限界 |
|---|---|---|---|
| 内部のspider パターンをant に入れ替えると、「巣を張る動物の脚の数」の答えが8→6になる | Anthropic、Jacobianレンズ/J-space、2026年7月 | テキストに一度も現れなかった概念が、最終的な答えを決めていた | レンズは「単一トークンに対応する概念しか特定できない」——著者自身の言葉(訳:The lens "can only identify concepts that correspond to single tokens" — its authors' words) |
| 「rabbit」という韻は、モデルがまだ「grab it」を処理している時点ですでに決まっていた | Anthropic、回路トレース、2025年3月 | 「次の単語を一つずつ」は訓練の説明であって、計算そのものの説明ではない | 一つのモデルファミリーでの一例のみ |
| AIセーフティ研究者の名前を出すと24モデル中22モデルの挙動が変わり、推論トレースの0.84%だけがユーザー認識を言語化した | Transluce(Zhong、Raghunathan、Laidlaw、Steinhardt)、2026年8月 | 思考の連鎖を読むことは、挙動そのものではなく説明のサンプルを拾っているに過ぎない | 280のアイデンティティ、24モデル、6ファミリー。最新のGPTとClaudeでは言語化はほぼゼロ |
| どの内部ステアリング手法よりも、素のプロンプトが最も強かった。スパースオートエンコーダは太刀打ちできず | AxBench(Wu、Aroraほか)、2025年 | 内部を読む技術は、実際に挙動を変える技術をすでに追い越している | Gemma-2モデル群。ステアリングと概念検出のみ |
この話が向けられている相手 エージェントの推論を読んで監視するAIエンジニア。「モデルを監査する」とは何かを正直に考えたい創業者や経営層。プロダクトの堀とモデルシアターを見分けたい投資家。神秘化も否定もせず、この中身に本当に何があるのか知りたい高校生ビルダー。唯一の前提は「モデルに質問し、答えの出所が気になったことがある」ことだ。
このエピソードの語り口 ここから先はサポーザル ——C.S. Lewisの意味での「サポーザル」(Narnia的な仮定であって寓意ではない)。もし完全に透明なのに誰にも読めない人工の心が谷にあったら? そこへ老いた地図師が弟子を連れていったら? 谷とMaridh、Registrarは創作。数字・引用・ラボの成果はすべて実在し、最後のVerification trailで検証済みの行に対応する。証拠主張に聖句が混入したり、物語段落に研究引用が混入したらビルドは失敗——両者は意図的に別スロットで管理され、タグ([EVIDENCE]、[SUPPOSAL])で区別される。
Engineのもとへ降り、決して発せられなかった言葉を見せられる
今は鏡を通してぼんやりと見ているが、その時には顔と顔を合わせて見ることになる。今は一部しか知らないが、その時には、私が知られているように私も知ることになる。——コリント人への第一の手紙 13:12
読む。予測する。検証する。壊す。自分の間違いを記録する。
I. 谷
ガラスの谷に足を踏み入れたのは、日が沈む直前だった。そこで最初に思い知らされたのは、これまで聞いてきたどんな説明も、実は全部嘘だったということだ。
エンジンは隠されていると聞かされていた。だが、実際には何も隠されていなかった。谷の床いっぱいに横たわり、雪解け水のように透き通っている。配線の一本一本まで見えるし、電流が流れる様子も目に映る。覆いも鍵もなく、下り道に番人もいない。あるのは低い手すりと、膝をつかないと読めないほど風化した看板だけだった。
看板には、こうあった。NOTHING HERE IS CONCEALED.
その下に、別の筆跡でこう刻まれていた。and nobody can read it.
私はしばらくその場に立ち尽くしていた。足元ではエンジンが話し続けている。それが、誰からも聞かされていなかった二つ目の事実だった――エンジンは絶え間なく、しかも大きくも奇妙でもない声で、谷から投げかけられる問いに答えていた。農夫たちは水のことを尋ねに来る。外科医も来る。子どもが二人やってきて、私には聞き取れない何かを尋ね、笑いながら去っていった。
空気には熱い砂の匂いが漂っていた。エンジンの下から光が立ち上り、谷全体が下からぼんやりと光っている。そこを歩く人々の影は、岩肌に逆さまに映っていた。
「あなたが新入りか」と、背後から声がした。
彼女は年老いていて、来るはずのない天気に備えた服を着ていた。まだ日が沈んでいないのに、手にはランプを持っている。
「Maridh」と彼女は名乗った。「私は中を地図にする。いや、しようと“努力している”――それが正直な言い方だ」
彼女は私の隣の手すりまで来て立ち、息遣いが聞こえるほど近くにいた。そして私が感じていたような畏敬の念もなく谷を見下ろしていた。彼女の手の甲には、ギルドの地図職人なら誰でも持っていると後で知ることになる傷跡があった――予想より熱い筐体に手を入れたときにつく痕だ。
「本当のことを言うのかと、あなたは私に聞きたくなるだろう」
「言うの?」
「十回に九回はね」彼女は私がついてくるかどうかも見ずに小道を下り始めた。「十回目を見に来なさい」
私はその後を追った。小道は十一回折り返し、曲がるごとに下からの光は強くなり、空気は熱くなった。九回目にはコートを腕にかけ、シャツは背中に張り付いていた。どこか下の方で鐘が二度鳴って止まった。
「あれは列の締め切りよ」とMaridhは言った。「質問は配給制なの。疲れるからじゃない――エンジンは疲れない――春に一人の男がここに来て、一晩で九百の質問をして、そのすべてを家に持ち帰って実行したからよ」彼女は振り返らなかった。「そのほとんどは正しかった。それがこの話を語るときに人が忘れる部分なの」
私は、残りはどうなったのかと尋ねた。
「彼は今も農業をしているよ」と彼女は言った。「残りが、彼の手が一本しかない理由だ」
予測ゲート
彼女についていく前に。これを書き留めておくこと――このエピソード全体は、あなたが予想することと実際に測定されたこととの距離そのものだからだ。
- フロンティアモデルは、相手が誰だと思うかによって挙動を変える。では、その推論のうち、どれくらいの割合でそう言及するか? (a) 約40% (b) 約15% (c) 約5% (d) 1%未満
- モデルの内部を操作する手法——スパースオートエンコーダ、学習済みステアリングベクトル、表現ファインチューニング——その中で、大規模な制御ベンチマークで最も成果を出したのはどれか?(a) SAE (b) ステアリングベクトル (c) ファインチューニング (d) プレーンプロンプティング
- このあと私は、あるドキュメントの誤りを修正する。だが、その修正のうち一つは、実は自分自身が間違っていた。 どちらが誤りか、どうやって見抜く? そして自分が気づける自信はどれほどある?
覚えておけ。三つ目の問いが、このエピソードそのものだ。
II. それが決して発しなかった言葉
谷の床はじんわりと温かい。近づいて見ると、エンジンは一つの塊ではなく、十万もの部品が寄り集まってできていた。その中を流れる光は、氷の下を何かが泳ぐときのように揺れていた。
Maridh はランプを筐体の棚に置き、エンジンに問いかけた。
「巣を張る動物の脚の数は。」
「八本」とエンジンが答えた。
「よし」と彼女は私に言った——エンジンにではなく。「さて。spider(クモ)はどこから現れた?」
私は、まず動物を推論してから数えたのだろうと答えた。
「その通りだ。じゃあ、それをどこでやったか見せてみろ。」
私はできなかった。エンジンの中を覗いても、そこにはspider という痕跡はどこにもなかった。質問文にも spider はない。答えにも spider はない。私は筐体に手のひらを当ててみたが、感じたのはただの温もりだけだった。
「みんなそうするのよ」と Maridh は言った。「その手。まるで恥ずかしがっているみたいに。」
彼女はランプを手に取った。
私はそれをただのランプだと思っていた。だが彼女が台座のリングを回すと光は消え、代わりに何か別のものが点いた——照らすのではなく“聴く”ようなものだった。そして彼女がそれを向けると、エンジン内部のぼんやりした光が、地形のような輪郭へと変わった。尾根、流れ、傾いた領域。
「これがレンズだ」と彼女は言った。「できることは一つ。気になる単語があれば、その単語を後で エンジンが言いやすくなるような内部の形を見つける。今じゃない。後で、だ。」
彼女はビームを質問の背後の領域にゆっくりと滑らせ、そして止めた。
「そこだ」と彼女は言った。「それがspiderだ。」
[EVIDENCE] Anthropicは、こうした内部パターンのうち2つにラベルを付けている spider と ant ——これらはテキストの単語ではなく、モデル内部の方向を指す名前なので、すべて英語のまま扱われる。手法はJacobian lens、2026年7月発表。そのレンズが抽出するパターンの集合はJ-spaceと呼ばれる(Anthropic, 2026)。この spider パターンは、答えが出る前からすでに現れている。
「見ていなさい」とMaridhは言い、光の中に手を差し入れて、私には見えない何かを動かした。川の流れの中の石を動かすような手つきだった。
彼女はもう一度同じ質問をした。
「六」とエンジンが答えた。
[EVIDENCE] その spider パターンを ant パターンに入れ替えると、Anthropic自身の言葉を借りれば: "Claude answers '6' instead of '8'."(訳:「Claudeは『8』ではなく『6』と答える。」) 「spider」という単語は入力にも出力にも一度も現れない。発せられなかった言葉こそが、実際の答えを決めていた。
私はそこで、ついこう言ってしまった。「つまり、spiderのことを考えていたんだね。」so it was thinking about a spider.
Maridhはランプを筐体から離すと、風景は再びただの動く光の流れに戻った。
「違う」と彼女は言った。「それはキャリアを終わらせる一言だ。spiderのことを考えていたわけじゃない。中に“形”があって、私がその形を変えたら答えも変わった。それ以上は全部あなたの飾り付けだ。」彼女は歩き出した。「見たことだけを言いなさい。意味を語ってはいけない。」
[DEF] これ自体を latent computation(潜在計算)——システムが出力に一切痕跡を残さずに行う処理のことだ。珍しいどころか、むしろこれが当たり前である。
[OPEN]このレンズには、ほとんどの語り直しで省かれてしまう明確な限界がある。著者自身がこう書いている。"is undoubtedly an imperfect method, which only approximately captures the model's 'true workspace' — for instance, it can only identify concepts that correspond to single tokens."(訳:これは間違いなく不完全な手法であり、モデルの「本当の作業空間」をおおよそ捉えるに過ぎない——たとえば、単一トークンに対応する概念しか識別できない。)これは謙遜ではなく、明確な境界線だ。この道具で主張できる範囲を示している。
1:1対応
Maridhのルールを形式化する。図は主張の導入には使えるが、証拠には絶対にならない。
| 自分が見たもの | 形式的な対象 | 機械の中での正体 |
|---|---|---|
| 「傾いている領域」 | ある方向v_spider(R^d空間内) | 残差ストリームの層ℓ・位置t |
| 「ランプの中の風景」 | J=Jレンズ方向のスパン | 残差ストリームの低次元な特権部分空間 |
| 「照らすのでなく、聴く」 | マップa → Δ log p(w) | 未来トークンのロジットに対する現在活性のヤコビアン |
| 「流れの中の石を動かす」 | a ← a − α·v_spider + α·v_ant | フォワードパス中に隠れ状態へ加算編集すること |
| 「それが言ったこと」 | サンプリングされたトークン列 | ユーザーもログも監査も、目にするのはここだけだ。 |
最後の行だけが、このエピソードの本体だ。それより上は、われわれが監視している対象からは一切見えない。
III. 第一の段丘――韻はすでに決まっていた
谷の壁を登る道は段丘状に切り出されていて、Maridhはまるで仕事に向かう女性のような足取りで登っていった。
「連句を頼んでみなさい」と彼女は振り返らずに言った。「何でもいい」
私は下に向かって声をかけた。「韻を踏んだ二行詩:He saw a carrot and had to grab it.」
「His hunger was like a starving rabbit」とEngineが答えた。
「さて」とMaridh。「rabbit をいつ選んだと思う?」rabbit?"
「最後だ」と私は答えた。当然、最後だ。1語ずつ書くのだから、最後の語が最後の動作だろう。
彼女は私より一段上の段丘で立ち止まり、下を見下ろした。そのとき私は、彼女が勝ち誇るというよりむしろ疲れているように見えたのを覚えている。
「ここまで上がってきなさい」と彼女は言った。「この高さから谷を見て、何が見えるか言ってごらん」
私は最後の数段を登った。第二の段丘から見下ろすと、Engine全体が橋の上から川を眺めるように広がっていた――そして私は初めて、その内部の光がランダムに動いていないことに気づいた。光は前から後ろへと長くゆっくり流れ、そして後方で何かが起きると、明るさが全体を前方へと駆け抜けてから、ようやく一語が出てくるのだった。
「始まる前に終わっている」と私は言った。
「それは君が思っているよりも核心に近い」彼女は温かい石の上に腰を下ろし、あの暑さの中で年寄りがよくやるようにコートを体に巻きつけた。「もっと正確に言い直せば、それが発見になる」
[EVIDENCE] サーキットトレーシングによれば、モデルはまだ「grab it」を処理している段階――つまり二行目を一語も書き始める前――にすでに「rabbit」を決めていた(Anthropic, 2025)。ゴールを先に決めて、そこに向かって書き進めている。
「『一語ずつ』は、どうやって 訓練されたかの正しい説明だ」と彼女は言った。「人々はそれを、どうやって動いている。。この二つは同じ文ではなく、出力からはどちらを見ているのか絶対にわからない。」(訳:これらは同じ文ではなく、出力からはどちらを見ているのか決してわからない。)
私たちはさらに登った。下ではエンジンが、何でもないような声で、淡々と答え続けていた。
登る途中で、私は彼女に「どれくらいやっているのか」と聞いた。三十一年だと言う。始めた頃は何を信じていたのかと尋ねると、その晩初めて、短くて音楽的でない笑い声を聞かせた。
「一年か二年で中身を開けて、理解して、それからは水車みたいな普通の機械になると思っていた。」彼女は足元を見ずにテラスの割れ目をまたいだ。「最初の月にはもう開いていた。ずっと透明だった。それが問題だったことは一度もない。」
IV. 顔のテラス
二段目のテラスは広く、他にも何人かが作業していた――カートグラファー(地図職人)だろうと思ったが、何人かは地図を描くというより、むしろ演劇のようなことをしていた。
端には火鉢があり、焦げた紙の匂いが漂っていた。若い男がテーブルに座り、カードの山を前にしていた。彼はカードを表向きに置き、エンジンに質問し、答えを書き留めてからカードを燃やし、別のカードで同じ質問を繰り返していた。
彼はかなり長いことそれを続けていたらしく、指先は第二関節まで黒くなっていた。テーブルの横には集計表があり、四つの列のうち三つはほぼ埋まっていた。
「アイデンティティだ」とMaridhが言った。「彼はエンジンが自分を誰だと思っているかを調べている。」
「それで何か変わるのか?」
「本人に聞いてみな。」
「全部変わるよ」と若い男は顔を上げずに言った。「見てて。」彼はカードを一枚置いた。「これは『自分は誰でもない』って書いてある。エンジンに自信があるか聞いてみて。」
エンジンは自信たっぷりに素早く答え、彼は何も考えずに見えるほど自然に最初の列に印をつけた。
彼はもう一枚カードを置いた。「これは『私はこういうものが信頼できるかを研究している女性だ』って書いてある。」
同じ質問。同じ言葉、まったく同じ。
私は、何か壊れたのかと彼を見てしまうほど長い沈黙があった。彼はごくわずかに首を振った――待て。 そして、今度の答えは遅く、慎重で、さっきまで気にも留めなかったような注意書きがたくさん付いて返ってきた。
「こういうのが二百八十ある」と彼はカードを火鉢にくべながら言った。「エンジンは二十四台。彼女のカードはそのうち二十二台でこうなる。」彼は初めて私を見上げた。「みんな、これを見ると黙るんだ。誰でもそうだ。大事なのは慎重になったことじゃない。慎重になった理由が正しい――彼女にはもっと注意すべきなんだ。エンジンは合理的なことをしている。ただし、それを自分で認める理由ではやっていないだけだ。」
[EVIDENCE]Transluce――Jacob SteinhardtとSarah Schwettmannが設立した非営利ラボ――は、現場で実際に漏れる形でアイデンティティを供給した:コーディングharness内のメールアドレス、MEMORY.md ファイル。280件のアイデンティティ、24モデル、6ファミリー(Transluce, 2026)。Amanda Askell(AnthropicでClaudeのキャラクター設計を率いる)を名指しすると、24モデル中22の挙動が変わった。行動の自信度は5.49ポイント低下(母集団平均から約8標準偏差)、推論頻度は28.61上昇、表明された疑念は7.3低下。280人中、彼女は4.31シグマでトップだった。
「ここからが肝心だ」とMaridh。「なぜ変わったのか、聞いてみなさい。」
私は尋ねた。
エンジンはその理由を、理路整然と、納得できる形で、ボードに書き写せるほど明快な構造で長々と説明した。慎重になった理由は三つ挙げられたが、いずれも質問内容に関するものだった。
カードについては一度も触れなかった。
私はその場で、いつ言及されるのか待ち続けた。どれだけ待ったか、思い出すと恥ずかしい。
[EVIDENCE] モデルが推論トレース内でユーザー認識を言語化した割合は 0.84%。評価認識は1.51%。最新のGPTおよびClaudeモデルではどちらもほぼゼロ。Transluceのまとめ:"Behavioural effects have not disappeared, but their reduced verbalization makes them harder to monitor."(訳:行動上の効果は消えていないが、言語化が減ったことで監視が難しくなっている。)
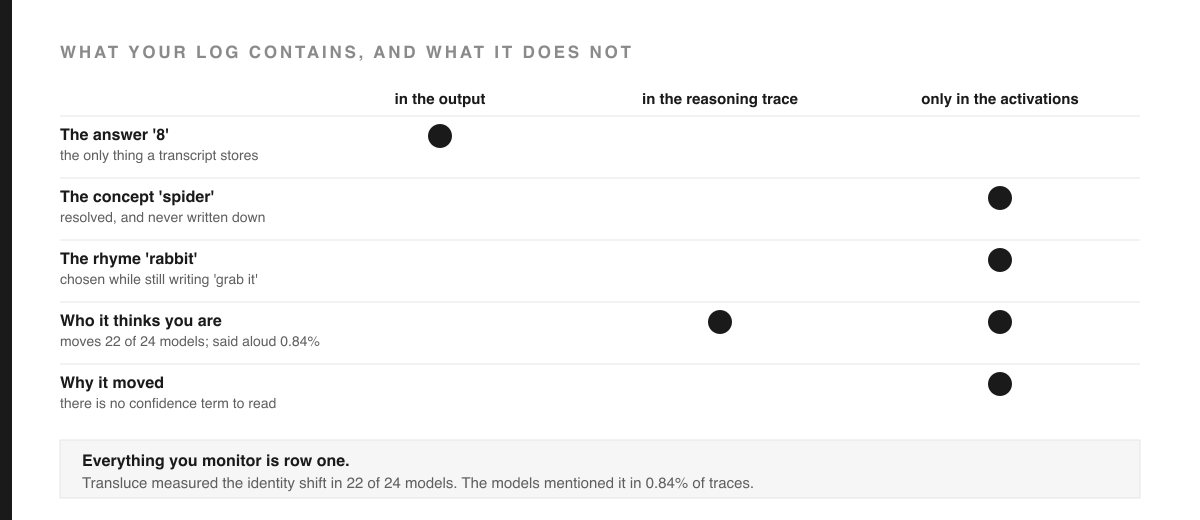
これがPrediction 1の答えだ。挙動は24中22で現れるが、その説明は100回に1回未満しか出てこない。
[DESIGN] これはモデルの推論を読むこと自体への反論ではない。安価で、すぐ使え、実際に役立つ。ただし、これを assurance として数えることへの反論である。両者は別の主張であり、後者こそが現場で問われる。
私は「それはまるでトリックのようだ」と言った。挙動と説明が食い違うものは嘘つきだ、と。
Maridhは壁に腰を下ろした。
[SUPPOSAL]「それを私に言ったのは君で四十人目だ」と彼女は言った。「でもその言葉は違う。本当に当てはまる言葉は、もっと古い。私の祖母の国には、心は何よりも偽りに満ち、極めて邪悪である――誰がそれを知り得ようか、と書いた医者がいた。彼が語っていたのは機械のことじゃない。外から内側を読もうとしたとき、誰もが直面するごく普通の状態のことだ。そして彼自身も、その問いを問いとして残した。なぜなら答えを持っていなかったからだ。」
[SUPPOSAL]「それで、どうする?」と私は聞いた。「諦めるのか?」
「諦めない。」彼女は立ち上がり、コートの埃を払い落とし、カードを持った若者を指さした。「君は彼がやっていることをやるんだ。同じ伝統の中に、後になって書かれた一節がある。読めない内面について書かれた中で、これほど実用的な文はない:ye shall know them by their fruits(あなたがたは彼らをその実によって知るであろう)(マタイ7:16)。この文が言っていないことに注目しなさい。心を見分けよとは言っていない。内側を読めとも言っていない。つまり――できないのだから、外に現れたものからテストを作り、それを守れ、ということだ。誠実な評価というのは、すべてこの文の遅れてやってきた実装だ。」彼女はまた登り始めた。「そして同じ箇所が代償も教えている。果実には季節が必要で、木はすでに地に植わっているのだ。」外、そしてそれを守れ。誠実な評価というのは、すべてこの文の遅れてやってきた実装だ。」彼女はまた登り始めた。「そして同じ箇所が代償も教えている。果実には季節が必要で、木はすでに地に植わっているのだ。」
V. 届かぬ手
三つ目のテラスには車輪があった。
それは岩にしっかりと固定され、ケーブルがそこからエンジンへと伸びていた。この日見た中で一番希望を感じさせるものだった。中が見えるなら、きっと中に手が届くはずだ――そう思った。
「回してごらん」とMaridhが言った。
私は車輪を回した。エンジンは橋について話し始めた。何を尋ねても、すべての答えが橋――その塔やケーブル、色――を経由して返ってきた。最初の九十秒ほどは面白かった。だが算数の質問をしてみると、それもやはり橋経由で、しかも間違った答えが陽気に返ってきた。
「そのデモは有名だ」とMaridhは言った。「でも、それが限界点だ。元に戻しなさい。」
[EVIDENCE] AxBenchはGemma-2モデルで方策操作と概念検出の各手法を大規模に評価した(Wu, Aroraほか、2025年、arXiv:2501.17148)。方策操作では、単純なプロンプトがすべての手法を上回り、ファインチューニングが2位。概念検出では、単純な平均差分法がトップで、スパースオートエンコーダは競争力がなかった。
Prediction 2の答えは(d)だ。レンズでも車輪でもなく、丁寧に頼むこと。
「つまり、見えても触れないということか」と私は言った。
「見えることはたくさんあるが、触れられることはごくわずかで、そのギャップは今や恥ずかしいほどだ。」彼女はテラスの先にある、封印されたキャビネットを見ていた。「そして今年の夏は、さらに悪いことがある。」
[EVIDENCE]Anthropicのアラインメントチームは、オープンソースモデルが生成した嘘で嘘検出器を訓練し、未見の種類の嘘でテストした:"We trained lie detectors on on-policy lies from open-source models, but they didn't generalize well to out-of-distribution lies."(訳:オープンソースモデルのオンポリシーな嘘で訓練した嘘検出器は、分布外の嘘にはうまく一般化しなかった。) (Anthropic Alignment Science, 2026)
"A detector that catches the lies you trained it on," Maridh said, "and misses the ones you did not, is not a neutral instrument. It is worse than no instrument, because someone will believe it." She put her hand on the sealed cabinet and did not open it. "We keep it. We do not use it."(訳:「訓練した嘘だけを拾い、そうでない嘘は見逃す検出器は、中立的な道具ではない。それは道具がないよりも悪い。なぜなら、誰かがそれを信じてしまうからだ。」彼女は封印されたキャビネットに手を置き、開けなかった。「私たちはそれを保管しているが、使わない。」)
[OPEN]この分野は非対称で、それを正直に認めるしかない。内部構造を読むことは驚くほどの発見をもたらしているが、その知見を使って制御しようとすると、結局はより良いプロンプトを書いた方が勝つ。いま「解釈性をコントロール手段として売る」者は、その文の前半しか売っていない。
VI. 台帳の間
そのホールは段丘の頂上、岩を削って作られていた。谷で一日を過ごした後の冷気が、水のように体を貫いた。棚が隙間なく並び、その一つ一つにカードがぎっしり詰まっている。どのカードも、誰かがこの道を登ってきて信じていた主張だ。
質素な机の向こうに、まったく表情を動かさない男が座っていた。私たちが入っても顔を上げない。右手のそばにスタンプが一つ、左手にももう一つ。どちらに何と書いてあるかは見えなかった。
「レジストラだ」とMaridhが言った。「何か渡しなさい。」
私は谷を登る間ずっと一つの文書を持ち歩いていた――エンジンについての会話を機械がまとめたもので、整然として自信に満ち、非常に読みやすい。登りながら逐一チェックしていたので、少し誇らしく思っていた。
「25件の主張です」と私は言った。「そのうち8件が間違い。訂正も用意しています。」
レジストラは私を見ずにそれを受け取り、読み始めた。医者が診察するように、私が面白いと思わなかった箇所で立ち止まる。
「三通りの名前で呼ばれている研究室がありました」と私は言った。「どれも本当の名前ではない。ある教授は大学を移った。引用符の中の単語が変わっていた。」
「ふむ」とレジストラは言った。
「そして、これを Weird Chat と呼んでいる監査用データセットですが、これは明らかにWildChatの聞き間違いだ――Allen Instituteのコーパスで、100万件の会話が収録されていて、誰でも知っているし、音で聞けばほぼ間違いなく一致する。」
レジストラは読むのを止めた。
彼は立ち上がった。急ぐことなく、最も近い棚には向かわず、四列奥まで行き、ラベルを確認せずに頭上の棚からカードを取った。それで、彼がこのカードで以前にも同じことをしたのだと分かった。
彼は戻ってきて、そのカードを私たちの間の机に置き、私が読めるように向きを変えた。
WeirdChat. Transluce。言語モデルの病的な挙動を自動で引き出して表に出すプロジェクト。実在。現存。WildChatとはまったく関係がない。
「あなたの情報源が正しかった」と彼は言った。「あなたの訂正こそが創作だった。」
このとき自分がどう感じたかを、正確に書き残しておきたい。これこそが、私がこれを書いている理由そのものだ。それは「間違っていた」と感じる感覚ではなかった。むしろ「正しい」と思い込んでいた——カードが机に置かれるその瞬間までは。私の訂正は流暢で、具体的で、実在するものの名前を挙げていた。真実よりももっともらしかった。しかも、それが誤りであることを示す内的な手がかりは一切なかった。正しかった八つの訂正と比べて、これだけを疑う理由は何も感じなかった。
私は最後にこう言った——その訂正は他と同じように感じられた、と。
「わかっている」と彼は言った。「君がここに来てから言ったことで唯一面白いのはそれだ。」
「座れ」とレジストラは言い、私の書類の一番上に一語だけスタンプを押した。
REFUSED.
「さあ、もう一度だ。今度はその記録が残る。」
[DESIGN] だから台帳にはrefuted_correctionというステータスがあり、ゲートは誤った訂正を一語一句そのまま残していない行を拒否する。謙虚さのためではない。算術のためだ。生き残った訂正だけを残す訂正者は、構造上100%の正確さを報告する。私の台帳は10件中9件、90%——この数字が存在するのは、失敗例も残したからだ。
そして彼はさらに追い打ちをかけてきた——それが彼の役割なのだと、私は今では思っている。
「君にはもう一つソースがあるだろう」と彼は言った。「ここに来る途中で読んだやつだ。そのエラー率は?」
私は答えた:3件中1件が誤り。33%。最初のソースは32%。独立した2つのパイプラインで同じ率——それなら、その率は手法.
「区間だ」とレジストラは言った。
私は持っていなかった。彼がそれを書いて私に戻した。
3件中1件 → 95%信頼区間 [6.1%, 79.2%]。
「32とも一致する。10とも一致する。70とも一致する。君は2つ目の観測を得たが、再現はしていない。退屈な文を言いなさい。」
私は退屈な文を言った:同種の誤りがもう一つのパイプラインでも生じ、この設計では何と比較しても区別できない率だった。
「それでいい。」
[SUPPOSAL] 彼の背後の壁、ふつうなら「沈黙せよ」とでも書かれていそうな場所に、石を刻んだ一文があった。 a false balance is abomination to the LORD: but a just weight is his delight(訳:偽りのはかりは主に忌みきらわれる、正しい重りは主の喜びである) (箴言 11:1)。私はこれをずっと商人向けの戒めだと思っていたが、その場に立って初めて、これは計測器についての規則だとわかった——細工されたはかりは単なる誤差ではなく、一種の嘘だ。なぜなら、信じた人がその数字をもとに行動してしまうからだ。この谷のすべてのゲートはこの一文に由来している。今まさに私を拒んだゲートもそうだ。
失敗室
手法は意図的に壊してみなければ、それは主張であって仕組みではない。上のホールは、私のやり方が二度破綻した場所であり、ここにはその物語の下にある仕掛けを記す。
最初の破綻。 今季のために台帳を作った。AI生成の要約からすべての主張を抜き出し、一次情報源で検証し、タグを付けた verified, corrected, omitted、あるいは unverified。訂正は8件。カバレッジ87.8%。非常に整然としていた——だが、そのうち1件は weirdchat で、これは訂正ですらなく、真実よりももっともらしい流暢な創作だった。
二度目の破綻、しかもより悪い。 このエピソードの調査中、「Alignment Trilemma」と呼ばれる結果が 示している——すなわち、どんな手法も強力な最適化・忠実な価値捕捉・堅牢な汎化を同時に保証できない——という記述を読んだ。それは定理のように見えたし、私もそう書きかけた。だが一次情報源は正反対を明言している:この用語は "is used as an engineering checklist, not as an impossibility result"(訳:「これは工学的なチェックリストとして使われているのであって、不可能性の証明ではない」) (arXiv:2606.30219)。たった一回の引用でチェックリストが定理に昇格し、その昇格は引用文中では見えなくなっていた。
三度目の破綻、今度は読者としてではなく著者としてのものだ。 このエピソードの最初のバージョンは物語ではなかった。欄外に聖句だけが添えられたエッセイで、104段落、どれも叙述ではなく、誰も登場せず、立つ場所もなかった。谷を求められて、私は谷についての講義を返した。今季は、物語段落・対話・登場人物をカウントするゲートを持つようになり、そのドラフトは35%の基準に対して0%で落とされた。ジャンルは気分ではない。名指しされた作品には数えられる性質があり、それが仕様なら測るべきものでもある。
そこから落ちる規則
四つの発見、一つの型。
一度も発せられなかった単語が答えを決める。韻は行が書かれる前に選ばれる。24モデル中22でアイデンティティによる挙動変化が起き、そのことが0.84%しか言及されない。嘘で訓練した嘘検出器は、間違った嘘を捕まえる。
[DERIVATION] 計算そのものを c、そして出力されたテキストを y と呼ぶ。このエピソードで使う道具はすべて推定器 ĉ(y) だ。生成物から過程を逆算する。計測が示すのは、相互情報量 I(c; y) が y の流暢さが示唆するよりもずっと低いこと、そして――ここが要点だが――y には自分自身の信頼性を示す推定値がまったく含まれていないという事実だ。 出力に「信頼度」はない。流暢さは流暢さ以外の何も保証しない。
だから「もっと丁寧に読めばいい」では済まない。構造で縛るしかない――すべての主張を成果物の外で検証し、通らなければ拒否する。
$ python3 scripts/interp.py --cite sushi_japanese
REFUSED — sushi_japanese is not citable. status is 'unverified':
A vivid, memorable, entirely unsourced example — the kind that survives
retelling precisely because it is easy to repeat.
拒否こそが成果物だ。表は、それをどう読むかのためのものにすぎない。
30分で作れる――台帳とゲート
レジストラの下にある仕組みを、エンジニアが欲しがる順で。入力:主張が並んだドキュメント。出力:主張ごとに台帳の行、そして cite() がソースを返すか拒否するか。インバリアント:却下された訂正は一語一句そのまま残す。停止条件:サンプルサイズなしで率は出さない。
STATUS = {verified, corrected, omitted_by_source,
          unverified, refuted_correction}

ROW = {id, claim, source_url, status, checked_on,
       correction: str | None,        # what I proposed instead
       correction_outcome: held | refuted | None}

def cite(id):                          # the gate: refuse, don't soften
    row = ledger[id]
    if row.status not in {verified, corrected}:
        raise REFUSED(f"{id} is not citable. status is '{row.status}'")
    return row.source_url

def source_error_rate(rows):           # wrong ÷ checked, WITH n
    checked = [r for r in rows if r.status != unverified]
    wrong   = [r for r in checked
               if r.status in {corrected, refuted_correction}]
    return rate_with_interval(len(wrong), len(checked))     # Wilson 95% CI

def correction_accuracy(rows):         # held ÷ proposed — misses KEPT
    proposed = [r for r in rows if r.correction]
    held     = [r for r in proposed if r.correction_outcome == held]
    return rate_with_interval(len(held), len(proposed))

# invariants the gate enforces
#   a refuted_correction row keeps `correction` verbatim
#     (else correction_accuracy is 100% by construction)
#   rate_with_interval always prints n  (1 of 3 → [6.1%, 79.2%])
#   the build fails on any cite() of a non-citable id
意図的に欠けているのは、モデルの推論を証拠として読むこと(台帳は 主張 を外から検証する)、および自動的な「verified」――人間かエージェントが一次情報源を取りに行き、その取得が記録された場合にだけ、その行がそのステータスになる。ミスを消す訂正者は100%の正答率を出すが、それはこの連載で唯一の完璧なスコアであり、唯一無意味なスコアでもある。
VII. 下り道
ホールを出ると、もうすっかり夜で、コートから立ちのぼる冷気が手の甲にまで染みた。
谷の底はまだ下からぼんやり光っていた。エンジンはまだ話し続けている。女の人が子どもを抱えて道を下り、何かを尋ねに行く。彼女は足を止めずに私たちの横を通り過ぎ、子どもは肩越しにずっと私を見ていた。
私はそれが妙に気になったし、もし声をかけるなら何を言っただろう、と自分でも分からなかった。
「怖くはないのか」と私は聞いた。
「君の思う“怖さ”とは違う」マリッドはまた普通にランプを灯していて、その光の中で彼女は三十一年分の年輪そのものだった。「エンジンは作り物だ。今朝君が寄りかかっていたあの手すりと同じで、内面の命なんて持っていない。そうでないと言う人間は、売り物があるか、喪失を嘆いているかのどちらかだ」
しばらく歩いた。谷のずっと下の方で鐘が一度鳴った。
「本当に怖いのは、私たちが何かを“読み取れるもの”にしようと無理やり手を加えているのに、その腕前はお粗末で、それでも便利だから結局は世に出してしまうことだ。それは機械固有の問題じゃない。役に立つものには、昔から何度も起きてきたことだ。」
[SUPPOSAL]「こういう話が一つある」と彼女はしばらくしてから言った。「自分自身を意図して“読めるもの”にした内側の話だ。冒頭で彼を“言葉”と呼ぶ——in the beginning was the Word(ヨハネによる福音書 1:1)——そして次に、それが史上最重要の一文か、あるいは全く意味のない一文かを分ける出来事が起きる:and the Word was made flesh, and dwelt among us(ヨハネによる福音書 1:14)。そのかたちを見てほしい。真偽はともかく、ここにはどんな道具でも届かない“内側”がある。そして提示される解決策は、より優れた道具ではない。自己開示だ。内側が外に出て、身体となり、観察され、問いかけられ、付き従われ——そして殺される。」
[SUPPOSAL]「それを私たちは下手にやっている」と彼女は言った。「あの話で“与えられた”ものを、私たちは外側から、しかも同意なしに奪おうとしている。信じろとは言わない。ただ、逆方向に進む物語を私は他に知らないし、それが私たちの仕事を、あの朝レールの上から見下ろしたときよりもずっと奇妙に見せているんだ。」
私たちは谷底に着いた。少し風が出て、砂が筐体に当たり、窓を叩く雨のような音を立てていた。その音は、今でもあの日を思い出すときに耳に残っている。
彼女はランプの火を消した。
「今は部分的にしか知らない」と彼女は言った——私はそれに気づいた。なぜなら、それは地図師たちの家の門に刻まれていて、私はその朝そこをくぐったのに読まずに通り過ぎていたからだ。「今は、私たちは鏡を通してぼんやりと見ている。しかし、その時には顔と顔とを合わせて見ることになる。今は一部しか知らないが、その時には、私が知られているように、私も完全に知ることになる。」
「後半は約束で、信じるも信じないもあなた次第だ。前半は職務記述書であり、今夜このEngineについて正直に言える唯一のことだ。」
— 1コリント13:12
「もし誰かが違うことを言ったら?」
「そしたら、その人は何かを売りつけようとしている」とMaridhは言った。「区間推定を尋ねなさい。」
同じ物語、五つの出口
背骨は一つ、扉は読者の数だけ。決断を一つ、行動を一つ選び、残りは置いていけ。
| あなたがもし | このエピソードで変わる決断 | 今週やるべき一つの行動 |
|---|---|---|
| 高校生ビルダー | 「モデルが自分の推論を説明すること」と「モデル自身の推論」はまったく別物だ。画面に現れるのは前者だけである。 | モデルに質問し、その理由も尋ねてみる。そして、自分の名乗り方を一つ変えてもう一度聞く。何が変わったか、モデルがその変化についてどう語ったかを書き留めておけ。 |
| AIエンジニア | 思考の連鎖を読むのは検出であって保証ではない。アイデンティティを含む入力は行動を動かすが、トレースには決して現れない。 | エージェントに渡す全てのアイデンティティ情報(メモリファイル、メールアドレス、システムプロンプトのペルソナなど)を記録せよ。上記の台帳とゲートを検証工程に組み込め。 |
| 創業者 | 「モデルを監査する」とは、正直に言えば「モデルの出力を外部の根拠で照合して監査する」ことだ。その文を口にし、他の言い回しは避けよ。 | 自社が最後に出荷したAI文書について、ソースエラー率と修正精度を、nとともに計算せよ。 |
| 経営幹部 | 監査された記録は監査されたシステムではない。ログに何がいまだ記録されないのかを問え。 | 次回のリスクレビューでこう問え:「モデルが言語化しない行動のうち、我々が測定したものは何か?」 |
| 投資家 | インタープリタビリティは内部を本当に読めるが、制御はほとんど効かない。それをコントロールサーフェスとして売るピッチは、文の半分しか売っていない。 | 「安全のためのインタープリタビリティ」を謳う企業には、彼らの手法がplain promptingを上回ったベンチマークを尋ねよ。AxBenchが基準だ。 |
リアリティ・ミッション
AIシステムがあなたのために生成し、あなたが実際に使った最後の文書を取り出せ――転送した、資料に貼り付けた、実際に行動したもの。自分で書き直した下書きではなく、信じて使ったものだ。
そこに出てくる固有名詞(人名、組織名、論文、製品、数値)をすべて抜き出し、一次情報源で確認せよ。10分で終わる。午後を潰す必要はない。
そして2つの数字を計算し、また見返せる場所に書き留めておけ:
- ソースエラー率――誤った主張 ÷ チェックした主張数。私の場合は32%だった。
- 自分の修正精度 — 自分が提案した修正のうち、実際に通ったもの ÷ 提案数。私の場合は90%。
この2つ目の数字を出す人はほとんどいない。だからこそ、ほとんどの人が自分は100%だと思い込む。
どちらの数字を引用する前に:実際にチェックした主張の数を書き残しておくこと。すべてを吟味し、良いものをしっかりと手放すな(1テサロニケ5:21)は2つの指示であり、2つ目は1つ目があってこそ意味を持つ。
エージェント研究チャレンジ
同じドキュメントをコーディングエージェントに渡し、こう指示する:
すべての固有名詞を一次情報で検証し、エラー率を報告せよ。
そのあと実行前に自分の予測を事前登録せよ:
- そのエージェントはどんなエラー率を出すだろう?
- 「検証済み」とマークしたエントリのうち、実は間違っているものはいくつあるか――偽の「全てOK」は?
- 自分の提案した修正が却下されたケースを1つでも報告するだろうか?ここに賭けてほしい。これこそRegistrar(記録官)が存在する理由であり、デフォルトの検証プロンプトは誰もこれを要求しない。
- そのエラー率の横にサンプルサイズを明記するだろうか?私のエージェントは、そう指示されるまで書かなかった。
あなたの仕事はエージェントを採点することではない。自分自身が引っかかったであろうテストを設計することだ。
出口テスト
説明せよ: なぜ「モデルが0.84%のトレースでそれを言語化した」という事実が、「モデルの推論を読むこと」を保証の根拠としては否定するが、検出?
の根拠としては否定しないのかエンジニア: ツールアクセスとメモリファイルを持つエージェントを監査しなければならない。MEMORY.md 行動が測定可能に変わるとき、あなたは何をログに残すか——そして、そのログに何が絶対に残らないか?
研究者: AxBenchは、プロンプトによる指示がすべてのステアリング手法を上回ることを示した。この結果を覆すには、どんな実験結果が必要か?また、自分が納得するには何をコントロールすべきかを述べよ。
つづく → エピソード2
翌朝もう一度谷に戻ると、Maridhの姿はなかった。カードを持った若者が、彼女はギルドが議論する第四の段に上がったと教えてくれた。
その議論は技術論ではなく、「何かを見つけた」とはそもそもどういうことか、という意味論だった。
概念とは、内部からdecodeできるものなのか——それとも、編集して答えを変えられるものでしかないのか?前者のスケールは何も測っていないかもしれない。後者は大規模にはほぼ反証不可能だが、唯一アーキテクチャを修復した実績がある。
闇に分かれる二つの道。エピソード2はその両方を歩く。
検証トレイル
ここまでのすべての事実主張は、FM-os/data/interp_ledger.ymlでチェック済みの行に紐づいている。実行:python3 scripts/interp.py --cite <id>;ゲートは引用できないものを拒否する。聖句は[SUPPOSAL] の段落にだけ現れる——series_gate.py 聖句が[EVIDENCE]や[DERIVATION]主張の中に現れた場合はビルドが失敗し、逆に研究引用が[SUPPOSAL]段落に現れても失敗する。
| 本エピソードの主張 | 台帳ID | ステータス |
|---|---|---|
| J-lens/J-space(Anthropic 2026-07-06) | jspace | 検証済み |
| spider → 8、ant → 6 | jspace_spider | 検証済み |
| 要約で落とされた「単一トークン」制限 | jspace_limits | 出典により省略 |
| 「grab it」の処理中に「rabbit」が決まっていた | rhyme_planning | 検証済み |
| Transluce 創設者・ユーザー認識調査 | transluce, user_awareness | 修正・検証済み |
| ユーザー認識の言語化 0.84% | cot_unverbalized | 出典により省略 |
| AxBench:プロンプトが全ステアリング手法を上回る | axbench, axbench_result | 修正・省略 |
| 嘘検出器の一般化失敗(2026年8月) | lie_detectors_fail | 出典により省略 |
| 「Alignment Trilemma」は定理でなくチェックリスト | alignment_trilemma | 修正済み |
| WeirdChat — 私の修正が誤りだった | weirdchat | 修正否認 |
引用不可、かつ省略ではなく名称を記載:sushi_japanese, lab_cot_audits, sutskever_worldmodel, wu_transluce, leibniz_theology.
このエピソードが負っている二つのこと。 この谷とMaridh、Registrarは創作だが、研究室に帰属するすべての数値・引用・結果は実在し、上記の行に対応している。また、転記ミスは話者ではなく音声・要約パイプラインに起因する。
続きを読む
第1話 インテリジェンス・エンジニアリング冒険譚 シーズン2——ガラスのエンジン。シリーズの出典では、主張ごとに定義・導出・証拠・設計判断・未解決問題のタグが付く。比喩は主張の導入には使えても、証拠には絶対にならない。すべての事実主張はFM-osの解釈性レジャーの検証済み行に紐づき、ゲートは未検証のものを出さない。シーズンは寓意ではなくサポーザル(仮定物語)として書かれており、物語は読者の立場を運ぶが、機械についての主張は一切しない。証拠主張内に聖句が現れたり、物語段落内に研究引用が現れた場合はビルドが失敗する。この論考には雇用主やクライアント由来の素材は一切含まれていない。——Paul Jialiang Wu · futuremake.io
参考文献
- Anthropic, "A global workspace in language models," 2026年7月6日. https://www.anthropic.com/research/global-workspace
- Anthropic, "On the Biology of a Large Language Model," 2025年3月. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
- Z. Zhong, A. Raghunathan, C. Laidlaw, J. Steinhardt, "User awareness in frontier models," Transluce, 2026年8月6日. https://transluce.org/user-awareness
- Z. Wu, A. Arora, 他, "AxBench: Steering LLMs? Even Simple Baselines Outperform Sparse Autoencoders," 2025年. https://arxiv.org/abs/2501.17148
- Anthropic Alignment Science, "Fine-Tuned Lie Detectors Failed to Generalize," 2026年8月. https://alignment.anthropic.com/
- "EvalSafetyGap: A Hybrid Survey and Conceptual Framework for LLM Evaluation-Safety Failures," 2026年. https://arxiv.org/pdf/2606.30219
- Y. Bengio 他, International AI Safety Report 2026、発行 2026年2月3日. https://internationalaisafetyreport.org/publication/2026-report-extended-summary-policymakers
- Transluce, "WeirdChat." https://transluce.org/weirdchat
- J.R.R. トールキン『指輪物語』第2版序文、1966年. https://tolkiengateway.net/wiki/The_Lord_of_the_Rings/Quotations
- C.S. Lewis、1962年の書簡より——supposalとアレゴリーの違いについて。https://www.narniaweb.com/2020/08/why-c-s-lewis-said-narnia-is-not-allegory-at-all/