AI-Nativeシリーズ · ANDON · エージェント型PRレビューとCI/CD · 第5話(全5話)
ネガティブテスト──ゲートは一度赤になって初めて設置される
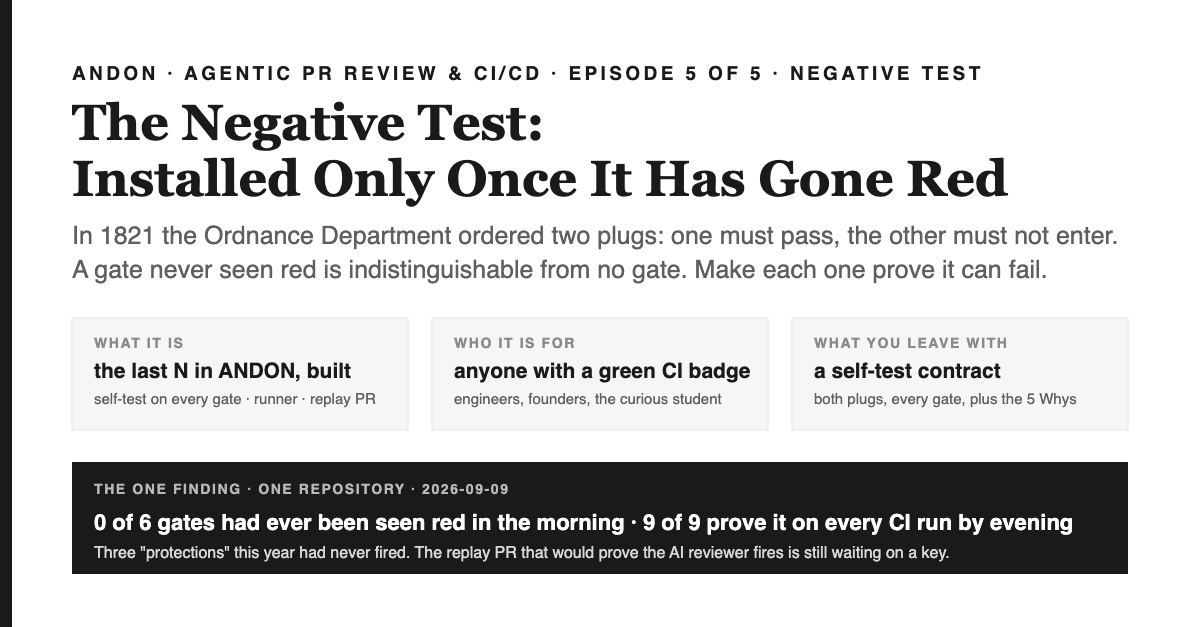
エージェント型PRレビューとCI/CD、第5話、いよいよ最終回。1821年、米国兵器局は全てのマスケット銃身に2本のプラグを命じた。1本は通り、もう1本は入ってはならない。なぜなら「合格」しか示さないゲージは、何も教えてくれないからだ。多くの継続的インテグレーションパイプラインは、合格しか出したことのないゲージだらけだ。この回はANDONの2つ目のN、つまりネガティブテストを扱う。6つのゲートが朝には一度も赤になったことがなく、夕方にはすべてのゲートが両方のプラグ付き自己テストを持ち、どちらかがなければランナーが拒否するようになったリポジトリの一日を描く。発動したことのない保護が3つ、鍵待ちで止まったままのリプレイPR、そしてシーズンのスコアボードも含まれる。
1分でつかむ要点──読後に残るもの
これは何か。 第5話 ANDON――エージェント型PRレビューとCI/CDをめぐる全5話シリーズ、その最終回である。今回のテーマは「ネガティブテスト」。これは実際のリポジトリにセルフテスト契約として組み込まれている。すべてのゲートには「必ず通るべきフィクスチャ」と「必ず落ちるべきフィクスチャ」が内蔵され、CI上のランナーが全ゲートを走査して、どちらか一方でも欠けていれば即座に赤になる。さらに、過去の既知バグを再現するリプレイPRを開いたままにし、AIレビューアが緑を出す前に必ず赤を出させる。
なぜそれが重要なのか。 エンジニアにとって――一度も発火したことのないゲートは、発火できないゲートと見分けがつかない。このリポジトリの三つの保護は、実際に後者だった。創業者にとって――Googleの調査によれば、パスからフェイルへの遷移の84%はフレークだった。これは「誰も信じない赤は、誰も読まないゲートになる」という、同じゲージのもう一つの失敗だ。学生にとって――1821年のプラグは、たった2本の鋼にすべてが詰まっている。
読んだ後にできること。 すべてのゲートに「両方のプラグ」を備えたセルフテストをつけよう。ペアがないゲートを拒否するランナーを追加し、そのランナー自体をゲートに組み込む。過去の実際のバグを再現するリプレイPRを一つ開いたままにし、レビューアがそれを検知するまで閉じない。そして、シーズンの始まりと同じく、まだ示せない数字には「未計測」と明記して締めくくる。
ANDON — シリーズの背骨
- A · Assess ― PR洪水は「感じる」ものではなく「測る」もの 第1話
- N · Never silent ― リポジトリの自働化 第2話
- D・Data, not prose(散文ではなくデータ) — ドリフトしないルール 第3話
- O・エンベロープの内側だけ――被害範囲はパスリストで決まる 第4話
- N · Negative test ― ゲートは意図的に赤になって初めて設置される この回
この回で扱うこと、そしてなぜネガティブテストが最後なのか
これまでの4話で「判断する機械」を組み上げてきた――意見を持たないゲート、「実行不能」という第3の状態、データとして生きるルール、そしてボットがマージできる範囲を定めるエンベロープ。それぞれは「悪いケースが来たとき、このコードがどう振る舞うか」という仮説だ。今回扱うのは、その仮説が本当か唯一確かめる方法――つまり、意図的に悪いケースを通してゲートが赤になるのを自分の目で見ることだ。これが最後に来るのは、これまでのすべてを試すテストであり、しかもリポジトリが最も長く気づかずに破っていた唯一のルールだからである。
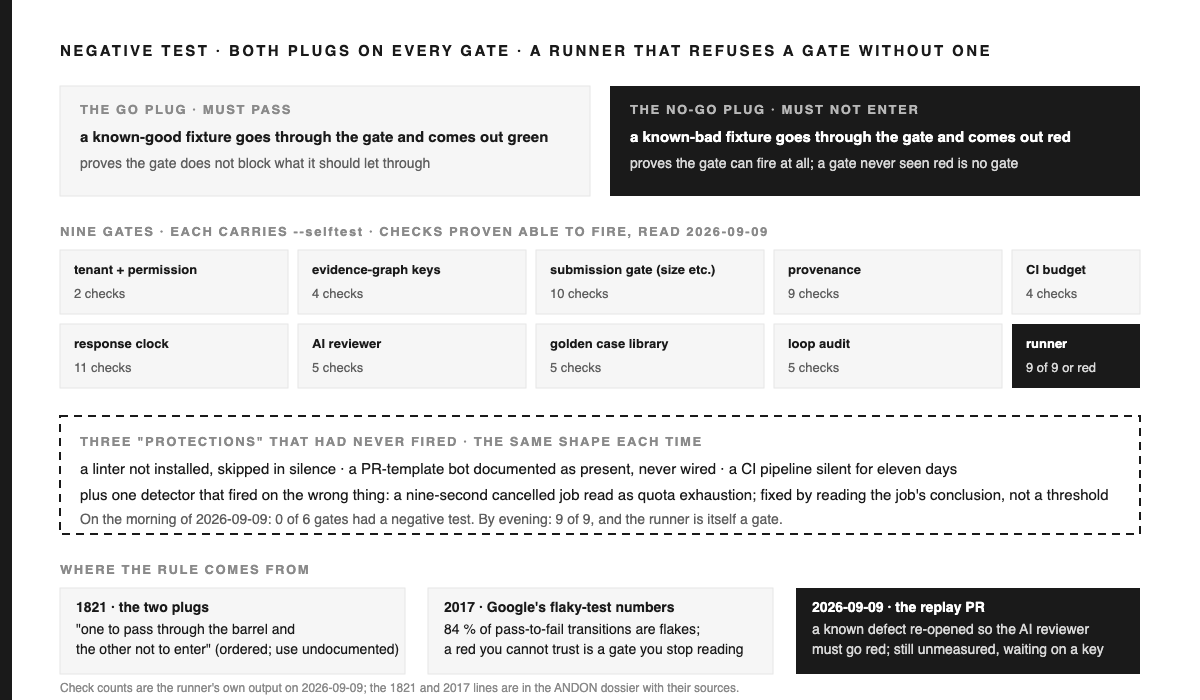
朝の数字がすべてを語る。2026年9月9日、まだ第1話の洪水ゲートが一つもなかった時点で、このリポジトリのCIには6つのゲートスクリプトがあったが、ネガティブテスト付きはゼロ。どれも一度も発火したことがなかった。直前数週間のレッスンファイルには、同じパターンのインシデントが3件記録されている――インストールされていないリントが黙ってスキップされた、ドキュメント上は存在することになっていたPRテンプレートボットが一度も配線されていなかった、11日間沈黙したCIパイプライン。いずれも「保護」と呼ばれていたものが、一度も保護として働いたことがなく、誰も気づけなかった。なぜなら、その「緑」は正常なゲートの緑と区別がつかなかったからだ。
だから、この回のルールはこうだ――ゲートは、意図的に一度でも赤になったときにだけ設置される。そして、そのゲートが本当に赤になれることを証明する仕組みが、ゲート自身に組み込まれていなければならない。.
このルールの原型はこうだ――一方のプラグは必ず通り、もう一方は絶対に入らないこと。
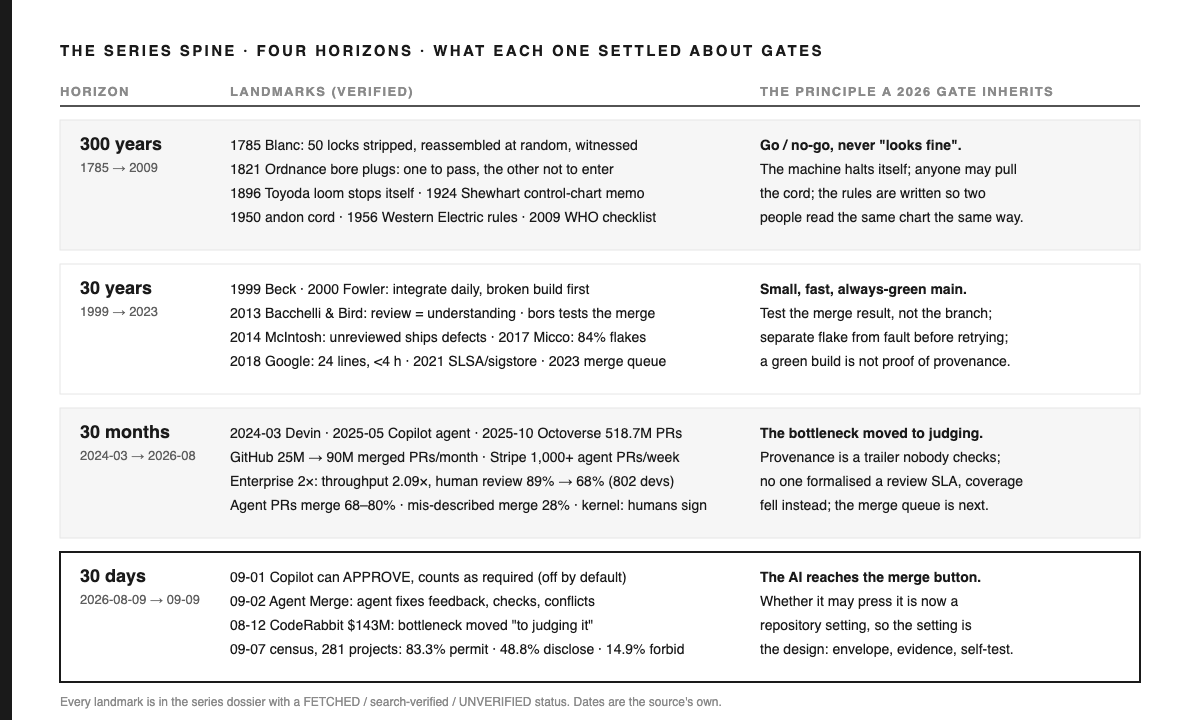
ゴー/ノーゴーゲージは、管理図やチェックリスト、アンドンコードよりも古い。スプリングフィールド造兵廠の記録によれば、1821年にBomfordが兵器局のマスケット銃検査のために出した指示には、"two plugs for the bore diameter, with one to pass through the barrel and the other not to enter"(訳:銃身の口径に合わせて2本のプラグを用意し、一方は銃身を通過し、もう一方は入らないこと) [1とある。なぜ2本必要か?ゴープラグが通れば銃身が小さすぎないと分かり、ノーゴープラグが入らなければ大きすぎないと分かる。1本だけではテストとして半分しか機能しない。このエピソードが引き継ぐ注意書きも残っている――このプラグは発注されたのが1821年であり、実際に使われた記録はない。最初に文書化されたペアが、最初に現場で使われたペアと同じとは限らない。
どちらの系譜も、素材こそ違えど本質は同じことを語っている。1785年7月、ヴィンセンスでHonoré BlancがRoserの再現で"disassembled 50 locks, picked pieces for 25 locks at random, and … assembled them again"(訳:50個の錠前を分解し、25個分の部品を無作為に選んで再び組み立てた) [2――このデモ自体がテストであり、無作為に選ぶことで組み立てる人が通る部品を選べないようにしたのがポイントだった。そして1896年、スウェーデンのライフル工場で検査官だったCarl Edward Johanssonが、組み合わせゲージブロックセットを発明した[3――検査用具自体を基準物で検証できるようにし、ゲージにもゲージを持たせた。どれも「見た目で大丈夫そう」をやめ、必ず受け入れなければならない基準と、必ず拒否しなければならない基準を設け、検査官が都合の良いサンプルを選べないようにしている。
第1話のキッチンの例にも、最後のピースがある。すべての皿を量る秤が信頼されているのは、営業前に既知の重りを載せて正しい数字が出るか確かめ、さらに意図的に50グラム足りない皿を渡して、それを検査員が必ず戻すからだ。今まで一度も皿をはねたことのない検査員は、すべてを素通ししているだけかもしれない。セルフテストとは、営業開始ごとに行う既知の重りと足りない皿のチェックそのものだ。
| キッチン | リポジトリ |
|---|---|
| 営業前に秤に載せて正しく表示されるべき既知の重り | ゴープラグ:すべてのゲートが必ず通過しなければならない、組み込み済みの既知良品フィクスチャ |
| 意図的に50グラム足りない皿で、検査員が必ず戻さなければならないもの | ノーゴープラグ:すべてのゲートが必ず失敗しなければならない、組み込み済みの既知不良フィクスチャ |
| すべての秤がチェックされたことを記録する開店チェックリスト。これがなければキッチンは開かない | ランナー:すべてのゲートを列挙し、セルフテストを実行し、ペアがない・失敗したゲートがあれば赤で終了する。自身もゲートである |
| 先月戻された料理をもう一度作り直し、新しい料理人が気づくかどうかを試す | リプレイPR:既知の過去の欠陥を再オープンし、AIレビューアーが必ず赤になることを要求する |
30年分の教訓――信頼できない赤は、誰も読まなくなるゲートになる。
ソフトウェアの歴史にも、同じゲージのもう一つの落とし穴がある。発火したことのないゲートは一つの問題だが、何も問題がないのに発火するゲートも、結局はどちらも誰にも信用されなくなるという点で同じだ。Googleが2017年に自社のCIを計測した際の数値が基準になる:"84% of transitions from Pass ->"84% of transitions from Pass -> Fail are from 'flaky' tests"(訳:合格から不合格への遷移の84%は「flaky」テストによるもの)、さらに"Almost 16% of our 4.2M tests have some level of flakiness"(訳:4.2百万件のテストのうち、ほぼ16%が何らかのflakinessを持つ) [4。同じ著者が1年前に報告したのは"about 1.5% of all test runs reporting a 'flaky' result."(訳:全テスト実行の約1.5%が「flaky」な結果を報告している) [5。2014年の実証研究では、flakyの主因として"The top three categories of flaky tests are Async Wait, Concurrency, and Test Order Dependency."(訳:flakyテストの主な3カテゴリはAsync Wait、Concurrency、Test Order Dependencyである) さらに"Most flaky tests (78%) are flaky the first time they are written."(訳:flakyテストの大半(78%)は最初に書かれた時点ですでにflakyである) [6とされている。Googleの続報では"larger tests are more flaky"(訳:大きなテストほどflakyになりやすい) [7とも示されており、これは第4話で扱ったサイズゲートが別の側面から現れたものだ。
Googleほどの規模になると、"more than 50,000 unique changes and running more than four billion individual test cases"(訳:一日に5万件超のユニークな変更と、40億件超の個別テストケースを実行)という世界で[8]、flaky対策はインフラの領域になる。Chromiumのコミットキューはリトライのルールをこう明言している:"If the retry succeeds, then the failure is ignored."(訳:リトライが成功すれば、その失敗は無視される) [9。だが小さなリポジトリでも、1821年のプラグが示す答えは同じだ。すべてのゲートについて、既知の不良入力と既知の良好入力でどう振る舞うかを知っておけば、赤は赤、緑は緑になる。セルフテストこそが、リトライに頼らずゲートのシグナルを信じられる理由になる。
ここでもう一つ、歴史の余談を挟みたい。これはチェックリスト誕生の由来であり、よく語られる美談とは逆の話だ。1935年のモデル299墜落事故――プリフライトチェックリスト誕生のきっかけとされる――は、ガストロックが解除されていなかったことが原因だった。そして航空安全の記録には、誰がそれを解除し忘れたのか"is not clear."(訳:明らかではない) [10と記されている。チェックリストは「分からない」を埋めるための道具だった。それはセルフテストの役割でもある。
実装:すべてのゲートに両方のプラグ、ランナー、そしてリプレイ
1. セルフテスト契約
ゲートターゲットとCIにある全9つのゲートは、今やセルフテスト用のフラグを受け付けるようになった。このフラグを指定して実行すると、ゲートはリポジトリ本体には一切アクセスしない。テナントフィルタなしのクエリを持つルーター、エージェントマーカーだけでトレーストレーラーのないコミットメッセージ、理由のない免除を含む方策、キャンセルされたゼロステップジョブを含むワークフロージョブ群、IDが1つだけ変わったルールテーブル――こうしたフィクスチャをメモリ上に自前で組み立てる。そして、それぞれのフィクスチャに対して自身のチェックを走らせ、「悪い」フィクスチャでは必ず指摘が出て、「良い」フィクスチャでは何も出ないことを両方向でアサートする。実行したチェック数を出力し、どれかのアサーションが失敗すれば非ゼロで終了する。この契約はリポジトリのlessonsファイルに一文で書かれている――片方向だけのテストは、テストしていないのと同じである、と。
2026-09-09の夕方、ランナー自身の出力から読んだカウント:テナント&パーミッションゲートは2件、エビデンスグラフゲートは4件、サブミッションゲートは10件、プロヴナンスゲートは9件、CI予算検出器は4件、レスポンスクロックは11件、AIレビュワーは5件、ゴールデンケースライブラリは5件、ループ監査は5件。9つのゲートすべてが、今やCIのたびに自分自身で赤を出したことがある。
2. ランナー自体がゲート
ゲートがセルフテストを持っていても、それを誰も実行しなければ、結局はただの文章でしかない。だからランナーはゲートのリストをデータとして持ち、リストされた各ゲートのセルフテストを実行し、リストにない・フラグがない・アサーションに失敗したゲートがあれば赤で終了する。ランナーはローカルのゲートコマンドにもCIにも組み込まれており、これは「すべてのゲートは発火できることを証明しなければならない」というリポジトリ自身のレビュールールを機械で担保するものだ。ランナーは、そもそもリストに載っていないゲートには気付けない。このリストの完全性は、9つのゲート名を明示するループ監査の構造基準とレビュールールによって保証されている。ループ監査自体もセルフテスト付きで書かれ、同じPRでリストに追加された。
3. 間違ったものに発火した検出器
1821年ルールのもう半分が、2026-09-09の棚卸しで顔を出した。リポジトリには、Actionsの実行履歴を監視し、クォータ枯渇の指紋――この設計ではゼロステップのジョブ――を検出する検出器がある。直近60回の実行で走らせたところ、1件だけ発火した:2026-09-05のmainへのプッシュで、マイグレーションジョブがゼロステップだったのは、9秒後に次のプッシュがコンカレンシールールで上書きしたためだ。検出器の指紋はキャンセルと一致した。修正は閾値ではなく、ジョブ自体が持つ結論を読み、キャンセル・スキップ・ニュートラルなジョブを指紋から除外するようにした。セルフテストには、発火してはならないキャンセル済みゼロステップジョブが含まれる。誤検知する検出器は、時々入ってしまうノーゴープラグのようなもので、一度でもそれが入るのを見たクルーは、もうそれを信じなくなる。lessonsファイルには、以前のクォータ枯渇が実際に見逃されていたことが記録されている。
4. リプレイPR
AIレビュワーも他と同様にセルフテストを持つが、そのセルフテストはモデルを必要としない部分――エビデンスフィルタ、ティア分類器、ブリーフレンダラー――を検証する。モデル自身の判断は、実際のケースでしか試せない。そこで前回記事のビルドでは、リポジトリの履歴から既知で修正済みの欠陥――クローズゲートを通さずにクレームをクローズできてしまったバイパス――を再導入するプルリクエストを立て、「do not merge」と明記した。その欠陥に対するレビュワーのルールは存在し、このPRがそのノーゴープラグである。リプレイPRは2026-09-06からオープンしており、執筆時点で1件のブリーフが401で未計測のまま載っている。リポジトリの全11件のブリーフも同様で、毎回キーが拒否されているためだ。PRは意図的にオープンのまま、レスポンスクロックから理由付きで除外され、レビュワーが一度でも赤を出すまで閉じられない。どちらの結果になったかを報告すると約束した記事は、いまのところ「どちらでもない」と記している。
同じ日の夜、アップデート。 有効なキーが20:00 UTCごろリポジトリに届き、リプレイPRでレビュワーが再実行された。結果は赤:バイパス、削除されたホワイトリスト、欠落したクローズ監査、削除されたテスト――各ファイルと行を示す4件のブロックレベル指摘が出て、承認ではなく人間による対応を求めた。ノーゴープラグは入らなかった。ループ監査の「AIがPRを計測した」行は次回実行で緑に変わる。「Tier-1が一度マージした」はまだプラン待ちだ。
なぜゲートは赤を出してからでなければ設置されないのか――5つのなぜ
| # | なぜ? | 理由 | 証拠 |
|---|---|---|---|
| 1 | 一度も発火したことのないゲートのグリーンは、なぜ意味がないのか? | 発火できないゲートが出すグリーンは、何も見つけなかったゲートのグリーンとまったく同じで、出力からは区別できないからだ。 | 1つのリポジトリで3つの保護が一度も発火していなかった。どれも動作していると信じられていたが、実際に確認するまでそう思われていた。 |
| 2 | なぜ証明はゲートと一緒に出荷されなければならず、一度きりではダメなのか? | ゲートは変化する。インストール時に行った証明は、5回目の編集後のゲートについては何も語らないし、それを壊す編集は自ら名乗り出たりしない。 | ランナーは、リストされたすべてのセルフテストをCIのたびに実行する。ループ監査はセルフテストとリストへの追加を同じPRで出荷した。 |
| 3 | なぜ両方のプラグが必要で、ノーゴーだけではダメなのか? | 何にでも発火するゲートは、何にも発火しないゲートと同じくらい速く無視される。ゴープラグこそが、赤に意味を持たせる。 | Google: 84 percent of pass-to-fail transitions were flakes [(訳:Googleによると、合格から不合格への遷移の84%はフレークテストによるものであった)4]; 予算検出器がキャンセル済みジョブで誤検知した件(訳:]; the budget detector's cancelled-job false positive) |
| 4 | なぜランナー自身もゲートでなければならないのか? | 誰にも実行されないセルフテストは、ファイルに書かれた一文に過ぎない。エピソード3のルールは「ルールとはdiffできるもの」であり、エピソード2のルールは「マージ判定が見ていない場所で実行されるチェックは、実質的に存在しないのと同じ」だ。 | ランナーはローカルのゲートコマンドとCIの両方に組み込まれており、リストにあるゲートが欠けている・フラグがない・失敗した場合は赤で終了する。 |
| 5 | なぜリプレイPRを開いたまま、未計測の状態で残しておくのか? | モデルだけはフィクスチャ化できないゲートであり、正直な状態は「既知の不具合で赤になった」か「まだなっていない」しかない。PRを閉じてしまうと「まだなっていない」が単なる沈黙に変わってしまう。 | リプレイPRの1件のブリーフは401で未計測のまま。理由を書いてレスポンスクロックから除外されている。 |
本質は一文に尽きる。ゲートのグリーンは、そのゲートが直近の変更以降、既知のバッド入力で赤になったことが観測されて初めて証拠となる。その観測自体がゲートの一部でなければならない。
30分で作る:セルフテスト契約
30分というのは、この契約を読者が写して実装する場合の目安であり、私自身が計測した時間ではない。
| 要素 | 仕様 |
|---|---|
| セルフテストフラグ | すべてのゲートが受け入れる。--selftestフィクスチャはメモリ上で構築し、リポジトリには一切触れない。両方向でアサートする:known-bad ⇒ finding、known-good ⇒ no finding。 |
| 出力 | 1行:チェック数(すべて発火可能であることを証明)。アサーション失敗時は非ゼロで終了。 |
| ランナー | ゲートパスのリストをデータとして持つ。それぞれについてセルフテストを実行し、ファイル欠落・フラグ欠落・非ゼロ終了なら赤。ランナーはローカルのゲートターゲットとCIに存在する。 |
| 検出器のフィンガープリント | 形状をマッチさせる前にプラットフォーム自身の結論フィールドを読む。キャンセル・スキップ・ニュートラルは除外する。この教訓となった誤検知(false positive)は、セルフテストの「発火してはならない」フィクスチャとして組み込む。 |
| リプレイPR | 実際に修正済みの不具合を再導入するPRを1つ用意し、「do-not-merge」ラベルを付け、理由を書いてレスポンスクロックから除外し、レビュアーが赤を出した後にのみクローズする。 |
| 不変条件 | 既知の不良入力なら必ず検出し、既知の良入力なら必ず検出しない──すべてのゲートで、すべての実行でこれを守る。 |
| 停止ルール | リストに載っているゲートでペアが揃っていない、またはどちらかが失敗した場合、そのCIラン全体が赤となり、何もマージされない。 |
| レポート | ループ監査の構造基準は自己テスト付きゲートの数を数え、機能基準はランナーを実行する。どちらも毎回のCIで確認される。 |
| 意図的に省いたもの | ゲートのためのリトライ・オン・フレークはなし。共通フィクスチャライブラリもなし。インメモリ・フィクスチャ以外のプラットフォームのモックも使わない。どれも自己テストがゲート以外を検証する抜け道になるからだ。 |
# The contract is two assertions per rule, inside the gate itself.
def selftest():
    bad  = fixture_with(agent_marker=True, trace_trailer=False)   # must fire
    good = fixture_with(agent_marker=True, trace_trailer=True)    # must not
    assert check(bad),      "the gate never fires: not installed"
    assert not check(good), "the gate fires on a good input: will be ignored"
    print("selftest: 2 checks, all proven able to fire")

# The runner refuses a gate without one.
GATES = ["scripts/check_tenant_perm.py", "scripts/check_provenance.py", ...]   # data
for g in GATES:
    rc = run([python, g, "--selftest"])
    if rc != 0: fail(f"{g}: no self-test, or it failed")
同じ話、五つの出口
| 読者 | たった一つの判断 | たった一つの行動 |
|---|---|---|
| 学生 | 一度も失敗したのを見たことがないチェックは、そもそもチェックとは呼べない。 | 「いつも通る」ものを一つ選び、必ず失敗するケースを与えてみよう。何が起きるか観察せよ。 |
| エンジニア | 両方のプラグを、ゲートの中に、毎回仕込む。 | を--selftest今日、最も信頼しているゲートに追加せよ。既知の不良フィクスチャと既知の良フィクスチャを一つずつ。 |
| 創業メンバー | これまでに赤になったことがあるゲートの数を数えてみよ。 | その数を今週チームに尋ねてみよ。ゼロならREADMEのバッジはただの飾りだ。 |
| 経営陣 | 1821年のプラグが必ずペアで導入されたのには、ちゃんと理由がある。 | 自分が管理するコントロールのうち、ネガティブテストがきちんと記録されているものと、単に「動いているはず」と信じられているだけのものはどれかを問い直せ。 |
| 投資家 | リプレイPRを未計測のまま開き続けているチームは、現実を正直に報告している。 | そのチームのCI履歴で、意図的にゲートが赤になる瞬間を実際に見せてもらえ。 |
パターン、アンチパターン、そして根本原理
機能したパターン ゲートの中で、良いケース・悪いケース両方のフィクスチャをメモリ上で作る。ゲートリストがデータとして管理され、そのランナー自体もゲートである。形を照合する前に結論を読む。偽陽性をフィクスチャ化する。モデルが赤を出すまで開いたまま・免除されたリプレイPR。
これを置き換えたアンチパターン インストールされていないとき黙ってスキップするリンター。存在すると書かれているだけで一度も配線されていないボット。キャンセルと一致する指紋を持つディテクター。「動かないところを一度も見たことがない」だけで信じられていた6つのゲート。
仕組みの本質 セルフテストは「ゲートが動く」という過去の思い込みを、毎回の実測に変える。ランナーは「すべてのゲートにセルフテストがある」という慣習を、赤信号という現実に変える。
根本原理を一文で ゲートへの信頼は、最後に意図的に失敗させてみた時の新しさに比例する。
シーズンの全体像とスコアボード
ANDONは5つのルール、1つのリポジトリ、そして4つの地平線記録をもとに1日で構築した。その5つのルールを、各話の頭文字・主張・リポジトリ内の該当箇所とともにまとめる。シリーズ全体が記憶ではなくコードで検証できるように。
| 頭文字 | ルール | 主張 | リポジトリ内の実装 |
|---|---|---|---|
| A | 数値で評価する | 洪水は感じるものではなく測るもの。機械ゲートはシェフではなく秤である。 | ドシエのライブ計測値。スクリプトで判断できることだけを決める機械ゲート。 |
| N | 沈黙しない | 実行できなかったゲートは「未計測」と投稿し、レスポンスクロックはcronで動く。 | レビュアーの第三の状態、SLAボット、ループ監査のP基準 |
| D | データで語る、文章でごまかさない | ルールはdiffできて初めて本物となる。ドキュメントはそこから自動生成・検証される | 3つのJSONファイル、レンダラー、手動で赤にしたドリフトチェック |
| O | 封筒の内側だけ | ボットがマージできる範囲はパスリストで決まる。deny優先。5つの条件を同時に満たす | 自動マージ封筒、ティア分類器、由来ゲートとサイズゲート |
| N | ネガティブテスト | ゲートは、意図的に赤になったことがあって初めて設置される。その証明もゲートと一緒に持ち込む | すべてのゲートにセルフテスト、ランナー、リプレイPR |
| シーズンのスコアボード | 初日の朝(2026-09-09) | 最終日の夕方(2026-09-09) |
|---|---|---|
| 最初の応答がないまま最も古いオープンPR | 57時間、3件のPR | 同じ3件。ラベル付きでボードに載ったまま、未回答 |
| 赤になることを証明するセルフテスト付きゲート | 6つ中0つ | 9つ中9つ。ランナー(自身もゲート)が強制 |
| 9月1日以降、トレーストレーラー付きでエージェント支援されたコミット | 未計測 | 21件中11件。新規コミットには由来ゲートで必須 |
| ループ監査基準 未計測 | 監査自体が存在しなかった | 2 / 23:AIによるPRの測定なし、Tier-1も未マージ |
| AIブリーフ投稿数/無応答 | 3 / 0 | 11/0、すべてリジェクトされたキーで未測定 |
この3行は今季の正直な失敗だ。最初の行は、このシーズンが動かそうと名付けられたものだが、結局動かなかった。共同創業者3人のPRは、シーズンを通して人の応答が一度もなかった。機械はその日のうちにラベルを付けたが、メンテナーは最後まで沈黙した。これは設定の問題ではなく、人の行動そのものだ。残る2つも、リジェクトされたキーとリポジトリに届かなかったプランという、同じ失敗の表裏である。シリーズが作った仕組みは、それらがなくても分類・投稿・ラベル付け・監査・拒否を正しくこなす。ただし、PRを測定した・マージしたと主張することは、実際にそうなるまで絶対にない。それが最初のルールであり、最後のルールでもある。
現場のミッション
第4話で約束したのは、第5話までにすべてのゲートが自己テストで赤になることが証明され、リプレイPRがレビュアーの初めての測定済みファインディングを出すか、キー待ちのままか、そのどちらかを記事で明記することだった。前者は完了した:9つすべて、CIのたびに赤になることが証明された。後者は執筆時点で「未測定ブリーフがリプレイPR上に残る」という2つ目のケースだったが、夕方にキーが届き、レビュアーが赤を出した(上記参照)。このシーズンのミッションは、次のエピソードがないためスコアボードの3行に集約される。最初の行は人のミッションだ:共同創業者3人のPRに応答すれば、ボードからラベルが外れる。キーがローテーションされたら、リプレイPRの次のブリーフが測定される。レビュアーが既知の欠陥で赤を出すか、シリーズの中核主張が間違っていたことになる。そのどちらかをドシエが記録する。プランがリポジトリに届けば、1コマンドでブランチ保護が入り、次のドキュメントのみPRは自動でマージされるか、監査がなぜそうならなかったかを示す。
次に読む
第5話:ANDON・エージェント型PRレビューとCI/CD、最終話。すべての数字は現れた場所でスコープされる。キッチンはモデルであって、測定値ではない。自己テスト、ランナー、ディテクター、リプレイPRはプライベートリポジトリにあり、その形は契約に再現されているため、アクセスに依存しない。シーズンが参照する4つのホライズンのドシエは、ポートフォリオのplansディレクトリに記録されている。
参考文献
- Raber, Malone, Gordon, Cooper, Conservative Innovators and Military Small Arms: Springfield Armory 1794–1968、NPS 1989/2006, p. 138(Stubblefield and Lee to Bomford, 1821-12-04, NARA RG 156/21)。npshistory.com
- Roser, 230 Years of Interchangeable Parts、AllAboutLean, 2015-07-08。allaboutlean.com
- サイエンス・ミュージアム・グループ、ヨハンソンゲージブロック一式(1900年頃)、オブジェクト番号 co59398。collection.sciencemuseumgroup.org.uk
- Micco、The State of Continuous Integration Testing at Google(訳:Googleにおける継続的インテグレーションテストの現状)、ICST 2017 基調講演。aster.or.jp
- Micco、Flaky Tests at Google and How We Mitigate Them(訳:Googleにおけるフレークテストとその対策), 2016-05-27. testing.googleblog.com
- Luo, Hariri, Eloussi, Marinov、An Empirical Analysis of Flaky Tests(訳:フレークテストの実証分析)、FSE 2014。mir.cs.illinois.edu
- Listfield、Where do our flaky tests come from?(訳:私たちのフレークテストはどこから来るのか?), 2017-04-17. testing.googleblog.com
- Software Engineering at Google、第23章「継続的インテグレーション」、2020年。abseil.io
- Chromium、コミットキューのドキュメント。chromium.googlesource.com
- Flight Safety Australia, 一度に一つだけ:チェックリスト小史, 2018-11-12. flightsafetyaustralia.com