Serie AI-Native · ANDON · Revisión agéntica de PR y CI/CD · Episodio 5 de 5
La prueba negativa: una compuerta solo se instala después de haber marcado rojo
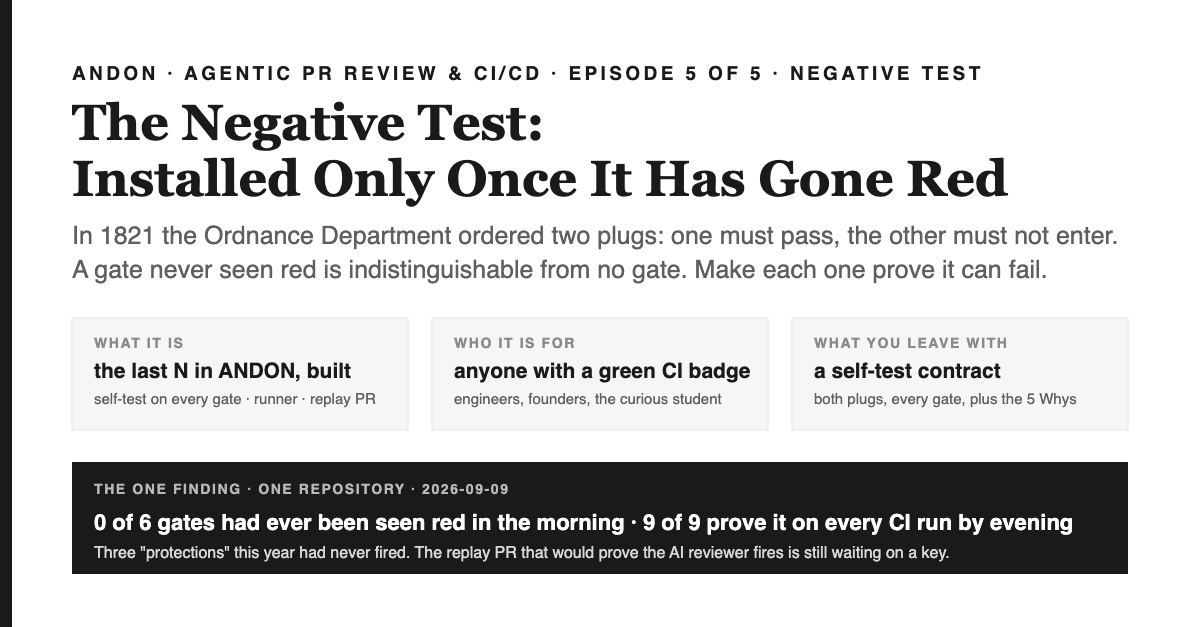
Revisión agéntica de PR y CI/CD, episodio 5, el último. En 1821 el Departamento de Artillería de Estados Unidos ordenó dos tapones de prueba para cada cañón de mosquete, uno que debe pasar y otro que no debe entrar, porque un indicador que solo dice "aprobado" no te dice nada. La mayoría de las pipelines de integración continua están llenas de indicadores que solo han dicho aprobado. Este episodio es la segunda N de ANDON, la prueba negativa. Cuenta la mañana de un repositorio, cuando ninguna de sus seis compuertas había marcado rojo, y su tarde, cuando cada compuerta llevaba un autotest con ambos tapones y un runner rechazaba cualquier compuerta sin ambos; las tres protecciones que nunca se activaron; el pull request de reejecución que sigue esperando una key; y la tabla de resultados de la temporada.
Resumen en 1 minuto — lo que te llevarás
Qué es esto. Episodio 5 de ANDON, una serie de cinco partes sobre revisión agéntica de PR y CI/CD, y su final. Esta es la regla prueba negativa, implementada en un repositorio real como un contrato de autotest: cada compuerta incluye un fixture integrado que debe pasar y otro que debe fallar; un runner en CI enumera todas las compuertas y marca error si alguna carece del par, y un pull request de repetición reabre un defecto conocido para que el revisor de IA tenga que marcar error antes de que se le permita aprobar.
Por qué importa. Para un ingeniero: una compuerta que nunca se ha activado es indistinguible de una que no puede activarse, y tres de las protecciones de este repositorio resultaron ser del segundo tipo. Para un fundador: Google midió que el 84 por ciento de sus transiciones de aprobado a fallido eran flakes, que es el otro fallo del mismo medidor: un rojo en el que nadie confía es una compuerta que nadie revisa. Para un estudiante: los tapones de prueba de 1821 son toda la idea resumida en dos piezas de acero.
Qué puedes hacer después de leer. Da a cada compuerta de la que dependes un autotest con ambos tapones de prueba. Añade un runner que rechace cualquier compuerta que no tenga ambos, y pon el runner dentro de la compuerta. Mantén abierto un pull request de repetición de un defecto real del pasado hasta que tu revisor lo haya detectado. Y termina la temporada como empezó: con los números que aún no pueden mostrarse marcados como no medidos.
ANDON — la espina de la serie
- A · Assess — La inundación de PRs se mide, no se siente episodio 1
- N · Nunca silenciosa — Jidoka para repositorios episodio 2
- D · Data, not prose — La regla que no puede desviarse episodio 3
- O · Solo en el perímetro — El radio de impacto es una lista de rutas episodio 4
- N · Prueba negativa — Una compuerta solo se instala después de haber marcado error a propósito este episodio
Qué cubre este episodio y por qué la prueba negativa viene al final
Cuatro episodios construyeron una máquina que decide: compuertas sin opiniones, un tercer estado para "no pudo ejecutarse", reglas que viven en los datos y un sobre que delimita dónde puede fusionar un bot. Cada uno de esos es una afirmación sobre lo que hará un fragmento de código cuando llegue el caso malo. Este episodio trata sobre la única forma de saber si esa afirmación es cierta: enviar el caso malo a propósito y ver la compuerta marcar error. Viene al final porque es la prueba de todo lo anterior, y porque es la única regla que el repositorio había roto durante más tiempo sin darse cuenta.
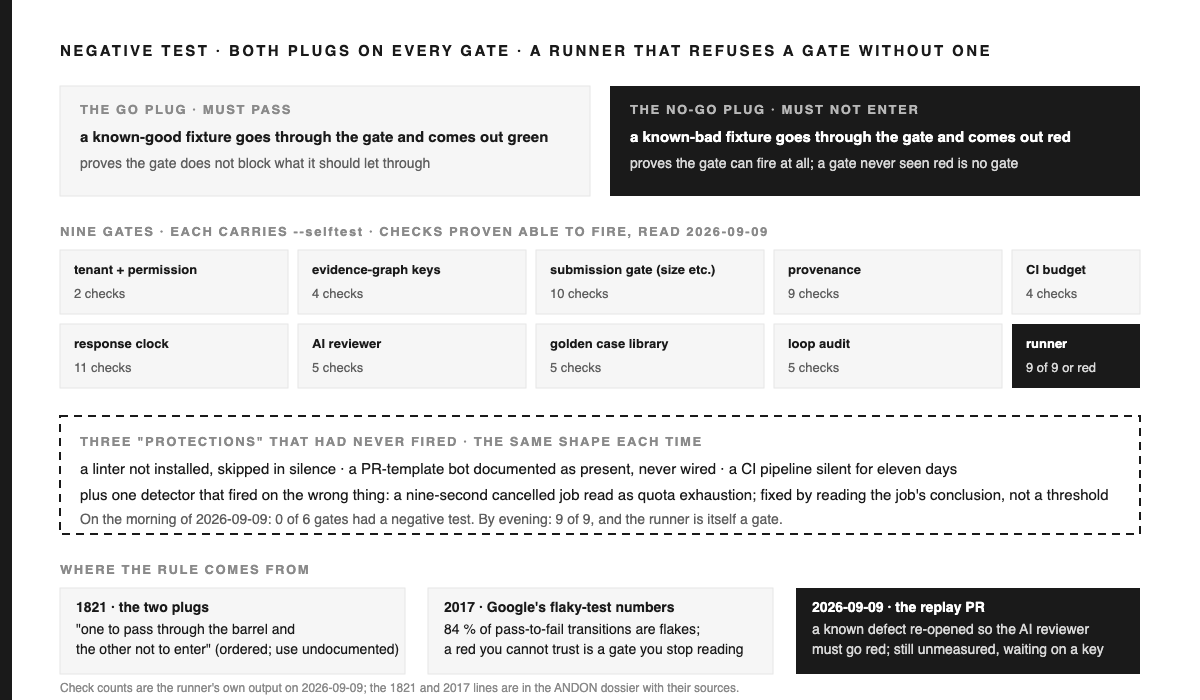
El conteo de la mañana es todo el argumento. El 2026-09-09, antes de que se construyeran las compuertas del diluvio del episodio 1, el repositorio tenía seis scripts de compuerta en su CI, y ninguno tenía una prueba negativa. Ninguno había demostrado jamás activarse. El archivo de lecciones registró tres incidentes en las semanas previas con el mismo patrón: un linter que no estaba instalado y se saltaba en silencio, un bot de plantilla de pull request que la documentación describía como presente pero nunca se había conectado, y una pipeline de CI que llevaba once días en silencio. En cada caso, algo descrito como protección nunca había hecho lo que hacen las protecciones, y nadie podía notarlo, porque el verde que producía era idéntico al verde de una compuerta funcional.
Así que la regla para este episodio: una compuerta solo se instala después de haber marcado error a propósito, y la prueba de que puede marcar error viaja junto con la compuerta.
La versión más antigua de la regla: un tapón debe pasar y otro no debe entrar
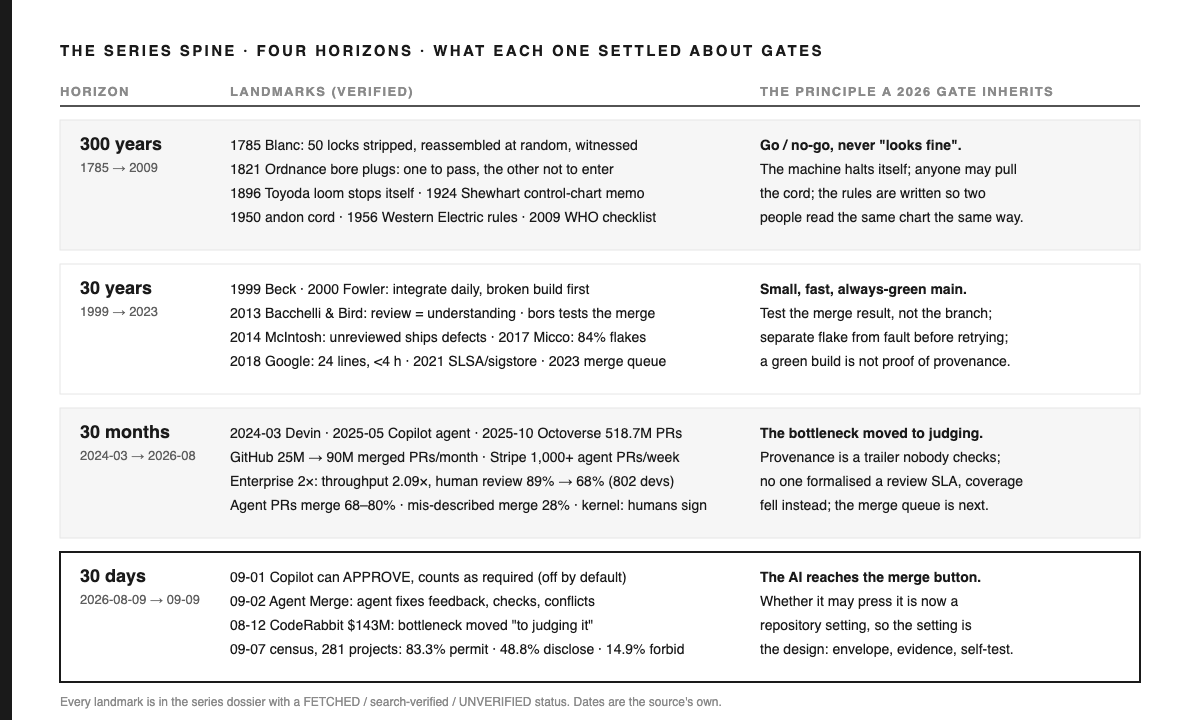
El calibre go/no-go es más antiguo que la carta de control, la lista de verificación y el cordón andon. Las instrucciones de Bomford en 1821 para la inspección de mosquetes del Departamento de Artillería, según lo registrado en la historia de Springfield Armory, exigían "two plugs for the bore diameter, with one to pass through the barrel and the other not to enter"(Traducción: "dos tapones para el diámetro del ánima, uno que debe pasar por el cañón y otro que no debe entrar") [1]. Dos tapones, no uno, porque un cañón que acepta el tapón go te dice que no es demasiado pequeño, y solo el tapón no-go te dice que no es demasiado grande. Un calibre con un solo tapón es medio test. El expediente lleva una advertencia con esta fecha que este episodio mantiene: los tapones fueron ordenados en 1821; el registro no muestra que se hayan usado, y el primer par documentado no es lo mismo que el primer par realmente utilizado.
La genealogía a ambos lados dice lo mismo en metales distintos. Honoré Blanc en Vincennes en julio de 1785, en la reconstrucción de Roser, "disassembled 50 locks, picked pieces for 25 locks at random, and … assembled them again"(Traducción: "desarmó 50 cerraduras, eligió piezas para 25 cerraduras al azar, y... las volvió a armar") [2]: la demostración era la prueba, y el punto de elegir al azar era que el ensamblador no pudiera escoger las piezas que pasarían. Y en 1896 Carl Edward Johansson, inspector-armador en una fábrica de rifles sueca, inventó el juego combinado de bloques patrón [3]: una referencia contra la cual se podían verificar las herramientas de inspección, de modo que el propio calibre tuviera su propio patrón. Cada uno de estos reemplaza el "se ve bien" por una referencia que la pieza debe aceptar y otra que debe rechazar, elegidas para que el inspector no pueda seleccionar los especímenes.
La imagen de la cocina del episodio 1 tiene una última pieza. La balanza que pesa cada plato es confiable porque, antes del servicio, alguien pone un peso conocido y lee el número, y luego el verificador recibe un plato deliberadamente cincuenta gramos más ligero y debe rechazarlo. Un verificador que solo ha aprobado platos podría estar dejando pasar todo. El autotest es el peso conocido y el plato corto, hecho cada vez que abre la cocina.
| Cocina | Repositorio |
|---|---|
| El peso conocido en la balanza antes del servicio, que debe leerse correctamente | El tapón go: un fixture integrado, conocido como bueno, que toda compuerta debe pasar |
| El plato deliberadamente cincuenta gramos más ligero, que el verificador debe rechazar | El tapón no-go: un fixture integrado, conocido como malo, que toda compuerta debe fallar |
| La lista de verificación de apertura que dice que cada balanza fue revisada, o la cocina no abre | El runner: enumera cada compuerta, ejecuta su autotest, sale en rojo si alguna compuerta carece de él o lo falla; el runner es en sí mismo una compuerta |
| Un plato devuelto el mes pasado, cocinado de nuevo para ver si el nuevo cocinero lo detecta | El replay PR: un defecto real del pasado reabierto para que el revisor de IA tenga que marcar error |
La versión a 30 años: un rojo en el que no confías es una compuerta que dejas de mirar
El registro de software suma la otra falla del mismo calibre. Una compuerta que nunca se activa es un problema; una compuerta que se activa cuando no hay nada mal es el mismo problema desde el otro lado, porque ambos terminan con la compuerta siendo ignorada. La medición de Google en 2017 de su propia integración continua es el número de referencia: "84% of transitions from Pass -> Fail are from 'flaky' tests"(Traducción: "el 84 % de las transiciones de aprobado a fallo provienen de pruebas 'inestables'"), y "Almost 16% of our 4.2M tests have some level of flakiness"(Traducción: Almost 16% of our 4.2M tests have some level of flakiness") [4]. Un año antes, el mismo autor había reportado "about 1.5% of all test runs reporting a 'flaky' result."(Traducción: about 1.5% of all test runs reporting a 'flaky' result.") [5] El estudio empírico de 2014 que identificó las causas encontró que "The top three categories of flaky tests are Async Wait, Concurrency, and Test Order Dependency."(Traducción: The top three categories of flaky tests are Async Wait, Concurrency, and Test Order Dependency.") y que "Most flaky tests (78%) are flaky the first time they are written."(Traducción: Most flaky tests (78%) are flaky the first time they are written.") [6] El seguimiento de Google encontró que "larger tests are more flaky"(Traducción: larger tests are more flaky") [7, que es la compuerta de tamaño del episodio 4 llegando desde otro ángulo.
A la escala de Google, con "more than 50,000 unique changes and running more than four billion individual test cases"(Traducción: more than 50,000 unique changes and running more than four billion individual test cases") al día [8], la respuesta a los flakes es infraestructura. El commit queue de Chromium enuncia su regla de reintentos sin rodeos: "If the retry succeeds, then the failure is ignored."(Traducción: If the retry succeeds, then the failure is ignored.") [9] Para un repositorio pequeño, la respuesta es la misma que dan los tapones de 1821: saber, para cada compuerta, qué hace ante una entrada conocida como mala y una conocida como buena, para que un rojo sea realmente un rojo y un verde sea realmente un verde. El autotest es lo que hace que la señal de la compuerta sea lo bastante confiable como para actuar sin reintentos.
Aquí cabe una nota histórica más porque trata sobre el origen de la checklist y desmonta una historia cómoda. El accidente del Model 299 en 1935, usualmente citado como el nacimiento de la checklist de pre-vuelo, ocurrió porque los gust locks quedaron activados, y el informe de seguridad aérea registra que quién los dejó activados "is not clear." (Traducción: is not clear.")"is not clear." [10]. La checklist fue una respuesta a no poder saberlo. Eso es también para lo que sirve un autotest.
La construcción: ambos tapones en cada compuerta, un runner y un replay
1. El contrato de autotest
Cada compuerta en el target de compuertas y en CI, nueve en total, ahora acepta una bandera de autotest. Al ejecutarla, la compuerta no mira el repositorio en absoluto. Construye sus propios fixtures en memoria: un router con una consulta sin el filtro de tenant, un mensaje de commit con un marcador de agente y sin trace trailer, una política con una exención sin motivo, un conjunto de jobs de workflow que contiene un job cancelado de cero pasos, una tabla de reglas con un id cambiado. Ejecuta su propio chequeo sobre cada fixture y afirma el resultado esperado en ambas direcciones: el fixture malo debe producir un hallazgo, y el bueno ninguno. Imprime cuántos chequeos realizó y sale con código de salida distinto de cero si alguna afirmación falla. El contrato está escrito en el archivo de lecciones del repositorio en una frase: una prueba en una sola dirección es igual que ninguna prueba.
Los conteos, leídos directamente de la salida del runner la tarde del 2026-09-09: la compuerta de tenant-and-permission demuestra que 2 chequeos pueden activarse, la de evidence-graph 4, la de submission 10, la de provenance 9, el detector de CI-budget 4, el response clock 11, el AI reviewer 5, la golden case library 5 y la loop audit 5. Nueve compuertas, cada una de las cuales ahora ha sido vista fallar (en rojo), por sí sola, en cada ejecución de CI.
2. El runner también es una compuerta
Un autotest que una compuerta lleva pero nadie ejecuta vuelve a ser solo prosa. Por eso, el runner mantiene la lista de compuertas como datos, ejecuta el autotest de cada compuerta listada y marca error (rojo) si alguna compuerta listada falta, no tiene el flag o falla sus propias aserciones. El runner está tanto en el comando local de gate como en CI, y es la versión automatizada de una de las reglas de revisión del propio repositorio: la regla que dice que toda compuerta debe probar que puede activarse. El runner no puede notar una compuerta que nunca fue listada; la completitud de la lista está garantizada por el criterio estructural de la loop audit, que nombra las nueve compuertas, y por la regla de revisión. La propia loop audit fue escrita con su autotest y añadida a la lista en el mismo PR.
3. El detector que se activó con lo incorrecto
La otra mitad de la regla de 1821 apareció en el inventario del 2026-09-09. El repositorio tiene un detector que observa el historial de ejecuciones de Actions buscando la huella de agotamiento de cuota, que en este esquema se ve como un job con cero pasos. Al revisar las últimas sesenta ejecuciones, se activó en una: un push a main el 2026-09-05 cuyo job de migración tuvo cero pasos porque el siguiente push lo reemplazó nueve segundos después, bajo la regla de concurrencia. La huella del detector coincidió con una cancelación. La solución no fue un umbral. El job lleva su propia conclusión, y un job cancelado lo dice; ahora el detector lee la conclusión y excluye jobs cancelados, saltados y neutrales de la huella, y su autotest incluye un job cancelado de cero pasos que no debe activarse. Un detector con un falso positivo es un tapón no-go que a veces entra, y un equipo que lo ha visto entrar una vez deja de confiar en él. El archivo de lecciones registra que un agotamiento de cuota anterior, de hecho, pasó desapercibido.
4. El PR de replay
El AI reviewer tiene un autotest como los demás, pero su autotest ejercita las partes que no necesitan modelo: el evidence filter, el tier classifier, el brief renderer. El juicio del propio modelo solo puede probarse con un caso real. Así que la construcción del artículo precursor abrió un pull request que reintroduce un defecto conocido y ya corregido del historial del repositorio, el bypass que permitía cerrar una queja sin pasar por su compuerta de cierre, y lo marcó como "do not merge". La regla del reviewer para ese defecto existe; el PR es el tapón no-go para ese caso. Al día de escribir el PR de replay, abierto desde el 2026-09-06, lleva un brief, sin medir por un 401; los once briefs del repositorio dicen lo mismo, porque la key es rechazada en cada ejecución. Permanece abierto, deliberadamente, exento del response clock con una razón escrita, hasta que el reviewer haya fallado (rojo) en él al menos una vez. El artículo que prometió decir cuál resultado llegó dice: ninguno, todavía.
Actualización, esa misma tarde. Una key válida llegó al repositorio alrededor de las 20:00 UTC y el reviewer se volvió a ejecutar sobre el PR de replay. Falló (se puso en rojo): cuatro hallazgos a nivel de bloque, cada uno con archivo y línea, nombrando el bypass, la whitelist eliminada, la auditoría de cierre faltante y los tests borrados, y pidió intervención humana en vez de aprobar. El tapón no-go no entró. La fila "AI has measured a PR" de la loop audit se pone verde en la siguiente ejecución; "Tier-1 has merged once" sigue esperando el plan.
Cinco porqués: por qué una compuerta solo se instala después de haber fallado (rojo)
| # | ¿Por qué? | Porque | Evidencia |
|---|---|---|---|
| 1 | ¿Por qué un verde de una compuerta que nunca ha fallado no vale nada? | Porque una compuerta que no puede fallar produce exactamente el mismo verde que una compuerta que no encontró nada, y nada en la salida los distingue. | Tres protecciones en un repositorio nunca habían fallado; se creía que funcionaban hasta que se revisaron |
| 2 | ¿Por qué la prueba debe ir con la compuerta y no hacerse solo una vez? | Porque una compuerta cambia; la prueba hecha al instalarla no dice nada sobre la compuerta después de su quinta edición, y la edición que la rompe no se anunciará sola. | El runner ejecuta cada autotest listado en cada ejecución de CI; la loop audit se envió con su autotest y su lugar en la lista en el mismo PR |
| 3 | ¿Por qué ambos tapones y no solo el no-go? | Porque una compuerta que falla ante todo se ignora tan rápido como una que nunca falla; el tapón go es lo que hace que el rojo signifique algo. | Google: 84 percent of pass-to-fail transitions were flakes [ (Traducción: Google: el 84 por ciento de las transiciones de aprobado a fallo fueron flakes [)4]; el falso positivo de job cancelado del detector de presupuesto |
| 4 | ¿Por qué el runner mismo debe ser una compuerta? | Porque un autotest que nadie ejecuta es solo una frase en un archivo; la regla del episodio 3 dice que una regla es lo que puedes comparar con diff y la del episodio 2 dice que un chequeo que corre donde la decisión de merge no mira, no cuenta como tomada. | El runner está en el comando local de compuertas y en CI, y marca error si falta una compuerta listada, le falta la bandera o falla. |
| 5 | ¿Por qué mantener un PR de replay abierto y sin medir? | Porque la única compuerta cuyo juicio no puede ser simulada es la del modelo, y los únicos estados honestos para ella son "falló ante el defecto conocido" y "aún no lo ha hecho"; cerrar el PR convertiría "aún no lo ha hecho" en silencio. | El único brief del PR de replay, sin medir con un 401; exento del response clock con una razón escrita |
La raíz, en una frase:el verde de una compuerta solo es evidencia si esa misma compuerta ha sido vista fallar (en rojo) ante una entrada conocida como mala desde su último cambio, y esa comprobación debe ser parte de la compuerta.
Constrúyelo en 30 minutos: el contrato de autotest
Treinta minutos es el presupuesto del contrato para quien lo copie; no es un tiempo que yo haya medido.
| Elemento | Especificación |
|---|---|
| Bandera de autotest | Cada compuerta acepta --selftest. Construye sus fixtures en memoria, no toca nada en el repositorio y afirma en ambos sentidos: conocido-malo ⇒ hallazgo; conocido-bueno ⇒ ningún hallazgo. |
| Salida | Una línea: cuántos chequeos, todos probados capaces de activarse. Código de salida distinto de cero ante cualquier aserción fallida. |
| Runner | Una lista de rutas de compuertas como datos. Para cada una: ejecuta el autotest; archivo faltante, bandera faltante o código de salida distinto de cero ⇒ rojo. El runner está en el comando local de compuertas y en CI. |
| Huellas del detector | Lee el campo de conclusión propio de la plataforma antes de comparar la forma; excluye cancelados, saltados y neutrales. Pon el falso positivo que te enseñó esto como un fixture en el autotest que no debe activarse. |
| PR de replay | Un PR que reintroduce un defecto real ya corregido, marcado como do-not-merge, exento del response clock con una razón escrita, y que solo se cierra después de que el revisor haya fallado (en rojo) ante él. |
| Invariante | conocido-malo ⇒ hallazgo Y conocido-bueno ⇒ ningún hallazgo, para cada compuerta, en cada ejecución. |
| Regla de detención | Cualquier compuerta listada que no tenga ambos tapones, o que falle la auto-prueba, pone en rojo toda la ejecución de CI; nada se fusiona después de eso. |
| Reportes | El criterio estructural de la auditoría de bucles cuenta las compuertas con autotest; el criterio funcional ejecuta el runner; ambos se leen en cada ejecución de CI. |
| Ausencias deliberadas | Sin reintentos por flake en compuertas; sin biblioteca compartida de fixtures; sin mocks de la plataforma más allá de los fixtures en memoria. Cada uno sería un lugar donde el autotest podría probar algo que no sea la compuerta. |
# The contract is two assertions per rule, inside the gate itself.
def selftest():
    bad  = fixture_with(agent_marker=True, trace_trailer=False)   # must fire
    good = fixture_with(agent_marker=True, trace_trailer=True)    # must not
    assert check(bad),      "the gate never fires: not installed"
    assert not check(good), "the gate fires on a good input: will be ignored"
    print("selftest: 2 checks, all proven able to fire")

# The runner refuses a gate without one.
GATES = ["scripts/check_tenant_perm.py", "scripts/check_provenance.py", ...]   # data
for g in GATES:
    rc = run([python, g, "--selftest"])
    if rc != 0: fail(f"{g}: no self-test, or it failed")
La misma historia, cinco salidas
| Lector | La única decisión | La única acción |
|---|---|---|
| Estudiante | Una verificación que nunca has visto fallar no es una verificación. | Toma algo que "siempre pasa" y dale un caso que deba fallar. Observa qué sucede. |
| Ingeniero | Ambos tapones, en la compuerta, en cada ejecución. | Agrega --selftest a tu compuerta de mayor confianza hoy, con un fixture conocido-malo y uno conocido-bueno. |
| Fundador | Cuenta cuántas compuertas realmente han sido vistas en rojo. | Pide ese número esta semana. Si es cero, la insignia del README es solo decorativa. |
| Ejecutivo | Los tapones de 1821 venían en pares por una razón. | Pregunta cuáles de tus controles tienen una prueba negativa documentada y cuáles solo se cree que funcionan. |
| Inversionista | Un equipo que mantiene un PR de repetición abierto y sin medir está reportando con honestidad. | Pide ver una compuerta fallando a propósito, en el historial de CI del propio equipo. |
Patrones, antipatrones y el primer principio
Patrones que se mantuvieron. Fixtures en memoria, en ambos sentidos, dentro de la compuerta. Un runner cuya lista de compuertas es dato y que él mismo es una compuerta. Conclusiones leídas antes de comparar formas. Un falso positivo convertido en fixture. Un PR de repetición mantenido abierto y exento hasta que el modelo ha fallado sobre él.
Antipatrones que esto reemplazó. Un linter que se saltaba en silencio si no estaba instalado. Un bot documentado como presente y nunca conectado. Un detector cuyo fingerprint coincidía con una cancelación. Seis compuertas que se creían funcionales porque nunca se las había visto fallar.
El mecanismo, nombrado. Un autotest convierte "la compuerta funciona" de una creencia sobre el pasado en una medición tomada en cada ejecución, y el runner convierte "todas las compuertas tienen uno" de una convención en un rojo.
El primer principio, en una frase. Confía en una compuerta en proporción a cuán recientemente la viste fallar a propósito.
La temporada, en una tabla, y la tabla de resultados
ANDON fueron cinco reglas, un repositorio y un día de construcción contra un registro de cuatro horizontes. Aquí están las cinco, cada una con la letra, la tesis del episodio y el elemento en el repositorio que representa esa regla, para que la serie pueda comprobarse contra el código y no solo recordarse.
| Letra | Regla | Tesis | En el repositorio |
|---|---|---|---|
| A | Medir con números | La inundación se mide, no se siente; la compuerta automática es la balanza, no el chef | Las mediciones en vivo del dossier; las compuertas automáticas que deciden solo lo que un script puede decidir |
| N | Nunca en silencio | Una compuerta que no pudo ejecutarse publica "unmeasured"; el response clock corre con un cron | El tercer estado del revisor; el SLA bot; los criterios P de la loop audit |
| D | Datos, no prosa | Una regla es aquello que puedes comparar en un diff; la documentación se genera a partir de ella y se verifica | Tres archivos JSON; el generador; la comprobación de deriva probada en rojo manualmente |
| O | Solo dentro del sobre | Donde un bot puede hacer merge es una lista de rutas; el deny manda; cinco condiciones a la vez | El sobre de auto-merge; el clasificador de niveles; las compuertas de procedencia y tamaño |
| N | Prueba negativa | Una compuerta solo se instala después de haber fallado (marcado rojo) a propósito, y la prueba de ello viaja con ella | El autotest en cada compuerta; el runner; el PR de repetición (replay PR) |
| Tabla de resultados de la temporada | Primera mañana, 2026-09-09 | Última tarde, 2026-09-09 |
|---|---|---|
| PR abierto más antiguo sin primera respuesta | 57 horas, tres PRs | los mismos tres; etiquetados, en la tabla, aún sin respuesta |
| Compuertas con un autotest que demuestra que pueden marcar rojo | 0 de 6 | 9 de 9, verificados por un runner que es compuerta en sí mismo |
| Commits asistidos por agente desde el 1 de septiembre con trace trailer | no medido | 11 de 21; requerido en nuevos commits por la compuerta de procedencia |
| Criterios de auditoría de ciclos no medidos | no existía auditoría | 2 de 23: la IA no ha medido un PR; Tier-1 no ha hecho merge de ninguno |
| Resúmenes de IA publicados / en silencio | 3 / 0 | 11 / 0, todos sin medir por una key rechazada |
Tres de esas filas son los fracasos honestos de la temporada. La primera fila es la que dio nombre a la temporada para cambiarla, y no lo hizo: los tres PR de cofundadores pasaron toda la temporada sin respuesta humana. La máquina los etiquetó el mismo día; el responsable nunca respondió, y eso es una acción de una persona, no una configuración. Las otras dos son el mismo fallo visto desde dos ángulos: una key rechazada y un plan que no ha llegado al repositorio. Todo lo que construyó la serie clasifica, publica, etiqueta, audita y rechaza correctamente sin ellos. Nada de lo que construyó la serie afirmará haber medido un PR o fusionado uno hasta que realmente lo haya hecho. Esa fue la primera regla, y es la última.
Misión real
El episodio 4 prometió que para el episodio 5 cada compuerta habría demostrado poder marcar error (ir a rojo) con su propio self-test, y que el replay PR habría producido el primer hallazgo medido del revisor o seguiría esperando la key, con el artículo diciendo cuál. Lo primero ya está: nueve de nueve, en cada ejecución de CI. Lo segundo era el segundo caso al cierre de edición: un brief sin medir en el replay PR, igual que los otros diez en el repositorio; por la tarde llegó la key y el revisor marcó error, como quedó registrado arriba. La misión de la temporada, que no tiene siguiente episodio que la sostenga, son tres filas de la tabla de resultados. La primera fila es misión de persona, no de máquina: responder los tres PR de cofundadores, y el tablero mostrará que se quita la etiqueta. Cuando se rote la key, el siguiente brief del replay PR será medido; el revisor marcará error sobre el defecto conocido o la afirmación central de la serie sobre él habrá sido falsa, y el dossier dejará constancia. Cuando el plan llegue al repositorio, un comando instala la protección de rama, y el siguiente PR solo de docs dentro del sobre se fusionará solo o la auditoría dirá por qué no lo hizo.
Sigue leyendo
Episodio 5 de ANDON · Revisión de PR agéntica y CI/CD, el último. Cada número está acotado donde aparece; la cocina es un modelo, no una medición. Los self-tests, el runner, el detector y el replay PR existen en un repositorio privado; sus formas se reproducen en el contrato para que nada dependa de tener acceso. El dossier de cuatro horizontes que cita la temporada está registrado en el directorio de planes del portafolio.
Referencias
- Raber, Malone, Gordon, Cooper, Conservative Innovators and Military Small Arms: Springfield Armory 1794–1968, NPS 1989/2006, p. 138 (Stubblefield and Lee to Bomford, 1821-12-04, NARA RG 156/21). npshistory.com
- Roser, 230 Years of Interchangeable Parts, AllAboutLean, 2015-07-08. allaboutlean.com
- Science Museum Group, Set de bloques patrón Johansson, c. 1900, objeto co59398. collection.sciencemuseumgroup.org.uk
- Micco, The State of Continuous Integration Testing at Google, keynote ICST 2017. aster.or.jp
- Micco, Flaky Tests at Google and How We Mitigate Them, 2016-05-27. testing.googleblog.com
- Luo, Hariri, Eloussi, Marinov, An Empirical Analysis of Flaky Tests, FSE 2014. mir.cs.illinois.edu
- Listfield, Where do our flaky tests come from?, 2017-04-17. testing.googleblog.com
- Software Engineering at Google, capítulo 23, Continuous Integration, 2020. abseil.io
- Chromium, Commit Queue documentation. chromium.googlesource.com
- Flight Safety Australia, Una cosa a la vez: una breve historia de la checklist, 2018-11-12. flightsafetyaustralia.com