AI-Nativeシリーズ · ANDON · エージェント型PRレビューとCI/CD · 第1回(全5回)
PR洪水は「感じる」ものではなく「測る」ものだ
エージェント型PRレビューとCI/CDの第1回。コーディングエージェントの普及でGitHubのマージPRは3倍以上に増え、実際に計測した企業では人間レビューが細いボトルネックになった。そして今月、AIが必須承認者として認められるようになった。本稿では、洪水の規模を数字(N)と日付で示し、この30日間で何が変わったかを整理し、「なぜ最初に機械ゲートが必要なのか」を5回の『なぜ』で掘り下げる。
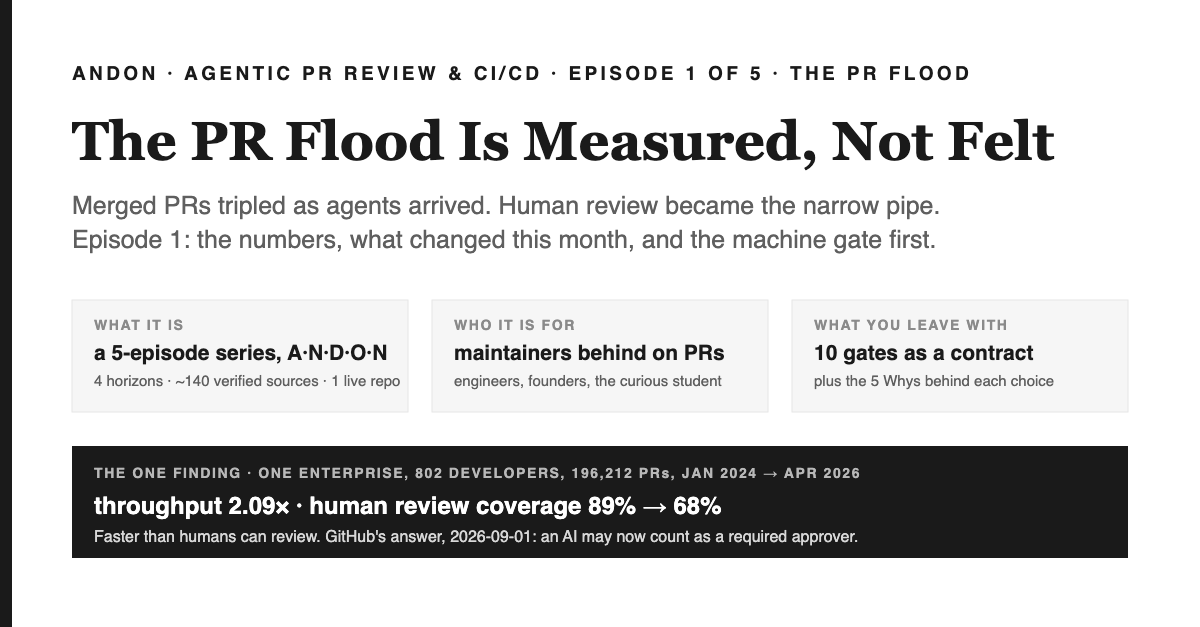
1分でつかめる要点──読み終えたときに手に入るもの
本稿の内容 ANDON ANDONは、エージェント型PRレビューとCI/CDをテーマにした全5回シリーズの第1回。4つの時間軸(30日、30カ月、30年、300年)でリサーチし、実際のリポジトリでゲートを構築しながら執筆した。この回は「PR洪水」そのもの──どれほどの規模か、どこで測定されたか、この1カ月で何が変わったか、そして最初のゲートはなぜ意見を持たない機械でなければならないのか、を扱う。PR洪水 とは何か――どれほどの規模か、どこで測られているのか、この1カ月で何が起きたのか、そして最初のゲートが「意見を持たない機械」でなければならない理由を問う。
なぜ今、これが重要なのか。 エンジニアなら:ボトルネックは「コードを書く」から「コードを評価する」へと移った。しかも、その評価を担うツールが今やマージボタンを押せるようになった。創業者なら:レビュー能力こそがエージェントをどれだけ解き放てるかの制約であり、その数字は自分のリポジトリから5分で読み取れる。学生なら:これが「制約が移動した」ことのデータ上の姿であり、その最古の答えは1821年の鉄製プラグ一対だ。
このエピソードを読んだ後にできること 3つのコマンドで自分の洪水を測り、10個ある機械ゲートのうち何が足りないかを見極め、下記の「30分契約」から導入する。その後、エピソード2〜5でAIレビューアを信頼できるものにする4つのルール――「決して沈黙しない」「ルールはデータで書く」「封筒の内側だけ」「ネガティブテスト」――を読むとよい。
ANDON — シリーズの背骨
- A · Assess ― PR洪水は「感じる」ものではなく「測る」もの この回
- N · Never silent ― リポジトリの自働化 第2話
- D・Data, not prose(散文ではなくデータ) — ドリフトしないルール 第3話
- O・エンベロープの内側だけ――被害範囲はパスリストで決まる 第4話
- N · Negative test ― ゲートは意図的に赤になって初めて設置される 第5話
このシリーズが描くもの、そしてなぜ「PR洪水」が第1話なのか
コーディングエージェントが次々とプルリクエストを開く。かつては週に数件の人間PRしか来なかったリポジトリが、今やCopilotのコーディングエージェント、Codex、Claude Code、Cursor、Devinから何十件も届くようになった。どれも礼儀正しく、もっともらしく、誰かの「承認待ち」だ。本シリーズが扱うのは、それらPRとmainブランチの間に立つもの――機械ゲート、AIレビューア、マージキュー、そして最後に残すべき人間の決断である。遅れ気味のメンテナ、何を自動化するか悩むエンジニア、何を信頼するか決める創業者、そして「制約がデータで動く」現場を見たい学生のために書いた。
タイトルの由来はトヨタのアンドンコード。トヨタのラインでは、誰でも異常時にアンドンコードを引いて生産を止められる。そのコードが信頼されるのは、実際によく引かれるからだ。ANDONの5文字は5つのルールを表し、それぞれが1エピソード。私が共同構築したプライベートな製造品質管理リポジトリでは、これらのルールがすでに実装されている。このシリーズのゲートも、その現場で研究しながら設置した:Aまず数字で洪水を評価し、ゲートを選ぶ前に必ず測ること。N決して沈黙せず、動かなかったゲートはPR上で「未計測」と宣言する。Dルールは散文でなくデータとして1ファイルにまとめ、ドリフトチェックする。OAIがマージを引き起こせるのは、パスで定義した「封筒」の内側だけ。Nネガティブテスト――信号が緑になる前に、意図的にコードを引いて止めてみる。
なぜ洪水が第1話なのか。それは、後続のすべての判断がこの規模感に左右されるからだ。週5件のPRを想定したゲートと、週50件をさばくゲートでは、設計も運用もまったく異なる。そして直感に頼る危うさも、データが示している。AIコーディングツールのランダム化試験では、経験豊富な開発者たちは「20%速くなった」と感じていたが、実際には19%遅くなっていた。感覚は測定ではない。だからこのエピソードは、まず数字――Nと日付――から始める。次に、直近30日でマージボタンを変えた出来事、シリーズ全体を象徴する一枚の図、実際のケース、そして「なぜ最初に機械ゲートなのか」を5回問い詰めていく。
洪水のスケールを数字で捉える
数字には3つの種類があり、しかも互いに食い違う――それ自体が重要な発見だ。プラットフォーム全体の集計、企業内の現場調査、統制された実験。それぞれ測っているものが違うので、表では必ずスコープを明記している。
| 測定項目 | 数値 | スコープ・日付 |
|---|---|---|
| GitHub全体の月間マージPR数 | 約2,500万 → 9,000万超(3.6倍) | プラットフォーム全体、2023年1月~2026年中頃、GitHub公式ブログ、2026-06-18[1] |
| 1年間でマージされたPR数 | 518.7M (+29%) | Octoverse 2025、2025-10-28;Copilotコーディングエージェント単体で最初の5か月間に100万件超のPRを作成[2] |
| ある企業で週にマージされた完全AI作成PR数 | 1,000件超 | Stripe、2026-02-09;人間によるレビュー済み、「人間が書いたコードはゼロ」[3] |
| 「2倍」指令下での一人当たりスループット | 2.09× | ある企業、開発者802人、196,212件のPR、2024年1月~2026年4月[4] |
| 人間によるレビューが入ったPRの割合(同調査) | 89% → 68% | 同じ企業;AIレビューのカバレッジは同期間で約19%から84%に上昇[4] |
| CLIコーディングエージェント導入後の開発者一人当たりマージPR数 | +24% | 数万人規模のMicrosoftエンジニア、観察研究、2026-07-01[5] |
| AIツール利用時のタスク完了時間(ランダム化試験) | −19%(遅くなった);開発者の体感は+20%程度の高速化 | 経験豊富なOSS開発者16人、246タスク、2025年初頭;2026年2月の再試行では新規参加者で−4%(幅広い区間)、著者らは選択バイアスを考慮して設計変更[6, 7] |
| コーディングエージェントの痕跡が確認されたプロジェクト | 22–29% | GitHub上で128,018件、2026-01-26[8] |
| エージェントごとに層別したエージェントPRの受理率 | 68–80% | 7,156件のPR:Codex 79.9%、Cursor 74.4%、Claude Code 72.6%、DevinおよびCopilot 68.0%、2026-02-09[9] |
| 説明がコードと食い違うエージェントPR | PR全体の1.7%が著しく不一致で、そうしたPRのマージ率は28.3%(他は80.0%)、所要時間は3.5倍 | 23,247件のエージェントPR、2026-01-08[10] |
| 2つのエージェントが重複PRで同時稼働しているリポジトリ | 40.2%;エージェント間のコンフリクト率41.7%(単一エージェント内は19.8%) | 33,596件のエージェントPR、2,807リポジトリ、2026-07-06[11] |
| メインブランチの破損率:AI支援あり/なし | 1.9% 対 4.4% | 20万件超のマージ、477組織がマージキューを利用、2026-07-27;キューの94%は1件ずつ処理[12] |
この表は断定的な結論ではなく、全体像を捉えるためのものだ。プラットフォーム全体ではボリュームが3倍に増え、綿密に自己計測した企業でも2倍になった。そのうち人間が実際にレビューした割合は同じ企業で2割減り、モデルによるレビューは2割から大半へと置き換わった。エージェントPRの受理率はエージェントやタスクごとに層別すれば人間並みだが、失敗するものは規模が大きく、より多くのファイルに触れ、CIに失敗し、diffに書かれていない内容を説明に含む傾向がある。そして、これらが個人の生産性を本当に高めているかについては、依然として結論が出ていない。ランダム化試験ではむしろ遅くなり、著者らは「AIなし」群を開発者が拒否するため設計自体が成立しないと後に述べている。
企業レベルの数字こそがメンテナーの実感に直結する。CodeRabbitは2026-08-26、パブリックリポジトリ向けに1,000万ドル分の無料レビューを発表した際、こう言い切った:
"AI has completely collapsed the cost of producing a contribution, shifting the great bottleneck of software development from generating code, to judging it."(訳:AIは貢献を生み出すコストを完全に崩壊させ、ソフトウェア開発の最大のボトルネックをコード生成から審査へと移した。)
— CodeRabbit, 2026-08-26[13]
curlのメンテナーも受け手側から同じ現象を計測している。2025年のセキュリティ報告の約20%がAIによる粗悪なもの、約5%が本物であり、2026年1月には有効報告率が5%を下回ったためバグバウンティを終了した[14, 15].
直近30日間で何が起きたか
リサーチ期間は2026-09-09に終了し、その直前の1か月で「マージ」ボタンの意味自体が変わった。
- 2026-09-01:AIが必須承認者としてカウントされるようになった。 GitHubのCopilotコードレビューが、リポジトリの必須承認ルールを満たす承認レビューを提出できるようになった。デフォルトでは無効で、エンタープライズ・組織・リポジトリ単位で設定可能。承認は人間同様、新たなpushで無効化される。GitHub自身の文言はその違いを明確にしている:"An approval assessment alone does not count toward merge requirements."(訳:承認評価だけではマージ要件を満たさない。) [16] その5日前、Copilotはボット作成PRのレビューを開始し、300ファイル上限を撤廃した[17].
- 2026-09-02:PRを作成したエージェント自身が、そのPRを最後まで着地させるようになった。 Agent Merge(パブリックプレビュー中)は「レビュー指摘への対応、失敗したチェックやマージコンフリクトの修正、ワークフローの再実行」を繰り返し、PRがマージ可能になるまで自動で進める[18, 19]。Cursorも2026-08-19に同等の機能をリリースしている。クラウドエージェントが「自分で作成したPRに自動でサブスクライブし、CI修正やボットコメント対応を行い、完了まで導く」[20].
- レビューのコストがラベルで明示されるようになった。 Copilotによるレビューは「Lite」なら1回あたりAIクレジット$0.05〜$1、「Balanced」では$0.25〜$5と見積もられ、2026-09-28にデフォルトがBalancedへ切り替わる[21, 22]。AnthropicのマネージドCode Reviewは1回平均$15〜$25、所要時間は約20分で、意図的にブロックではなく中立チェックとして返す[23].
- オープンソースAIポリシーの初の実態調査。 上位2,000のGitHubリポジトリにおける281件のポリシーのうち、83.3%がAIによる貢献を許可または推奨、14.9%が禁止、48.8%が開示を要求、67.3%が高い人間関与を求めている(arXiv, 2026-09-07)[24]。Debianは2026-08-30に寛容な方針を採択し、GCCは「法的に重要」とされるLLM由来の貢献(おおよそ15行以上)を拒否。Linuxカーネルは
Assisted-by:トレーラーを受け入れるが、署名は必ず人間が行うことを求めている[25, 26, 27]. - 資本は生成AIではなく、運用・ガバナンスに流れた。 CodeRabbitは2026-08-12に「Agentic Change Management」目的で$1.5B評価額・$143Mを調達。Qodoの2.8/2.9リリース(2026-08-16, 2026-09-07)では、レビュー・ルール・指摘解決をClaude Code、Codex、Kiro内に統合し、PRごとに「blast radius」リスク区分を導入。Mergifyは2026年8月のchangelogで積み上げPRのマージキュー対応を追加した[28, 29, 30].
まとめると、コードを書くツールがそのままレビュー・承認・チェック修正・マージまで担えるようになり、それを許可するかどうかはリポジトリの設定次第となった。つまり、その設定自体が設計であり、次の4エピソードはこの設計を掘り下げる。
シリーズ全体を一枚で表す:キッチンの三段階パス
本気のキッチンでは料理が三つのパスを経て外に出るが、その違いは厳しさではなく性質にある。パス1は秤・温度計・伝票チェックで、そこには意見がなく、軽すぎる皿は誰が作っても出ない。パス2はスーシェフが味見し「三杯目のレードルは塩が強い、出すかどうかはあなた次第」とメモを書く。メモはレードルを指す。パス3でシェフがそのメモを読み、該当の一口を味見し、出すか否かを決める。冷菜はスーシェフの味見で出せるが、ドレッシング違いは作り直しで返金ではない。温菜は必ずシェフの判断を待つ。
| キッチン | リポジトリ | エピソード |
|---|---|---|
| 秤:意見なし、軽すぎる皿は絶対に出ない | マシンゲートG1〜G10:全書き込み経路にテナントフィルタと権限チェック、秘密形状の禁止、モデル変更には必ずマイグレーション、全idカラムは外部キー、ドキュメントは多言語同時、テスト・ゴールデンケース・由来・サイズ、全ゲートが必ず赤(fail)を出せること | 1と5 |
| キッチン独自の停止:バネが切れたら止まるミキサー、「秤が壊れている」と推測せずに言う料理人 | 実行できなかったゲートやレビュワーはPRに「unmeasured」と投稿する。誰かの記憶に依存しない応答時間ボット。 | 2 |
| 誰もが同じように読むレシピカード | ルールは1ファイルにデータとして記述し、ドキュメントやレビュアープロンプトに自動で反映される。CIでドリフトチェックも行う。 | 3 |
| 冷菜はシェフの最終確認なしで出せるが、温菜は必ずシェフが味見してから出す。 | AIがマージを起こせるのは、自分で選んでいないパスエンベロープ内だけ(5条件のうちの1つ)であり、アプリケーションコード・マイグレーション・CIは常にその外にある。 | 4 |
| サービス前に既知の重りを量り、スケールが正しく動作していることを証明する。 | すべてのゲートは、意図的に欠陥を仕込んで赤になるセルフテストを備えて出荷される。既知の不良PRで一度でも赤になって初めて、レビュアーとして設置済みと見なす。 | 5 |
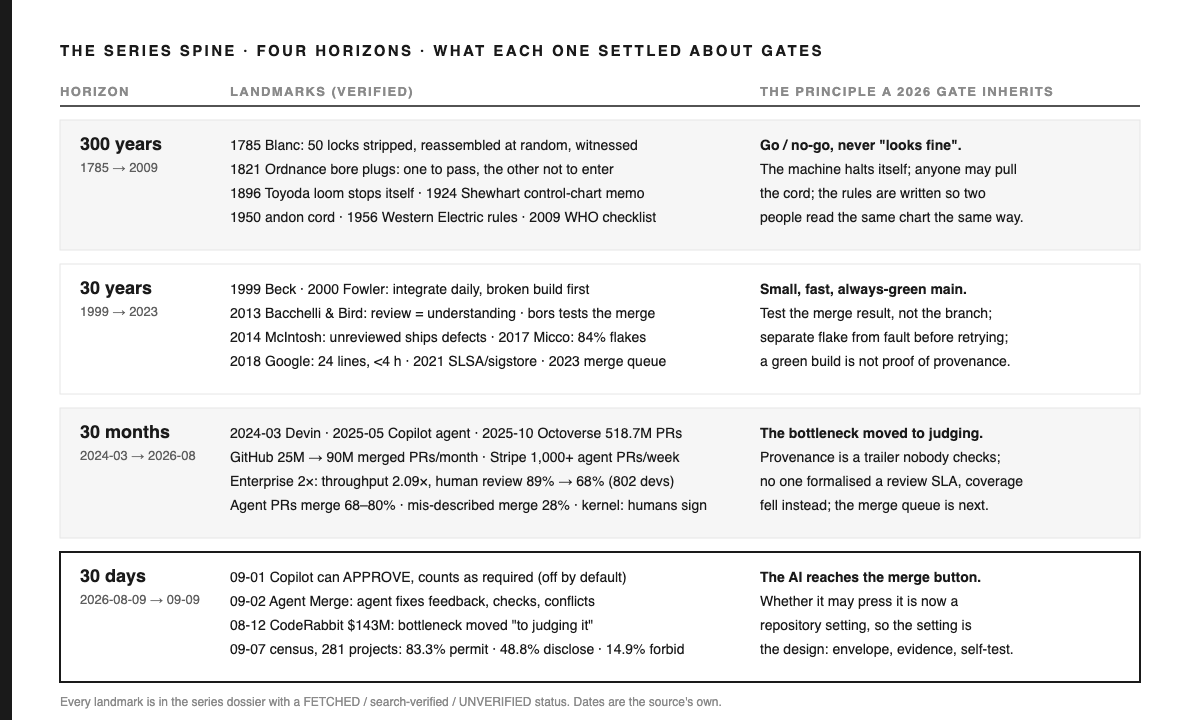
古い行はここで明示しておくことで、図が本文以上の主張をしないようにしている。Blancは1785年、50丁のマスケット銃のロックを分解し、無作為に選んだ部品で再組み立ててみせた[38]。Googleの2018年の調査では、約900万件のレビュー済み変更の中央値は24行の修正、完全レビューの中央値遅延は4時間未満だった[39]。McIntoshらは2014年、レビューのカバレッジや参加率が低いと、コンポーネントごとにリリース後の欠陥が2件、5件と増えることを発見した[40]。Miccoは2017年、Googleの合格→不合格遷移の84%がフレークテストに起因していたと報告した[41]。SLSAとsigstoreは2021年、SolarWinds事件への対応として登場した[42]。WHOの外科チェックリスト試験(2009年)は、8病院で死亡率を1.5%から0.8%に半減させた[43]。図の残りのランドマーク:Beckは1999年に継続的インテグレーションをエクストリーム・プログラミングの実践として命名し、Fowlerは2000年にその標準記述を書いた(ビルド修正より優先されるタスクは誰にもないというルール)[44, 45]。Rustプロジェクトのbors botは2013年からマージ結果をテストし、GitHubは2023年7月にマージキューを一級機能にした[46, 47]。Devinは2024年3月にローンチ、GitHubのCopilotコーディングエージェントは2025年5月にパブリックプレビュー入り[48, 49]。Shewhartの管理図提案メモは1924年5月16日付[50]。それぞれ該当エピソードで再登場する。
実例:2026-09-09時点のあるリポジトリ
このリポジトリは工場向けの品質管理システムで、すべての記録が顧客監査の証拠として引き出される可能性がある。マージされた欠陥は単なるバグではなく、虚偽記録になる。メンテナはドメイン共同創業者と私の2名で、私の貢献の大半は私が指示するAIセッションによるものだ。このエピソードの調査が終わった朝、誰でも実行できる3コマンドでリポジトリの数字を読み取ったところ、規模は10分の1ながら文献と同じ形をしていた。
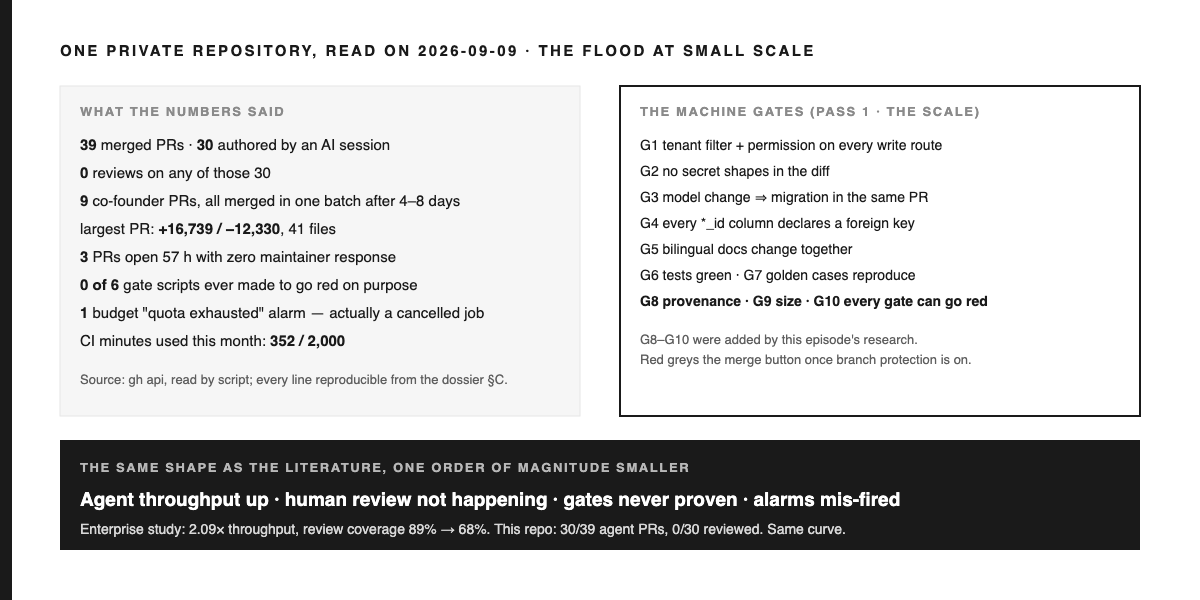
本シリーズのドシエには約140件の情報源があり、それぞれ取得・検索検証・未検証の区別がある。当日のリポジトリ自身の数字:マージ済みPR39件、最大はUI再構築で+16,739行/−12,330行・41ファイル、月間2,000CI分のうち352分消費。39件中30件はAIセッション作成で、その30件はすべてレビューなし(レビューできる人=エージェントを指示した人だったため)。共同創業者の9件は4〜8日待機後、1日でまとめてマージ。彼の新規PR3件は57時間オープンのまま誰も反応せず。6つのゲートスクリプトは一度も意図的に失敗させたことがなく、7つ目のゲート(テストスイート)は唯一スクリプトでない。CI分監視スクリプトは「クォータ枯渇」アラームを出したが、実際は9秒前の並列キャンセルだった。
この最後の行が肝だ。誤検知する検出器は、ないより悪い。次のアラームが無視されるからだ。このリポジトリも、2026年8月下旬(8/21〜8/30、ログ上11日間)に、Actions分枯渇でCIが黙って死に、誰もアラームを見ていなかったことでほぼ丸ごと失った。エピソード5はその話、エピソード2は57時間の話だ。本エピソードの仕事は図の右側7ゲートで、調査で3つ追加された:AIマーカー付きコミットがプライベートマージの14.4%しかないという文献を受け、誰もチェックしない慣習に頼っていたためのプロベナンスゲート、失敗するPRは大きいのでエージェント支援PRに下限を設けたサイズゲート、6ゲートスクリプトが一度も赤になったことがなかったためのセルフテスト契約だ。
なぜ最初に機械ゲートが来るのか──5回のなぜ
このシリーズの特徴は、同じ問いを5回繰り返し、答えが好みから仕組みに変わるまで掘り下げることだ。エピソード1の選択、すなわち最初のパスは意見を持たない機械であり、人間レビュアーより前に来る理由について、ここで示す。
| # | なぜか? | 理由 | 根拠 |
|---|---|---|---|
| 1 | なぜAIレビューアを最初のゲートにしてはいけないのか? | モデルによるdiff判定は確率的であり、議論可能なマージ条件は貢献者の論争の種になる。秤は交渉しない。 | 自動レビューアは実際のPRでは“期待より劣る”パフォーマンスで、設計上の問題よりも機能的なエラー検出に強い。実運用中の産業用レビューアではコメントの26.7%がすでに時代遅れになっていると報告されている[31, 32] |
| 2 | なぜマシンゲートはテナント分離、秘密情報、マイグレーション、外部キーを必ずカバーしなければならないのか? | それらは品質システムで虚偽記録を生む失敗であり、虚偽記録は監査で絶対に許されない唯一の欠陥だからだ。しかも、これらはスクリプトで完全に判定できる。 | リポジトリ自身のルール、そして1821年の事例:ボアプラグは通るか通らないか、どちらかしかない[33] |
| 3 | なぜゲートの結果はAIブリーフにそのまま添付し、再判定しないのか? | 確定済みチェックへのセカンドオピニオンはノイズであり、そのノイズが人をブリーフから遠ざける。人間のレビューアは理解に注意を使うのであって、秤を再実行することには使わない。 | Bacchelli and Bird, ICSE 2013: reviews are "less about defects than expected" and more about understanding [(訳:レビューは期待されたほど欠陥検出のためのものではなく、理解のためのものだった)34] |
| 4 | なぜルールはデータとして書き下す必要があるのか? | 同じチャートを読んでも、ルールがデータ化されていなければ二人のレビューアは異なる判定に至る。これはWestern Electricが1956年に運用ルールを公開して解決した、まさにその問題だ。 | Western Electric rules: "to ensure that line workers and engineers interpret control charts in a uniform way" [(訳:現場作業者と技術者が管理図を同じように解釈できるようにするため)35]; 第3話 |
| 5 | なぜゲートは意図的に失敗させてからでないと有効とみなされないのか? | 一度も赤になったことがないゲートは、緑色の飾りと区別がつかない。このリポジトリでも1か月の間に3つあった:インストールされていないときに黙ってスキップするリンター、存在すると書かれていたが実在しなかったPRテンプレートボット、そして8月下旬の沈黙したCI。織機が信頼されるのは止まるからだ。 | トヨタ自身による1896年の横糸切れ停止装置と1950年のアンドンコードの説明[36, 37]; 第5話 |
根本は一文でこうだ。マージ条件は誰も議論できないものでなければならない。だから機械でなければならず、書き下されていて「ノー」と言える必要がある。 AIレビューアが加えるものは、必ずその上に積み重なるものであり、決して土台の代わりにはならない。
30分で作る:マシンゲート層を契約として
「三十分」は、この契約が「新しいリポジトリにこれをコピペする読者」に割り当てる目安時間であり、私自身が計測したものではない。実例で使った七つのゲート(スクリプト六本+テストスイート)は何度かに分けて作り、追加の三つは調査も含めて一日で仕上げた。
| 要素 | 仕様 |
|---|---|
| まずは現状把握 | 三つのコマンドで五分:マージ済みPRを著者・マージ担当・規模・レビュー数つきで一覧、未マージPRを経過時間・ラベルつきで一覧、直近六十件のCI実行を結論つきで一覧。どのゲートにも手を付ける前に、日付入りで数字を書き出しておく。 |
| 入力 | マージベースとの差分、変更ファイル一覧、コミットメッセージ(トレーラー用)、PR本文(証拠貼り付け用)。 |
| 最低限の七ゲート | G1 すべての書き込み経路にテナントフィルターと権限チェック(ASTパス、grep不可)を通す。G2 追加行に秘密形状がないこと(位置は報告、値は絶対に出力しない)。G3 モデル変更にマイグレーションが同一PR内にない場合はブロック。G4 各*_idカラムが外部キーを宣言するか、合理的な免除理由を持つ。G5 ペア言語のドキュメントは同時に変更。G6 テストスイート。G7 決定的関数が標準出力を必ず再現するゴールデンケース集。 |
| 洪水で追加された三つ | G8 プロベナンス:AI共同著者マーカー付きコミットは、そのセッションやツールへのトレースも必須。botは絶対にサインオフ不可。エージェント補助PRは検証出力を貼り付ける。G9 サイズ:データ駆動の上限を超える有効行数はブロック、エージェント補助PRには下限も設け、lockfileは除外。G10 セルフテスト:すべてのゲートは、意図的な欠陥で失敗できることを示すフラグを持ち、どれか一つでも欠ければランナーがCIを失敗させる。 |
| 不変条件 | 赤いゲートはブランチ保護下でマージボタンをグレーアウトする。どのゲートも黙ってスキップしない。ツール欠如・キー欠如・例外はすべて赤であり、緑にはならない。 |
| 停止ルール | ゲートはプッシュごとに一度だけ実行。ゲート内でのリトライはなし。フレーク(不安定)な結果はゲート自体の欠陥であり、ループの理由にはならない。 |
| 閾値はデータで管理 | 一つのJSONファイル:有効行数400で警告、3,000でブロック、エージェント補助は1,500でブロック、ファイル数60でブロック。変更はPRで行う。 |
| 意図的に省いているもの | この層にはAIは一切入れない。フレークテストの隔離もまだ。マージキューも、計画がブランチ保護をサポートするまで入れない。いずれもエピソードや計画判断であり、契約の抜けではない。 |
# Measure first (five minutes, any repo)
gh pr list --state merged --limit 100 --json number,author,mergedBy,additions,deletions,changedFiles,reviews
gh pr list --state open   --json number,createdAt,author,labels,reviews
gh run list --limit 60    --json conclusion,createdAt,updatedAt

# Then the gate layer, one command locally == CI
make gate    # lint · tenant-perm · graph · pr-ready(P1..P6) · selftest · migration · tests · eval
同じ話から五つの出口
| 読者 | 一つの決断 | 一つのアクション |
|---|---|---|
| 学生 | 「書く」から「判断する」へと制約が移った。判断力を鍛えよ。 | パブリックリポジトリで毎日1件、エージェント作成のPRを読み、レビューを見る前に「マージすべきか・理由」を自分で書き出す。 |
| エンジニア | ゲートを選ぶ前に、まず自分の現状(PRの流量)を計測せよ。 | 今日、自分のリポジトリで上記3コマンドを実行し、その数値をREADMEに記録する。 |
| 創業者 | エージェントをどこまで動かせるかはモデル品質ではなく、レビューの処理能力が上限になる。 | 先月マージされたPRのうち、人間がレビューした割合を確認し、その数字が自社にとって望ましい方向に進んでいるかを問え。 |
| 経営層 | “An AI may approve” is now a setting; decide it on purpose.(訳:「AIによる承認可」は今や設定項目であり、意図して決めるべきものだ) | その設定を誰が管理しているか、どこまでが許容範囲(envelope)かを、誰かがデフォルトで有効化する前に確認せよ。 |
| 投資家 | 資金はコード生成から「変更のガバナンス」へと移った。 | チームに「意図的にゲートを赤にする」デモを見せてもらえ。そうできるチームはプロセスを持っている。 |
パターン・アンチパターン・第一原理
守られたパターン 設計より先にNと日付付きの数値を出す。スクリプトで決定できることだけを機械層が判断し、すべてを決定する。ゲートの結果はレビュアーのブリーフに逐語的に添付。閾値はデータファイルで管理。すべてのゲートにセルフテストを持たせる。
研究で特定されたアンチパターン 洪水の「体感」に頼る(ランダム化試験の20%錯覚)。確率的レビュアーをマージ条件にする。誰も検証しないプロベナンス慣習に依存する。大きなエージェントPRを人間PRと同様に扱う。誤検知で鳴るアラームが切られる。
第一原理を一文で 誰か・何かが変更を判断する前に、意見を持たない機械がその重みを測り、その機械が「ノー」と言える状態でなければならない。
現実ミッション
エピソード2が公開されるまでに、事例リポジトリでは57時間放置された3件のPRに対し、新しい応答時間ボットが初めて稼働し、付与したラベルがドシエに記録されているはずだ。もしラベルが付かなければ、そのこともエピソード2で報告する。
次に読む
ANDON · エージェント型PRレビューとCI/CD 第1話ANDON · エージェント型PRレビューとCI/CD。各数値はその場でスコープが明示されている。キッチンはあくまでモデルであり、実測値ではない。ここで述べるゲートや仕様、テストはすべてプライベートリポジトリに実装されており、その構造は契約部分で再現しているため、リポジトリへのアクセス有無に依存しない。このエピソードが参照する四つの時間軸の調査記録は、ポートフォリオのplansディレクトリに記録してある。
参考文献
- GitHub, How pull request limits are cutting down the noise, 2026-06-18. github.blog
- GitHub, Octoverse 2025, 2025-10-28. github.blog
- Stripe, Minions: Stripeのワンショット型エンドツーエンドコーディングエージェント, 2026-02-09. stripe.dev
- He, Agarwal, Denisov-Blanch, Azaletskiy, Koyejo, Vasilescu, AI Writes Faster Than Humans Can Review: A Longitudinal Study of an Enterprise 2x Mandate、arXiv:2607.01904, 2026-07-02.arxiv.org — レビューカバレッジの数値はこの研究自身のものであり、対応するMicrosoftの研究は[5].
- Murphy-Hill、Butler、Savelieva、コマンドラインAIコーディングエージェントの導入とその影響、arXiv:2607.01418、2026-07-01。arxiv.org
- METR、2025年初頭AIが経験豊富なオープンソース開発者の生産性に与える影響の測定, 2025-07-10. metr.org
- METR、開発者生産性実験デザインの変更について, 2026-02-24. metr.org
- Robbes、Matricon、Degueule、Hora、Zacchiroli、どれだけエージェント型か?GitHubにおけるコーディングエージェントの普及、arXiv:2601.18341、2026-01-26。arxiv.org
- Pinna、Gong、Williams、Sarro、AIコーディングエージェントの比較:タスク層別で見るPR受理率分析、arXiv:2602.08915、2026-02-09。arxiv.org
- Gong、Pinna、Bian、Zhang、エージェント作成PRにおけるメッセージとコードの不一致分析、arXiv:2601.04886、2026-01-08。arxiv.org
- Xu、Subramanian、Karthik、AI Agent PRs on GitHub: Frequency, Structure, and Merge Conflict Rates(arXiv:2607.04697、2026-07-06)arxiv.org
- Mergifyマージキューの現状 2026, 2026-07-27. mergify.com
- CodeRabbitCodeRabbit、オープンソースに1,000万ドル超を投資, 2026-08-26. coderabbit.ai
- Daniel StenbergDeath by a thousand slops, 2025-07-14. daniel.haxx.se
- Daniel Stenbergcurlバグバウンティ終了, 2026-01-26. daniel.haxx.se
- GitHub ChangelogCopilotコードレビューがプルリクエスト承認に対応, 2026-09-01. github.blog
- GitHub ChangelogCopilotコードレビュー:解決理由と機能拡張, 2026-08-27. github.blog
- GitHub ChangelogGitHub Copilot 週間リリース(8月31日号), 2026-09-04. github.blog
- Microsoft, Visual Studio Code 1.136, 2026-09-02. code.visualstudio.com
- Cursor, Cloud Agents and Cursor Harness Improvements, 2026-08-19. cursor.com
- GitHub Docs, Copilot code review(コンセプト)docs.github.com
- GitHub Changelog, GitHub Copilotのポリシーと課金に関する今後の変更, 2026-08-28. github.blog
- Anthropic, Code Review、Claude Codeドキュメント。code.claude.com
- Hora、Robbes、Zacchiroli、“We Permit the Use of AI, but […]”: 人気オープンソースプロジェクトにおけるAIポリシーの現状、arXiv:2609.07542、2026-09-07。arxiv.org
- The Register, Debian、AIによるコーディングをコントリビューターに認めると決定, 2026-08-30. theregister.com
- LWN.net, GCC運営委員会、AI方針を発表, 2026-07-29. lwn.net
- Linuxカーネルドキュメント, Linuxカーネル開発におけるAIコーディングアシスタントの利用. docs.kernel.org
- SiliconANGLE, CodeRabbitが1億4300万ドルを調達、企業のAI生成コード急増への対応を支援, 2026-08-12. siliconangle.com
- Qodo, 最新情報(リリース2.8[2026-08-16]・2.9[2026-09-07])docs.qodo.ai
- Mergify, 更新履歴(2026-08-12〜2026-09-08のエントリ)docs.mergify.com
- Zengら, SWR-Bench: 実環境でのコードレビューコメント生成におけるLLM性能評価(arXiv:2509.01494)arxiv.org
- Sunら, BitsAI-CR: 実務でのLLMによる自動コードレビュー(arXiv:2501.15134, 2025-01-25)arxiv.org
- Raber, Malone, Gordon, Cooper, 保守的イノベーターと軍用小火器――スプリングフィールド造兵廠の産業史(1794–1968)、米国国立公園局、1989/2006年、p. 138。npshistory.com
- Bacchelli, Bird, 現代コードレビュー――期待・成果・課題、ICSE 2013、著者版。sback.it
- Western Electric規則、『Statistical Quality Control Handbook, 1956. 』を引用(二次資料。1956年版ハンドブック自体は未取得)
- Toyota Motor Corporation, トヨタ生産方式. global.toyota
- Toyota UK, TMUKの25のオブジェクト――アンドンコード, 2017-12-11. mag.toyota.co.uk
- Roser, 互換部品230年史――簡潔な歴史、AllAboutLean、2015-07-08。allaboutlean.com
- Sadowski, Söderberg, Church, Sipko, Bacchelli, Modern Code Review: A Case Study at Google(ICSE-SEIP 2018、著者版)sback.it
- McIntosh、Kamei、Adams、Hassan、コードレビューのカバレッジと参加がソフトウェア品質に及ぼす影響(MSR 2014)rebels.cs.uwaterloo.ca
- Micco、Googleにおける継続的インテグレーションテストの現状(ICST 2017 基調講演)aster.or.jp
- Google Security Blog、SLSAの紹介:サプライチェーン完全性のためのエンドツーエンド・フレームワーク, 2021-06-16. security.googleblog.com
- Harvard Gazette、外科手術の安全チェックリストで死亡率と合併症が3分の1以上減少(2009年1月、Haynesら、NEJM 360:491-9の報告)news.harvard.edu
- Beck、エクストリーム・プログラミング実践記:変化を受け入れよ(Addison-Wesley、1999年、書誌情報)books.google.com
- Fowler、継続的インテグレーション、2000年、2006年、2024年改訂。martinfowler.com
- Wilson、Rustインフラはあなたのインフラにもなる, 2015-03-17. huonw.github.io
- GitHub Changelog、プルリクエストのマージキューが正式リリース, 2023-07-12. github.blog
- Cognition、Devinの紹介, 2024-03-12. cognition.com
- GitHub Changelog、GitHub Copilotコーディングエージェントがパブリックプレビューに登場, 2025-05-19. github.blog
- Best、Neuhauser、Walter A Shewhart、1924年とホーソン工場、Quality & Safety in Health Care、2006年。pmc.ncbi.nlm.nih.gov