AI 原生系列 · ANDON · 智能体化 PR 审查与 CI/CD · 第 1/5 集
PR 洪水是量出来的,不是凭感觉
智能体化 PR 审查与 CI/CD,第一集。自 coding agent 出现后,GitHub 上合并的 pull request 数量已翻了三倍多;在唯一一家自我量化的企业里,人类审查成了瓶颈;而就在本月,AI 被允许计入必需批准人。本集用数据、样本量和时间点量化这场洪水,梳理过去三十天的关键变化,并用连问五次“为什么”解释,为什么机器闸门必须排在任何审查者(无论人还是模型)之前。
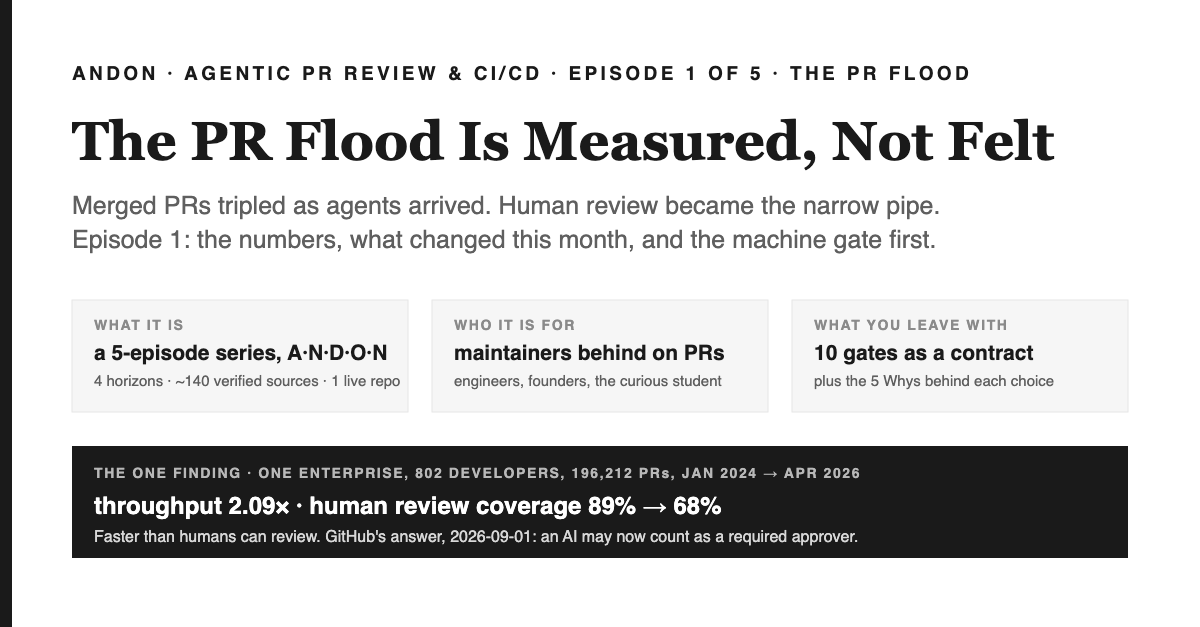
1 分钟速览 —— 你将获得什么
这是什么。 ANDON 第一集,ANDON,一套五集的智能体化 PR 审查与 CI/CD 系列,基于四重时间视角(30 天、30 个月、30 年、300 年)调研后撰写,并在真实仓库中实际构建闸门。本集聚焦 PR 洪水本身:有多大、在哪里被量化、过去一个月发生了哪些变化,以及为何第一道闸门必须是没有主观判断的机器。PR洪水 本身:到底有多大、在哪些地方被量化、过去一个月发生了哪些变化,以及为什么第一个闸门必须是一个没有主观判断的机器。
为什么这事重要。 对工程师来说:瓶颈已经从写代码转向了评判代码,而现在负责评判的工具也被允许按下 merge 按钮。对创始人来说:评审产能决定了你能放出多少 agent,这个数字你只需五分钟就能从自己的仓库里查到。对学生来说:这就是“约束转移”在数据里的样子,而最早的答案是一对 1821 年的铁质塞规。
读完你能做什么。 用三条命令量化你自己的洪水,看看十个机器闸门里还缺哪几个,然后用下方的 30 分钟合约把它们装上。再读第 2 到第 5 集,了解让 AI 评审员值得信任的四条规则:永不沉默、规则以数据形式存储、只在限定路径范围内、必须有负面测试。
ANDON — 系列脉络
- A · 评估——PR 洪水是量出来的,不是凭感觉 本集
- N·永不沉默——给仓库装上 Jidoka 第 2 集
- D · Data, not prose——不会漂移的规则 第 3 集
- O · Only in the envelope——爆炸半径是一份路径清单 第 4 集
- N · 负向测试 —— 闸门必须先报红,才能上线 第 5 集
本系列讲什么,以及为什么 PR 洪水是第 1 集
agent 会打开 pull request,数量极多。一个原本每周只有几个人类 PR 的仓库,现在每周能收到 Copilot 的 coding agent、Codex、Claude Code、Cursor 和 Devin 发来的几十个 PR,每个都彬彬有礼、看起来靠谱,只等人来点头。这一系列讲的是这些 PR 和主分支之间的那些环节:机器闸门、AI 评审员、merge queue,以及唯一应该保留给人的那个决策。写给进度落后的维护者、决定自动化什么的工程师、决定信任什么的创始人,以及想在真实数据里看到约束转移的学生。
系列名来自丰田的安灯拉绳。在丰田产线,任何工人都可以拉安灯绳让生产停下来,只要有问题,而且这根绳子之所以被信任,就是因为它经常被拉。ANDON 这五个字母分别代表五条规则,每条一集,都已在我参与共建的一个私有制造业质量管理仓库中实际落地,这些闸门就是本系列研究时安装进去的:A先用数据量化洪水,再选择闸门;N永不沉默,无法运行的闸门必须在 PR 上明确说明;D规则以数据形式存储,集中在一个文件里并做漂移检查;OAI 只能在预设路径包络内触发合并;N负面测试:在信任绿灯之前,必须先主动触发一次红灯。
之所以把洪水作为第 1 集,是因为后续所有决策都依赖于它的规模。为每周 5 个 PR 设计的闸门,和为每周 50 个 PR 设计的,完全是两种东西。研究还给出了一个具体理由,提醒我们不要轻信直觉:在案头唯一一项针对有经验开发者的 AI 编码工具随机对照试验中,参与者自认为工具让他们快了约 20%,实际测量却慢了 19%。主观感受不是数据。因此本集先讲数字,明确样本量和时间点,再说那 30 天如何改变了 merge 按钮,然后是一张贯穿全系列的图,接着是实际案例,最后用连问五次“为什么”解释为什么机器闸门必须优先设置。
洪水有多大:关键数据
存在三类数据,而且它们彼此并不一致,这本身就是一个重要发现。平台统计、企业内部实地研究和受控实验,各自衡量的维度不同,因此表格中特别注明了各自的适用范围。
| 测量项 | 数值 | 范围与时间 |
|---|---|---|
| GitHub 每月合并的 pull request 数 | ~25M → >90M(3.6 倍) | 平台整体,2023 年 1 月至 2026 年年中,GitHub 官方博客,2026-06-18 [1] |
| 一年内合并的 pull request 数 | 518.7M (+29%) | Octoverse 2025,2025-10-28;仅 Copilot coding agent 在前五个月就发起了 100 万个 PR [2] |
| 某公司每周合并的全 agent 编写 PR 数 | >1,000 | Stripe,2026-02-09;人工审核,"no human-written code"(中译:无人工编写代码)[3] |
| “2×” 指标下的人均吞吐量 | 2.09× | 同一企业,802 名开发者,196,212 个 PR,2024 年 1 月至 2026 年 4 月 [4] |
| 同一研究中,至少有一次人工审核的 PR 占比 | 89% → 68% | 同一企业;同期 AI 审查覆盖率从约 19% 升至 84% [4] |
| 采用 CLI coding agent 后的人均合并 PR 数 | +24% | 数万名微软工程师,观察性数据,2026-07-01 [5] |
| 用 AI 工具完成任务所需时间(随机对照试验) | −19%(更慢);开发者自认为约 +20% | 16 位有经验的开源开发者,246 个任务,2025 年初;2026 年 2 月复测新手为 −4%,区间很宽,作者因选择效应调整了实验设计 [6, 7] |
| 检测到 coding agent 痕迹的项目 | 22–29% | 128,018 个 GitHub 项目,2026-01-26 [8] |
| 按 agent 分类的 agent PR 接受率 | 68–80% | 7,156 个 PR:Codex 79.9%,Cursor 74.4%,Claude Code 72.6%,Devin 和 Copilot 68.0%,2026-02-09 [9] |
| 描述与代码不符的 agent PR 占比 | 1.7% 的 PR 存在高度不一致;这类 PR 的合并率为 28.3%,而一致的为 80.0%,且耗时是后者的 3.5 倍 | 23,247 个 agent PR,2026-01-08 [10] |
| 有两个 agent 在同一批重叠 PR 上活跃的仓库 | 40.2%;跨 agent 冲突率为 41.7%,单一 agent 内为 19.8% | 33,596 个 agent PR,2,807 个仓库,2026-07-06 [11] |
| 主分支损坏率:AI 辅助与非 AI 辅助对比 | 1.9% vs 4.4% | 200,000+ 次合并,477 个组织启用 merge queue,2026-07-27;94% 的队列每次只处理一个 PR [12] |
这张表更像是趋势概貌,而不是定论。平台整体的合并量三年间翻了三倍,那家认真自测的企业内部也翻了一倍。与此同时,该企业人类实际审查的占比下降了五分之一,而模型审查的占比则从五分之一跃升至大多数。agent PR 按 agent 和任务分层后,接受率大致与人类持平,但失败的 PR 往往更大、涉及文件更多、CI 挂掉,或者描述和 diff 不符。至于这些变化是否让个人开发者更快,受控实验的证据依然扑朔迷离:随机对照试验反而测出变慢,作者后来也承认,设计无法应对开发者拒绝不用 AI 的分组。
企业级的数据才是维护者切身能感受到的。CodeRabbit 在 2026-08-26 宣布为开源仓库提供一千万美元免费审查时,用一句话点明了现状:
"AI has completely collapsed the cost of producing a contribution, shifting the great bottleneck of software development from generating code, to judging it."(中译:AI 已经将产出贡献的成本彻底压缩,软件开发的最大瓶颈从写代码转移到了评判代码上。)
—— CodeRabbit,2026-08-26 [13]
curl 的维护者从接收端同样观测到了这一现象:2025 年的安全漏洞提交中,约 20% 是 AI 生成的低质量内容,只有约 5% 属于有效报告。2026 年 1 月,该项目在有效报告率跌破 5% 后,终止了漏洞赏金计划 [14, 15].
过去三十天发生了什么
研究窗口截止于 2026-09-09,而前一个月,merge 按钮本身迎来了变革。
- 2026-09-01:AI 可以被计为必需批准人。GitHub 的 Copilot 代码审查现在可以提交一个满足仓库必需批准规则的同意评审。该功能默认关闭,可在企业、组织或仓库级别配置,且像人类一样,新的 push 会撤销已同意的审批。GitHub 官方措辞依然保留了区分:"An approval assessment alone does not count toward merge requirements."(中译:仅有同意评估本身,并不计入合并要求。) [16] 五天前,Copilot 已经开始审查 bot-authored PR,并取消了 300 文件的上限 [17].
- 2026-09-02:发起 PR 的 agent 现在可以自己完成合并。Agent Merge 正在公测,将会“address review feedback, fix failed checks and merge conflicts, and rerun workflows”直到 PR 可合并(中译:处理评审反馈、修复失败的检查和合并冲突,并重新运行工作流,直到 PR 能被合并)[18, 19。Cursor 在 2026-08-19 推出了类似功能:cloud agents “automatically subscribe to PRs they create and drive them to completion, fixing CI and addressing bot comments”(中译:自动订阅自己创建的 PR,并推动其完成,修复 CI 并处理 bot 评论)[20].
- 现在,评审的价格直接体现在标签上。Copilot 的评审在“Lite”模式下每次大约消耗 $0.05 到 $1 的 AI 积分,“Balanced”模式下为 $0.25 到 $5;2026-09-28 起默认切换为 Balanced [21, 22。Anthropic 的托管 Code Review 平均每次 $15 到 $25,耗时约二十分钟,并且有意只报告中性检查而非阻塞性检查 [23].
- 首份开源 AI 政策调研。在前 2,000 个 GitHub 热门仓库的 281 份政策中,83.3% 允许或鼓励 AI 参与贡献,14.9% 明确禁止,48.8% 要求披露,67.3% 要求高比例的人类参与(arXiv, 2026-09-07)[24。Debian 于 2026-08-30 投票通过宽松方案;GCC 拒绝“legally significant” LLM 衍生代码,政策将门槛大致设在十五行;Linux kernel 接受
Assisted-by:trailer,但坚持只有人类可以 sign off [25, 26, 27]. - 资本流向了变更管理,而不是代码生成。CodeRabbit 于 2026-08-12 以 15 亿美元估值融资 1.43 亿美元,专注于“Agentic Change Management”;Qodo 2.8 和 2.9(2026-08-16、2026-09-07)将评审、规则和问题解决都集成进了 Claude Code、Codex 和 Kiro,每个 PR 都有“blast radius”风险分级;Mergify 在 2026 年 8 月的 changelog 中为堆叠 PR 增加了 merge-queue 支持 [28, 29, 30].
综合来看:写代码的工具现在可以评审、批准、修复检查并完成合并,是否允许完全取决于仓库设置。这让设置本身成为设计,后面四集讲的就是这个。
一图串联五集:厨房的三道关
一道菜要从正规的厨房端出,必须经过三道关,这三关不是谁更严格,而是性质不同。第一关是秤、温度计和点单核查:它们没有主观判断,重量不达标,不管谁做的都不能出。第二关,副厨尝一口,写下备注:“第三勺盐偏重,是否出菜由你决定”,备注明确指出是哪一勺。第三关,主厨看备注、尝那一口,决定是否放行。冷前菜只要副厨尝过就能上桌,调料错了重做即可,无需退款;热菜则必须等主厨最终确认。
| 厨房 | 代码仓库 | 本集 |
|---|---|---|
| 秤:无主观判断,重量不达标绝不放行 | 机器闸门 G1 到 G10:每条写入路径都要有租户过滤和权限校验,无秘密结构,模型变更必须配套迁移,每个 id 列都是外键,双语文档同步,测试、黄金用例、溯源、规模,每个 gate 都必须能变红 | 第 1 集和第 5 集 |
| 厨房自带的停工机制:弹簧断了搅拌机自动停,厨师会说“秤坏了”而不是凭猜测操作 | 无法运行的 gate 或 reviewer 会在 PR 上贴“unmeasured”;响应时间 bot 不依赖任何人记得去看 | 2 |
| 所有人都能统一解读的菜谱卡 | 规则集中以数据形式存储于单一文件,自动生成文档和评审提示,并在 CI 中做防漂移校验 | 3 |
| 冷菜经副厨品尝即可出餐,无需主厨终审;热菜则必须主厨亲自把关 | AI 只能在其未自行选择的路径范围内触发合并,且仅作为五个条件之一;应用代码、数据库迁移和 CI 永远不在此范围内 | 4 |
| 上菜前用已知重量校准秤,确保读数准确无误 | 每道闸门都内置自测,能在植入缺陷时失败;只有在已知有缺陷的 PR 上成功变红,评审才算真正生效 | 5 |
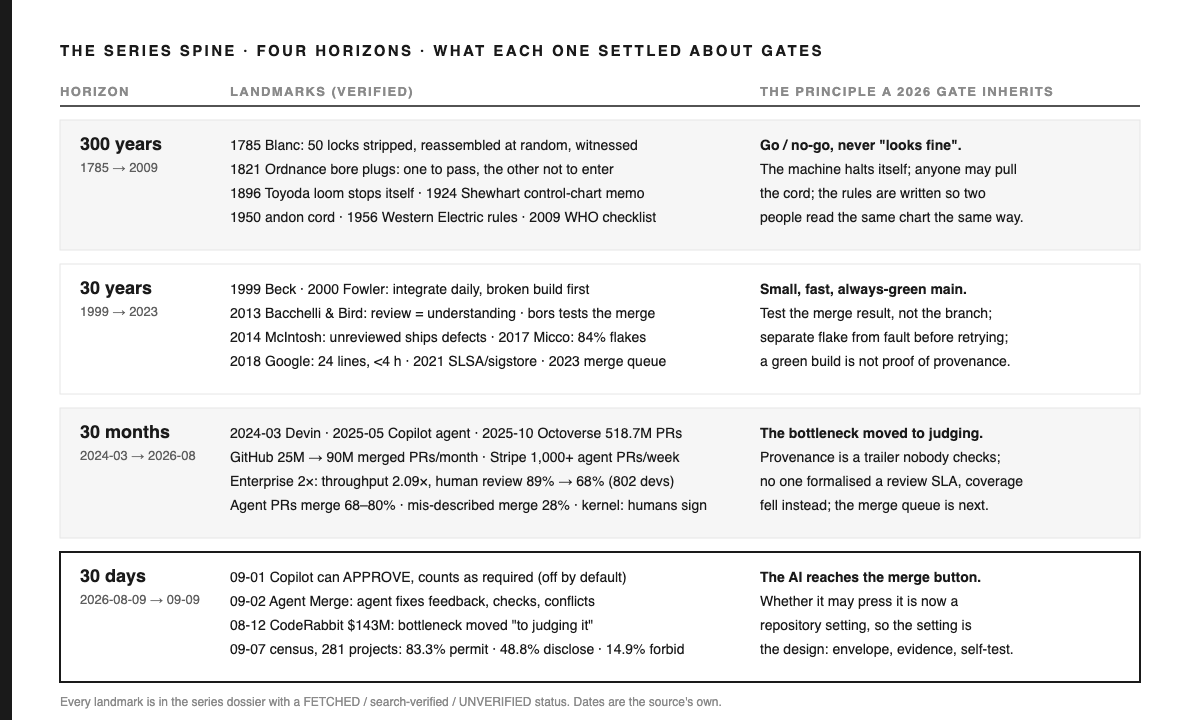
此处列出旧的里程碑,是为了确保图表所述与正文完全一致。Blanc 于 1785 年当众拆解并随机重组了五十把燧发枪锁,全部重新组装成功 [38]。Google 2018 年对约九百万次评审变更的研究发现,中位修改 24 行代码,完整评审的中位等待时间不到四小时 [39]。McIntosh 等人在 2014 年发现,评审覆盖率和参与度低会导致每个组件多出 2 到 5 个发布后缺陷 [40]。Micco 2017 年报告,Google 84% 的通过转失败都源于不稳定测试 [41]。SLSA 和 sigstore 于 2021 年作为对 SolarWinds 事件的应对而诞生 [42]。世卫组织 2009 年的手术清单试验将八家医院的死亡率从 1.5% 降至 0.8% [43]。图中剩余的里程碑:Beck 于 1999 年提出持续集成作为极限编程实践,Fowler 于 2000 年给出权威定义,规则是“没有人有比修复构建更优先的任务” [44, 45]; Rust 项目的 bors bot 自 2013 年起测试的是合并结果而非分支,GitHub 于 2023 年 7 月将 merge queue 升级为一等功能 [46, 47]; Devin 于 2024 年 3 月发布,GitHub 的 Copilot coding agent 于 2025 年 5 月进入公开预览 [48, 49]; Shewhart 提出控制图的备忘录日期为 1924 年 5 月 16 日 [50]。每个里程碑都会在其所属的集数中重现。
实战案例:2026-09-09 的一个仓库
该仓库是一套工厂用的质量管理系统,每一条记录都可能在客户审计中被抽查为证据,合并缺陷意味着伪造记录而非普通 bug。维护者只有两人:一位领域联合创始人和我本人,我的大部分贡献都是由我主导的 AI 会话生成。本集研究结束那天早上,我用任何人都能运行的三条命令读出了仓库的数据,发现它们的分布与文献一致,只是规模缩小了十分之一。
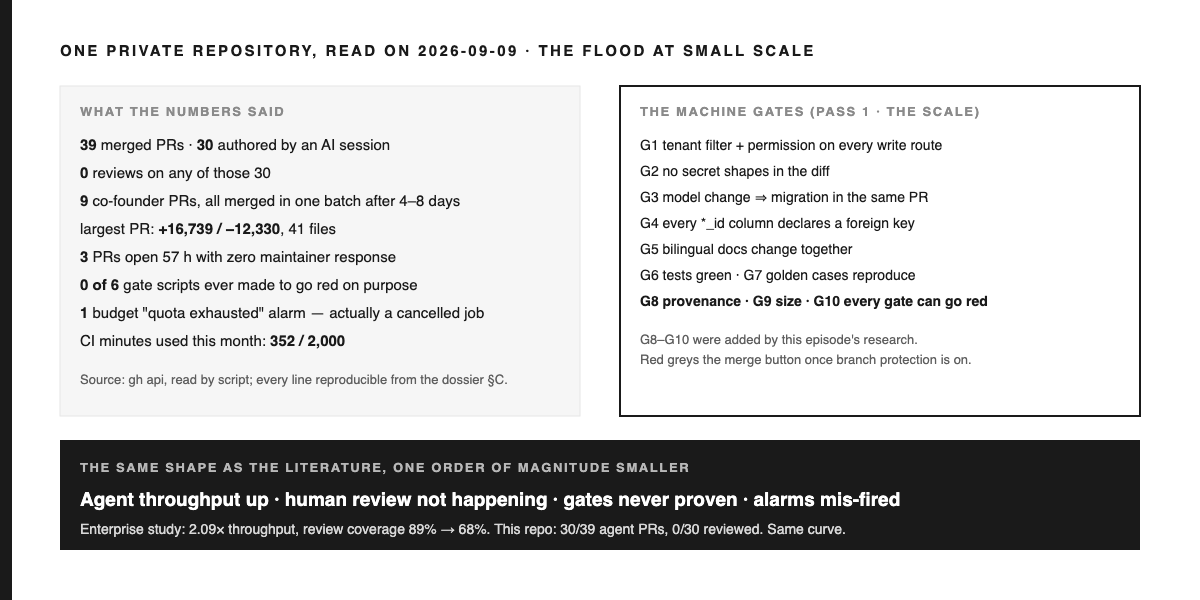
本系列背后的资料库收录了约 140 个来源,每条都标注了“已获取”“检索验证”或“未验证”。该仓库当天的数据:39 个合并 PR,最大的是一次 UI 重构,涉及 41 个文件,+16,739 行、-12,330 行;本月 2,000 CI 分钟已用 352。39 个合并 PR 中有 30 个由 AI 会话生成,且这 30 个都没有评审,因为唯一能评审的人就是指导 agent 的那位。联合创始人的 9 个 PR 等了 4 到 8 天,最后在同一天下午合并。他新开的 3 个 PR 已经挂了 57 小时,没人响应。6 个 gate 脚本都从未被故意触发失败;第七道 gate 是测试套件本身,不是脚本。监控 CI 分钟预算的脚本曾对一个作业发出“配额耗尽”警报,结果只是并发取消,警报时点距作业仅 9 秒。
最后这句话值得记住。误报的检测器比没有还糟,因为下次警报会被忽略,而这个仓库已经在 8 月下旬(2026-08-21 至 08-30,日志自证共 11 天)因 Actions 分钟耗尽导致 CI 默默挂死,没人关注警报,损失了大半个月。第 5 集专讲这事,第 2 集讲那 57 小时。本集关注图右侧的 7 道 gate,研究又新增了 3 道:一是 provenance gate,因为文献显示私有合并仅 14.4% 带 AI 标记,而仓库只靠没人查的约定;二是 size gate,给 agent 辅助 PR 设下限,因为失败的往往是大 PR;三是自测合约,因为 6 个 gate 脚本从未变红。
连问五次“为什么”:为何机器闸门必须优先设置
本系列的特色,是同一个问题连问五遍,直到答案从个人偏好变成机制。以下是第 1 集的五问:为什么第一道把关必须是没有主观意见的机器,而不是任何评审。
| # | 为什么? | 原因 | 证据 |
|---|---|---|---|
| 1 | 为什么不能让 AI 审查员直接作为闸门? | 因为模型对 diff 的判断本质上是概率性的,而一旦合并条件可以被争论,贡献者就会去争论。秤不会和你讨价还价。 | 自动化审查工具在真实 PR 上“表现不佳”,更擅长发现功能性错误而非设计问题;某工业级审查工具有 26.7% 的评论在合并时已过时 [31, 32] |
| 2 | 为什么机器闸门必须专门覆盖租户隔离、密钥、迁移和外键? | 因为这些失误会在质量系统中导致虚假记录,而虚假记录是审计中唯一无法被原谅的缺陷。这些问题也完全可以用脚本判定。 | 仓库自己的规则,以及 1821 年的经典案例:通孔塞要么合格,要么不合格 [33] |
| 3 | 为什么闸门的结果要原样附在 AI 摘要里,而不是再判一遍? | 因为对已定结论的重复判断就是噪音,而噪音正是让人不再读摘要的原因。人类审查员的注意力应该花在理解上,而不是重复“称重”。 | Bacchelli 和 Bird,ICSE 2013:评审“比预期更少关注缺陷”,更多关注理解 [34] |
| 4 | 为什么规则必须以数据形式写下来? | 因为如果没有以数据形式明确记录,两个审查员看同一张表也会得出不同结论——这正是 Western Electric 在 1956 年通过发布运行规则解决的问题。 | Western Electric rules: "to ensure that line workers and engineers interpret control charts in a uniform way"(中译:确保一线工人与工程师对控制图的解读一致) [35]; 详见第 3 集 |
| 5 | 为什么闸门必须被故意触发一次失败才算生效? | 因为一个从没变红的闸门和一个只会亮绿灯的装饰品没区别,而这个仓库一个月内就有三个这样的例子:一个没装就静默跳过的 linter,一个文档里写着存在但实际不存在的 PR 模板机器人,以及 8 月底那几天静默挂掉的 CI。织机之所以值得信任,是因为它真的会停下来。 | 丰田官方对 1896 年纬纱断线停工和 1950 年 andon 绳的记载 [36, 37]; 详见第 5 集 |
核心观点,简而言之:合并条件必须是无法被争论的,这就意味着交给机器执行,意味着规则必须写下来,并且机器必须有权说“不”。AI 审查员能做的所有增量,都只能建立在这个基础之上,绝不能取而代之。
30 分钟实操:把机器闸门层落成一份契约
三十分钟,是这份契约为读者在新仓库中完整复制一遍所预设的时间预算;并非我实际测量所得。实际案例中的七道原始闸门(六个脚本加测试套件)分几次完成;新增的三道闸门连同调研共用了一天。
| 要素 | 规范说明 |
|---|---|
| 先做测量 | 三条命令,五分钟内完成:列出已合并 PR 的作者、合并者、规模和评审次数;列出未合并 PR 的存续时长和标签;列出最近六十次 CI 运行及其结论。在调整任何闸门前,先把这些数字和日期记录下来。 |
| 输入项 | 与 merge base 的 diff;变更文件列表;提交信息(用于 trailers);PR 正文(用于粘贴证据)。 |
| 基础七道闸门 | G1 每条写入路径都需有租户过滤和权限校验(AST 级别,不是 grep);G2 新增行不得包含任何秘密结构,需报告位置但绝不显示值;G3 若模型变更但同一 PR 内无迁移脚本则直接阻断;G4 每个*_id列都需声明外键或给出合理豁免理由;G5 双语文档需同步变更;G6 测试套件;G7 黄金用例库,所有确定性函数必须能复现标准输出。 |
| 洪水新增三道闸门 | G8 provenance:带 AI 协作者标记的提交必须同时携带会话或工具的溯源信息,bot 永远不能 sign off,agent 协助的 PR 必须粘贴其验证输出;G9 size:有效行数超过数据驱动阈值直接阻断,agent 协助 PR 有更低下限,lockfiles 不计入;G10 自测:每道闸门都需暴露一个能在植入缺陷时失败的标志,runner 检查到任何闸门缺失此标志就让 CI 失败。 |
| 不变式 | 闸门变红时,分支保护下 merge 按钮会被禁用。任何闸门都不得静默跳过:缺工具、缺密钥或异常都算红灯,绝不算绿灯。 |
| 停止规则 | 每次 push 跑一遍所有闸门。闸门内部不重试;不稳定的结果视为闸门自身缺陷,需修复,而不是循环重试的理由。 |
| 阈值数据化 | 一个 JSON 文件:400 行预警,3,000 行阻断,agent 协助 1,500 行阻断,60 个文件阻断。更改阈值即为一次 PR。 |
| 有意留白 | 本层完全不涉及 AI。尚无不稳定测试的隔离区。merge queue 需等方案支持分支保护后再上。每项都是后续章节或方案决策,不是契约的缺口。 |
# Measure first (five minutes, any repo)
gh pr list --state merged --limit 100 --json number,author,mergedBy,additions,deletions,changedFiles,reviews
gh pr list --state open   --json number,createdAt,author,labels,reviews
gh run list --limit 60    --json conclusion,createdAt,updatedAt

# Then the gate layer, one command locally == CI
make gate    # lint · tenant-perm · graph · pr-ready(P1..P6) · selftest · migration · tests · eval
同一故事,五种视角
| 读者 | 唯一决策 | 唯一行动 |
|---|---|---|
| 学生 | 瓶颈已从写代码转向评判代码;学会如何判断。 | 每天在一个公开仓库里阅读一条 agent PR,在查看评审前,先写下你认为它是否应该合并,以及理由。 |
| 工程师 | 先用数据量化洪水,再决定要加哪道闸门。 | 今天就在你的仓库里运行上面那三个命令,把结果写进 README。 |
| 创始人 | 决定你能放多少 agent 的不是模型质量,而是评审产能。 | 问问上个月合并的 PR 里,有多少比例经过了人工评审,这个数字的变化趋势是否符合企业目标? |
| 高管 | “An AI may approve” is now a setting; decide it on purpose.(中译:“AI 可以批准”现在是一个设置项;请有意识地做出决策。) | 在有人默认开启之前,先问清楚谁负责这个设置,以及 envelope 的范围是什么。 |
| 投资人 | 资金已经流向了变更管理,而不是代码生成。 | 让团队演示一道闸门如何故意变红;能做到这点的,才说明有流程。 |
模式、反模式与第一性原理
可行的模式。 设计前先有样本量和日期。机器层只做脚本能决定的事,且全部覆盖。闸门结果原样附在评审摘要里。阈值存于数据文件。每道闸门都带自检。
研究指出的反模式。 靠主观感觉判断洪水(随机对照实验的 20% 错觉)。让概率性评审者成为合并条件。依赖没人核查的 provenance 约定。把大 agent PR 当成人类大 PR 处理。警报触发在错误指纹上,最后被关闭。
简而言之的第一性原理。 在任何人或任何系统评判变更前,必须有一台没有主观意见的机器先称过分量,而且这台机器必须能说“不”。
实际操作
等到第 2 集发布时,案例仓库会首次用新上线的响应时间 bot 跑那三条 57 小时未响应的 PR,打上的标签会收录进资料库。如果没有打上,第 2 集会如实说明。
延伸阅读
第 1 集 ANDON · 智能体化 PR 审查与 CI/CD。每个数字都在其出现处标明了适用范围;厨房只是一个模型,并非真实数据。文中描述的闸门、规范和测试均存在于一个私有仓库,其结构已在合约中完整复刻,无需访问仓库本身。该集可能引用的四重视角 dossier 已记录于 portfolio 的 plans 目录。
参考文献
- GitHub,How pull request limits are cutting down the noise, 2026-06-18. github.blog
- GitHub,Octoverse 2025, 2025-10-28. github.blog
- Stripe,Minions: Stripe's one-shot, end-to-end coding agents, 2026-02-09. stripe.dev
- He, Agarwal, Denisov-Blanch, Azaletskiy, Koyejo, Vasilescu,AI Writes Faster Than Humans Can Review: A Longitudinal Study of an Enterprise 2x Mandate,arXiv:2607.01904,2026-07-02。arxiv.org—— 审核覆盖率数据为该研究原始结果;微软的配套研究见 [5].
- Murphy-Hill、Butler、Savelieva,Adoption and Impact of Command-Line AI Coding Agents,arXiv:2607.01418,2026-07-01。arxiv.org
- METR,Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, 2025-07-10. metr.org
- METR,We are Changing our Developer Productivity Experiment Design, 2026-02-24. metr.org
- Robbes、Matricon、Degueule、Hora、Zacchiroli,Agentic Much? Adoption of Coding Agents on GitHub,arXiv:2601.18341,2026-01-26。arxiv.org
- Pinna、Gong、Williams、Sarro,Comparing AI Coding Agents: A Task-Stratified Analysis of PR Acceptance,arXiv:2602.08915,2026-02-09。arxiv.org
- Gong、Pinna、Bian、Zhang,Analyzing Message-Code Inconsistency in Agent-Authored PRs,arXiv:2601.04886,2026-01-08。arxiv.org
- Xu、Subramanian、Karthik,AI Agent PRs on GitHub: Frequency, Structure, and Merge Conflict Rates,arXiv:2607.04697,2026-07-06。arxiv.org
- Mergify,State of Merge Queues 2026, 2026-07-27. mergify.com
- CodeRabbit,CodeRabbit commits more than $10 million to open source, 2026-08-26. coderabbit.ai
- Daniel Stenberg,Death by a thousand slops, 2025-07-14. daniel.haxx.se
- Daniel Stenberg,The end of the curl bug-bounty, 2026-01-26. daniel.haxx.se
- GitHub Changelog,Copilot code review can now approve pull requests, 2026-09-01. github.blog
- GitHub Changelog,Copilot code review: Resolution reasons and expanded capabilities, 2026-08-27. github.blog
- GitHub Changelog,GitHub Copilot weekly releases: August 31, 2026-09-04. github.blog
- Microsoft, Visual Studio Code 1.136, 2026-09-02. code.visualstudio.com
- Cursor, Cloud Agents and Cursor Harness Improvements, 2026-08-19. cursor.com
- GitHub Docs, Copilot code review(概念)。docs.github.com
- GitHub Changelog, Upcoming changes to GitHub Copilot policies and billing, 2026-08-28. github.blog
- Anthropic, Code Review,Claude Code 文档。code.claude.com
- Hora、Robbes、Zacchiroli,“We Permit the Use of AI, but […]”: The Landscape of AI Policies in Popular Open Source Projects,arXiv:2609.07542,2026-09-07。arxiv.org
- The Register,Debian votes to let contributors code with AI, 2026-08-30. theregister.com
- LWN.net,GCC 指导委员会发布 AI 政策, 2026-07-29. lwn.net
- Linux kernel 文档,在 Linux kernel 开发中使用 AI 编码助手. docs.kernel.org
- SiliconANGLE,CodeRabbit 获得 1.43 亿美元融资,助力企业应对 AI 生成代码的激增, 2026-08-12. siliconangle.com
- Qodo,更新内容,2.8(2026-08-16)与 2.9(2026-09-07)版本发布。docs.qodo.ai
- Mergify,Changelog,2026-08-12 至 2026-09-08 条目。docs.mergify.com
- Zeng 等,SWR-Bench:评估 LLM 在真实场景下代码评审评论生成的表现,arXiv:2509.01494。arxiv.org
- Sun 等,BitsAI-CR:LLM 驱动的自动化代码评审实践,arXiv:2501.15134,2025-01-25。arxiv.org
- Raber、Malone、Gordon、Cooper,Conservative Innovators and Military Small Arms: An Industrial History of the Springfield Armory, 1794–1968,U.S. National Park Service,1989/2006,第138页。npshistory.com
- Bacchelli、Bird,Expectations, Outcomes, and Challenges of Modern Code Review,ICSE 2013,作者稿。sback.it
- Western Electric rules, citing theStatistical Quality Control Handbook, 1956. en.wikipedia.org(二手资料;1956年手册原文未获取)
- Toyota Motor Corporation,Toyota Production System. global.toyota
- Toyota UK,TMUK's 25 Objects – Andon Cord, 2017-12-11. mag.toyota.co.uk
- Roser,230 Years of Interchangeable Parts – A Brief History,AllAboutLean,2015-07-08。allaboutlean.com
- Sadowski、Söderberg、Church、Sipko、Bacchelli,现代代码评审:Google 案例分析,ICSE-SEIP 2018,作者自存稿。sback.it
- McIntosh、Kamei、Adams、Hassan,代码评审覆盖率与参与度对软件质量的影响,MSR 2014。rebels.cs.uwaterloo.ca
- Micco,Google 持续集成测试现状,ICST 2017 大会主题演讲。aster.or.jp
- Google Security Blog,SLSA:端到端供应链完整性框架介绍, 2021-06-16. security.googleblog.com
- Harvard Gazette,外科手术安全核查表让死亡率和并发症降低超过三分之一,2009-01,报道 Haynes 等人,NEJM 360:491-9。news.harvard.edu
- Beck,极限编程实践:拥抱变化,Addison-Wesley,1999(目录记录)。books.google.com
- Fowler,持续集成,2000 年,2006 年与 2024 年修订。martinfowler.com
- Wilson,Rust infrastructure can be your infrastructure, 2015-03-17. huonw.github.io
- GitHub Changelog,Pull request merge queue is now generally available, 2023-07-12. github.blog
- Cognition,Introducing Devin, 2024-03-12. cognition.com
- GitHub Changelog,GitHub Copilot coding agent in public preview, 2025-05-19. github.blog
- Best,Neuhauser,Walter A Shewhart, 1924, and the Hawthorne factory,Quality & Safety in Health Care,2006 年。pmc.ncbi.nlm.nih.gov