AI 原生系列 · ANDON · 智能体化 PR 审查与 CI/CD · 第 2 篇 / 共 5 篇
给仓库装上 Jidoka:永不沉默的 PR 闸门
智能体化 PR 审查与 CI/CD,第 2 篇。1896 年,一台织布机学会了在断线时自己停下来。而大多数 CI 流水线从没学会这一课:一个跑不起来的闸门,和一个什么都没发现的闸门看起来一模一样,两者都显示绿色。这一篇是 ANDON 里的那个「N」。它搭建了一个三态而非两态的闸门,一个跑在 GitHub cron 上而不是靠谁去记的响应时钟,然后报告了那一个这套设计没能捕捉到的失败——因为它压根没有声音。
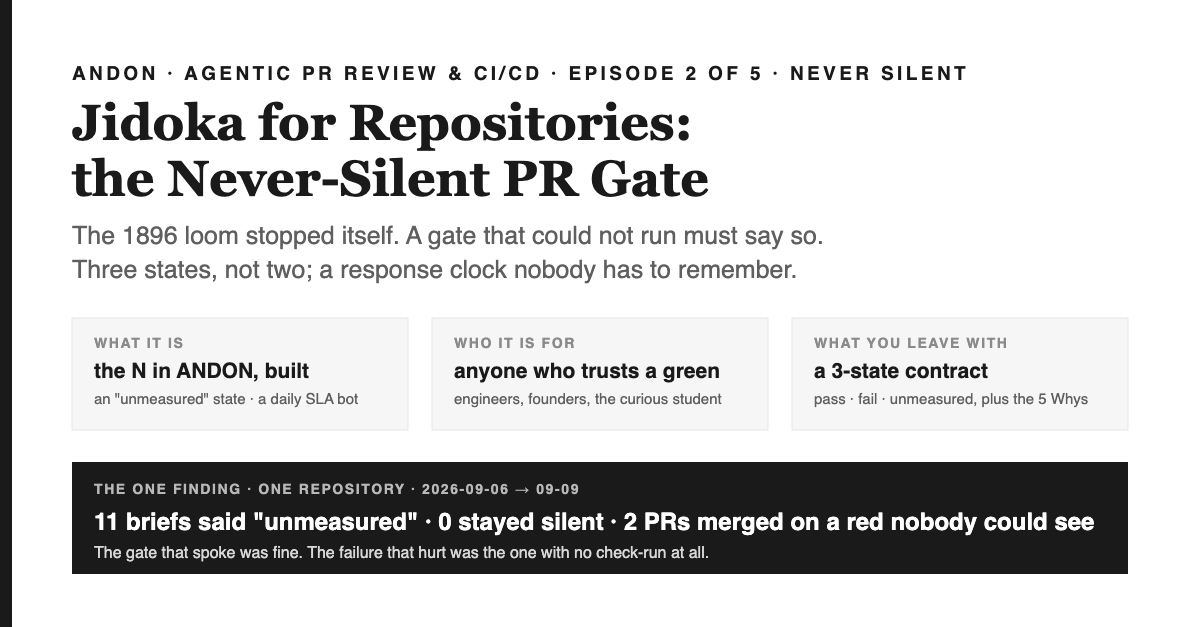
1 分钟速览——读完你能带走什么
这是什么。 ANDON 系列第 2 篇,共 五 篇,主题是智能体化 PR 审查与 CI/CD。这一篇讲的规则是 永不沉默,落地到一个真实仓库中,成为永不沉默的 PR 闸门:一个具备三种状态(通过、失败、以及unmeasured)的 AI 审查者,一个会给拉取请求打标签、每天自动重写一份看板而无需任何人记挂的响应时间机器人,以及对一次「毫无状态可言」的失败的如实报告。
为什么重要。 对工程师而言:两态闸门会以「遗漏」的方式撒谎,因为「跑不起来」在呈现上和「什么都没发现」一模一样,而洪流般的 PR 量让这种遗漏变成家常便饭。对创始人而言:企业数据显示,人工审查覆盖率从 89% 跌到 68%,与此同时吞吐量翻了一番,你正在流失的信号,恰恰就是沉默闸门所掩盖的那种信号。对学生而言:这是质量控制里最古老的理念——一台会自己停下来的机器——被用在了最新的问题上。
读完之后你能做什么。 让每一个自动化判断都拥有三种状态,并且每种状态都要有一份贴出来的输出。把响应时钟架在 GitHub 的 cron 上,配上一份策略文件,再加一个只会被覆写、从不追加的看板。并且采用这一集为之付出代价才换来的合并规则:以工作流运行本身的结论为准合并,绝不看 checks 列表,因为一个没有 check-run 的失败,在那份列表里根本看不见。
ANDON — 系列脉络
- A · 评估——PR 洪水是量出来的,不是凭感觉 第 1 集
- N·永不沉默——给仓库装上 Jidoka 本集
- D · Data, not prose——不会漂移的规则 第 3 集
- O · Only in the envelope——爆炸半径是一份路径清单 第 4 集
- N · 负向测试 —— 闸门必须先报红,才能上线 第 5 集
本集讲了什么,以及为什么「永不沉默的 PR 闸门」排在第二集
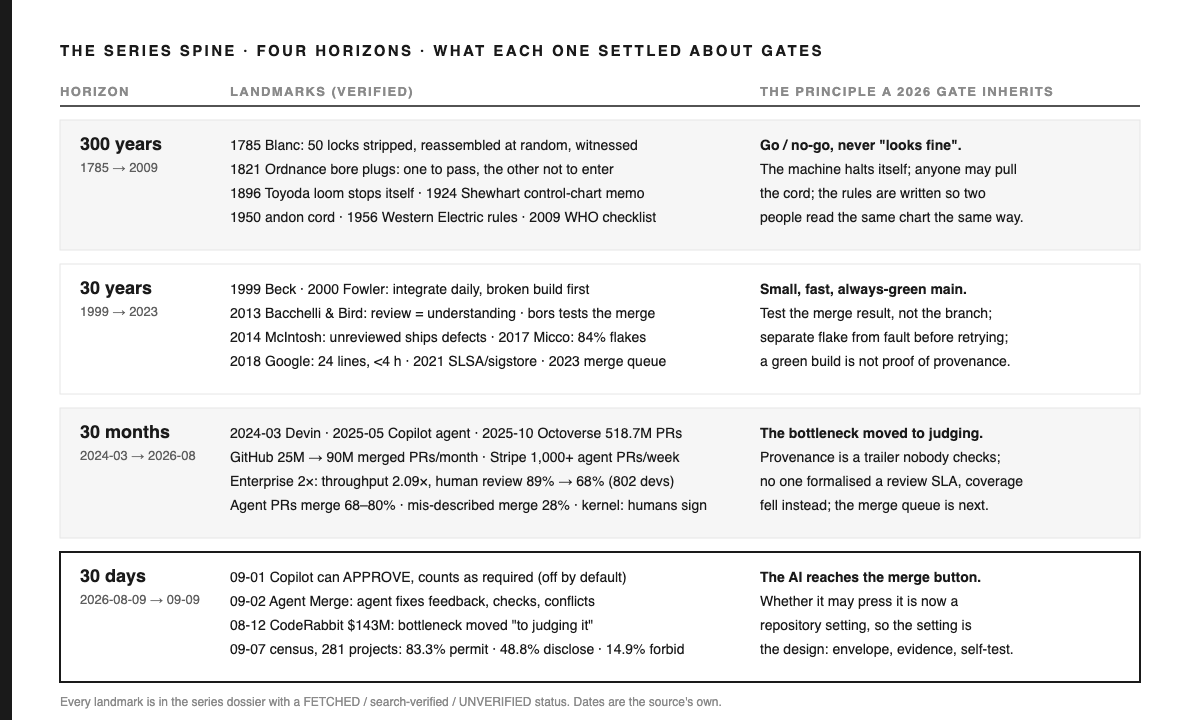
第 1 集测量了这股洪流:从 2023 年 1 月到 2026 年年中,GitHub 上被合并的拉取请求数量增长了两倍还多;在一家对自身进行了测量的企业内部,人均吞吐量达到了基线的 2.09 倍,与此同时,获得人工审查的 PR 占比却从 89% 跌到了 68%[1, 2]。第 1 集以「机器闸门」收尾:一台没有主观意见、只裁决脚本能够裁决之事的秤。这一集要讲的,是这台秤称不出重量时会发生什么。
这种情况并不罕见。AI 审查员需要凭证;凭证会过期、会被粘贴错误、会被轮换。读取 pull request 正文的关卡,在 push 事件里根本拿不到正文。工作流文件可能解析失败。写仪表盘的机器人可能发现仪表盘功能被关掉了。在上述每一种情况下,一个只有两态的关卡——通过或失败——都会默认落到「通过」这一态,因为什么都没跑,自然也就没什么失败。PR 的读者看到的是绿色。文献显示,这个读者正日益成为唯一还会看一眼的人类:一项 2026 年关于人类如何审查 AI 生成的 PR 的研究发现,大多数 PR 得不到任何人类审查,而确实发生的审查里大多数是机器人写的 [3],而一项对 11,048 个 agentic PR 的人工抽查发现,5.5% 的 PR 完全没有可见的交互痕迹 [4].
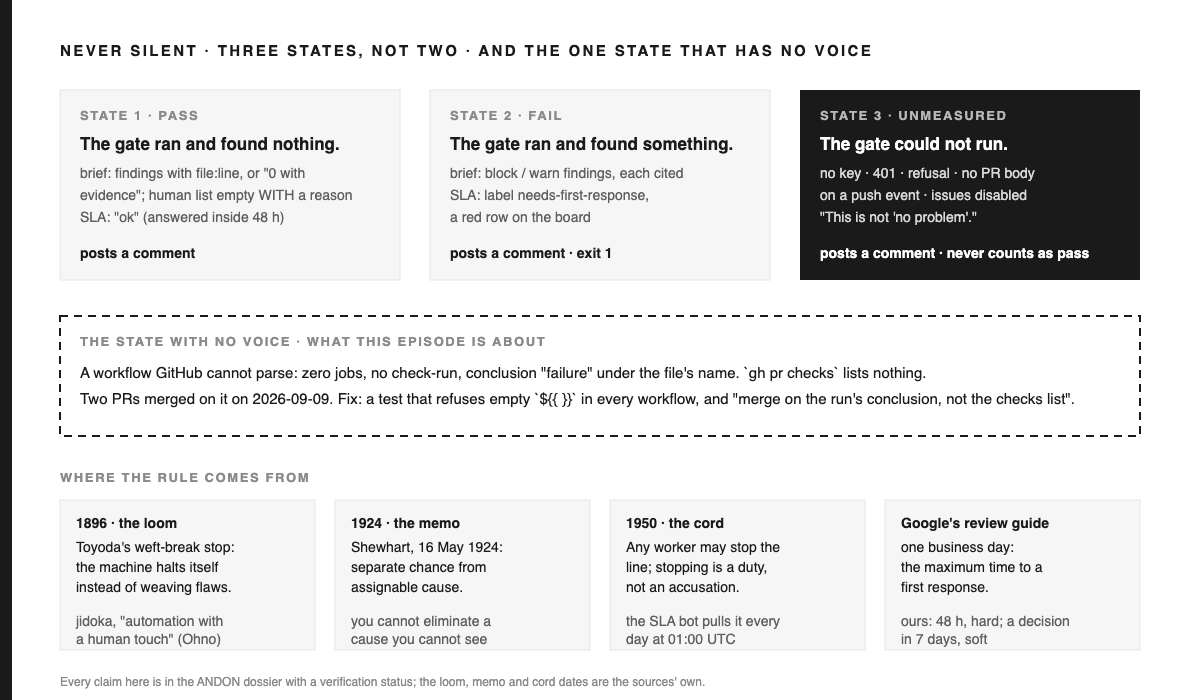
所以这一集的规则很简单:一个关卡要有三种状态,第三种状态会开口说话。本集的实测案例仍是第一集里那个私有质量管理仓库:AI 审查员最初的十一次实际运行全部落在第三态「unmeasured」,一个响应时间机器人第一次投入运行,而就在同一天,有两个 PR 是在一次完全没有产生任何状态的失败上被合并的。结尾的「五个为什么」追问:为什么第三态必须是一条贴出来的评论,而不能是一片空白?答案要追溯到 1896 年的一台织布机。
这条规则最古老的版本:一台会自己停下来的机器
丰田自己讲述其生产方式的历史,开篇就是一台织布机。丰田佐吉 1896 年发明的动力织布机,据该公司描述配备了"a new weft-breakage automatic stopping device (developed in 1896)"(中译:一种全新的纬线断裂自动停止装置(1896 年研发)):纬线一旦断裂,织布机就会停下,而不是把瑕疵继续织进布里 [5]。Type G 自动织布机不仅能应对纬线断裂,经线断裂时同样会停机,第一台于 1925 年 11 月下线 [6, 7]。大野耐一对这条原则——Jidoka——的注解是"automation with a human touch."(中译:带着人情味的自动化。) [8] 这台织布机的关键,从来不在于它能侦测到断线本身,而在于侦测与停机是同一个事件:机器绝不会在带着故障的状态下继续运转,却不让人知道。
这条谱系里还有两块拼图值得一提。1924 年 5 月 16 日,Walter Shewhart 向他在 Western Electric 的上级递交了一份备忘录,提出了控制图 [9]——这个工具能把随机变异,和他所说的「可归因原因」区分开来;他 1931 年出版的书里,直白地写下了这条假设:"Assignable causes of variation may be found and eliminated."(中译:可归因的变异原因,是可以被找到并消除的。) [10] 一个不产生任何信号的原因,是不可能被找到的,因而也就不可能被消除。而丰田使用的安灯系统——任何一线工人都可以拉动的那根绳——据该公司自述可追溯到 1950 年;其描述是:"a team member on the production line can pull the cord to flag up the issue, stop the process and receive immediate assistance."(中译:生产线上的任何一名成员都可以拉动绳索,标记出问题,停止流程,并立即获得协助。) [11] 停机是一项权利,也是一项义务,而不是一种指控。
第一集里那幅厨房的画面依然成立。那台秤,是「通过」的第一态。这一集补上的,是弹簧断裂时会自动停下的搅拌机,以及那个不去凭感觉猜重量、而是直接大声说出「秤坏了」的厨师。这两者都不是在评判这道菜本身,而是厨房拒绝在一个未知状态下继续往前走。
| 厨房 | 仓库 |
|---|---|
| 弹簧断裂时会停下的搅拌机 | 审查员的第三态:「unmeasured」,连同原因一起贴在 PR 上 |
| 会自己响的工单计时器,负责催单 | 响应时钟:跑在 GitHub 上的定时任务,48 小时内给出首次响应,7 天内做出决定 |
| 从没打印出来的工单——没人在做,也没人知道 | 解析失败的工作流:没有 check-run,checks 列表里什么都没有 |
沉默的数字:这波洪流里,有多少能落进人的眼睛
第三种状态在 2026 年比在 2016 年更要命,原因是人类这道后备防线正在变薄。2013 年测得的现代代码评审的通行做法是"performed regularly and quickly just before the code is committed"(中译:就在代码提交前不久,规律而快速地进行),通常由两名评审者完成,完成时间中位数大约是十五到二十一小时 [12]。Google 的工程指南用一句话定下标准:"One business day is the maximum time it should take to respond to a code review request"(中译:回应一次代码评审请求,最多不应超过一个工作日) [13],其 2018 年对约九百万次评审改动的研究发现,完整评审的延迟中位数不到四小时 [14].
以这条基线为参照,智能体时代的数字读出来的不是速度的崩溃,而是覆盖率的崩溃。在那项企业研究里,AI 评审覆盖的 PR 比例从约 19% 升到 84%,人类评审覆盖率却从 89% 跌到 68% [2]。在 GitHub 上的智能体化 PR 中,大多数根本得不到任何人类评审 [3]。在人工检查的 717 个 PR 中,三分之一的拒绝没有可观察到的理由,5.5% 完全没有留下可见的互动痕迹 [4]。厂商自己设定的默认值,从另一面讲了同一个故事:Anthropic 托管的代码评审发布的是中性检查而非阻塞性检查,平均每次运行花费十五到二十五美元 [15];Cursor 的 Bugbot 默认报告中性状态,除非你主动选择让未解决的问题导致失败 [16]。中性检查是一种有礼貌的沉默:它在场,却什么都不判定。
档案里的这些研究,没有一项发现有哪家机构针对智能体流量制定了正式的评审服务等级。这三十个月的记录显示的是覆盖率在下滑。这道缺口,正是本集后半部分要填补的。
构建过程:三种状态,加一个挂在 GitHub cron 上的时钟
一、AI 评审者的第三种状态
这个评审者继承自前篇文章和第一集:读取 diff,跑机器闸门,向模型索取结构化发现,剔除任何没有file:line引用来源的发现,然后为每个 PR 发一条评论。让它永不沉默的改动,代码量很小,后果却很大:程序里不存在任何一条不以发布评论结束的路径。如果凭证缺失,如果平台返回身份验证错误,如果模型拒绝作答,如果结构化输出解析失败,简报都会渲染出一个标题为「unmeasured」的小节,写明确切原因,紧跟一句「这不等于『没问题』」,再附上机器闸门的结果,并注明现在每一个只有人才能回答的问题都需要人来回答。工作流照样把它发出去。一项单元测试钉死了每一句措辞,这样重构就不能悄悄把两状态版本恢复回来。
现场记录就是证据,取自 2026-09-09 那天读到的 PR 评论(头两次运行在 [17] 中有描述)。从 2026-09-06 到 09-09,工作流对仓库里从引入它那次起的每一个 pull request 都跑了一遍,一共十一次,十一次都发布了简报;十一次都写着「unmeasured」,起初是因为仓库没有密钥,后来是因为给的密钥被 401 拒绝了;没有一次保持沉默。这次运行结束时构建的循环审计,直接从 GitHub API 读出这两个事实,并把它们报告为两条标准:「每个 PR 都携带一份简报」和「unmeasured 会被发布出来,绝不沉默」,两条都通过;而「AI 已经真正测量过某个 PR」这一条,则会一直保持 unmeasured 状态,直到出现一个有效凭证为止。审计不允许把这一条悄悄拔高判定为通过,下面第三起事故说的正是它有一次这么做了之后发生的事。
二、响应时钟
仓库自己的提案早在 2026-09-02 就测出了这个问题:每个已合并的 PR 都是自我审核,没有一个经过别人评审,最老的一个已经开了 398 小时。任何依赖「有人会记得」的修复方案,注定会重蹈覆辙。这份提案就这么搁置了一周没人实现。2026-09-07,负责该领域的联合创始人开了三个 pull request;到 09-09 早上,它们已经等了五十七个小时,没有任何维护者回应——这正是提案当初想要防止的那种违规。那天早上,这个 bot 被造了出来。
它是一个纯函数外加一个 cron 定时任务。这个函数接收一个 pull request、当前时间和一份策略文件,返回五种状态之一:ok、needs-first-response(待首次响应)、overdue-decision(决策逾期)、exempt(豁免)或 draft(草稿)。「维护者活动」指的是策略文件维护者名单里的人所做的任何评论、评审、合并或关闭操作,其中有三类例外,都是单元测试跑出来的:作者自己的评论不算数,哪怕这个作者本身就是维护者;AI 审阅者的评论也不算数,因为机器说的「unmeasured」不等于人说的「我看过了」;仪表盘自己发的评论同样不算数。四十八小时没有维护者响应是硬性阈值;七天没有决策是软性阈值。有两个 PR 按编号被豁免,理由写在策略文件里:一个是闸门建立之前遗留的 PR,另一个是前篇文章里故意保持开启状态的负向测试 PR。
这个 cron 任务每天在 GitHub 的基础设施上运行一次。每次运行时,它会添加或移除两个标签,并原地重写一个仪表盘 issue(按标题查找),这样看板就是一个不断被覆写的单一界面,而不是越堆越长的提醒串。第一次实际运行是手动触发的,作为提案要求的反向验证(提前用模拟场景检验流程是否走得通):它给三个联合创始人的 PR 打上了标签,两个豁免的 PR 则未被触碰。随后它以非零状态退出——因为该仓库关闭了 issues 功能,仪表盘根本没法创建。这是正确的行为:这份契约有两项输出,标签和看板,只完成了一项的运行,应当把缺失的那一项报告为失败,而不是谎称成功。仓库设置被改了过来,bot 重新运行,看板随即出现,三行违规、两行豁免。现在,一旦再次发生这种失败,bot 会用直白的话把它标注出来。
沉默的那一种状态:合并在一个看不见的红灯上
以下就是这套设计没能拦住的那次失败,按事发经过如实报告。那天早上合并的一个 pull request,给 CI 工作流文件加了一条注释。这条注释以纯文本形式,写了一对实打实的空表达式花括号,本意是想说「不要往 shell 里插值表达式」。可 GitHub 会对工作流文件里所有地方的表达式求值,注释也不例外,而一个空表达式就是一个解析错误。从那次提交开始,这个工作流就再也跑不起来了。
从外部看到的样子,才是问题的关键。一个解析失败的工作流会产生一个零任务的运行记录,结论是 failure,名字是文件路径而不是工作流本身的名字。它不会产生任何 check-run。而我一直用来判断能不能合并的那条列出 PR 检查项的命令,对它则完全什么都没显示——只显示了另一个工作流的结果,然后就没了。我合并了那个 PR,紧接着又合并了第二个,合并的对象是一个连一行记录都没有的红灯。
循环审计当天就抓到了这个问题,因为它对 CI 的实际判定标准读的是主分支最新一次运行的结论,而不是检查项列表——而那次运行的结论就是 failure,还带着那个文件的名字。修复方案包括:改掉那条注释、加一条「工作流文件里出现空表达式就判失败」的单元测试、在仓库自己的教训记录里记一笔,以及给我自己定一条新的合并规则:判断一个 PR,看的是它工作流运行的结论,绝不能看检查项列表——因为真正伤人的那种状态,恰恰是列表显示不出来的那种。
同一天下午,审计又抓到了同一类失败的另一个变种,方向正好相反。新的溯源闸门要求由智能体撰写的 PR,必须把验证输出粘贴进 PR 正文里。可在一次 push 事件中,合并之后是没有 PR 正文这回事的,于是 CI 步骤写出了一个空文件,闸门把这种「空」读成了「这部分缺失」,就把主分支判成了红色。这是一个两态闸门把「缺失」读成了「失败」而不是「通过」——这样虽然更保险,但仍然是错的。修复方案给了它第三种状态:空正文就是「没有正文可查」,报告为 unmeasured,而且 CI 步骤现在只在 pull-request 事件里才去写正文。这两起事故都记在仓库的教训文件里,编号 8.27 和 8.28,而且都配了测试。
接着,审计把这套逻辑用到了自己身上。它在 CI 里的第一次运行,跑出了一项红色判定和一项绿色判定,而问题恰恰出在那项绿色判定上。红色的那项是诚实的:这个任务没装测试运行器,审计想跑测试,跑不了,于是把它判为失败。绿色的那项,是那个「累计对比」检查,它把每一项计数和一个基线提交做比较。可 CI 检出的代码里根本没有本地的 main 分支,寻找基线的命令执行失败了,而代码里的兜底逻辑把这条报错文本当成了提交 ID,把每一项基线计数都读成了零。从零涨到任何数字都算是「增长」,于是这项检查就通过了——这是一个专门为了抓「unmeasured 被悄悄拔高成通过」这类问题而造的工具,自己内部却也藏了同一种毛病。修复方式和前两次如出一辙:缺失测试运行器就是「unmeasured」,无法解析的基线也是「unmeasured」,并且用五条单元测试把它钉死在这个状态上。这就是条目 8.29,也正是为什么上面那句话说的是「审计不被允许悄悄拔高判定」,而不是说「审计从来不会拔高判定」。
五个为什么:为什么「跑不起来」必须是一个被公开发布的状态,而不是一片空白
| # | 为什么? | 因为 | 证据 |
|---|---|---|---|
| 1 | 为什么一个闸门需要第三种状态? | 因为在一个两态闸门里,「没跑起来」和「什么都没发现」产生的输出是一模一样的,读者根本分辨不出两者的区别。 | 在这个实战案例里,十一份简报全都是「unmeasured」,这是从 2026-09-09 的 PR 评论里读出来的;如果是两态设计,这十一份简报看起来会全都很干净。前两次运行记录见 [17] |
| 2 | 为什么这个问题在今天比过去更严重? | 因为原本会注意到问题的那个人,如今越来越不会去看了:那项企业研究里的覆盖率从 89% 跌到了 68%,而大多数由智能体提交的 PR 根本得不到任何人工评审。 | [2, 3] |
| 3 | 为什么第三种状态必须被公开发布,而不能只是记进日志? | 因为一个只存在于日志里的状态,没人会在合并决策的那一刻去读它;织布机是停在车间地板上的,不是停在账本里的。 | 1896 年那台织布机的停机,就是它的检测动作 [5];而那次看不见的红灯事故,恰恰说明了一种失败确实存在于运行日志里,却没有出现在合并决策所查看的任何地方 |
| 4 | 为什么它绝不能被算作「通过」? | 因为一个被误判为随机波动的可归因原因,永远无法被发现和消除;如果审计把「unmeasured」悄悄记成「pass」,它汇报的就是一个从未真正运转过的健康循环。 | Shewhart 的公理 [10];循环审计故意让「AI 已测量某个 PR」保持在「unmeasured」状态 |
| 5 | 为什么响应时钟也要放进同一集? | 因为一个没人回应的 PR,就是沉默的人类版本;Google 的「一个工作日」规则和安灯拉绳说的是同一件事:只有每天都有人去拉,停线的权利才是真实的。 | [13, 11];第一次运行时,三个 PR 被标记在第五十七小时 |
归结到一句话:一个闸门无法运行,这件事本身就是一次测量;而一次没有被张贴在合并决策所在之处的测量,等于从未被做过。
30 分钟搭建:永不沉默契约
「三十分钟」是这份契约留给照抄它的读者的预算,而不是我实测出来的时间。第三种状态在审查器里只花了一个分支和一个测试;响应机器人花了一个上午;三起事故各花了一个下午。
| 要素 | 规范 |
|---|---|
| 三种状态 | 每一次自动化判断都返回 pass、fail 或「unmeasured」三者之一,且每种状态都会在 pull request 上张贴对应输出。「unmeasured」会原样带上理由(凭据缺失、401、拒绝执行、解析失败、该事件类型无可用输入),并附上一句声明——这不是 pass。 |
| 空列表也要带理由 | 如果一个部分因为无内容可报而留空,就必须说明原因;一个没有理由的空白部分,和一个从未被计算过的部分,看起来毫无区别。 |
| 按事件类型区分输入 | 如果某个闸门的输入会因事件类型而异(比如 PR 正文只存在于 pull-request 事件而非 push 事件中),那么「输入不可用」应判为「unmeasured」,绝不能记作 fail,也绝不能记作 pass。 |
| 响应时钟 | 这是一个基于 (PR, 当前时间, 策略) 的纯函数分类器,输出五种状态之一:ok · needs-first-response · overdue-decision · exempt · draft。策略即数据:首次响应所限小时数、决策所限天数、维护者名单、需要忽略的评论标记、附带书面理由的豁免项。定时任务运行在平台自带的调度器上。只用两个标签,一块会被原地覆盖、通过标题定位的看板。 |
| 两半原则 | 如果机器人的契约有两项输出(标签和看板),只交付其中一项而缺了另一项,这本身就是一次失败,且必须指名缺失的是哪一半,而不能算作成功。 |
| 合并规则 | 合并与否,看的是该工作流运行在该分支上的最终结论,绝不能只看 checks 列表。一次任务数为零、且名字是文件路径而非工作流名称的运行,是一次解析失败,应判为红色。 |
| Guard | 一条规则:只要工作流文件里含有空表达式就判失败;同一个 Guard 的另一条规则是:只要某个门禁脚本缺少自测也判失败(第五集)。 |
| 刻意留白之处 | unmeasured 状态下不重试;不设超出打标签与看板之外的升级机制;不做寻呼告警。每加一样,都是多一条可能悄悄失效的路径。 |
# The classifier is the whole bot; everything else is plumbing.
def classify(pr, now, policy):
    if str(pr.number) in policy["exempt"]:     return "exempt"      # with a written reason
    if pr.is_draft:                             return "draft"
    responses = [t for who, t, body in pr.activities
                 if who in policy["maintainers"] and who != pr.author
                 and not any(m in body for m in policy["ignore_comment_markers"])]
    if not responses:
        return "needs-first-response" if age_h(pr, now) > policy["first_response_h"] else "ok"
    return "overdue-decision" if age_h(pr, now) > policy["decision_days"] * 24 else "ok"

# The merge rule, as a command (the checks list cannot show a parse failure):
# gh run list --workflow ci.yml --branch <branch> --json conclusion   →  merge only on "success"
同一个故事,五种读法
| 读者 | 那一个决定 | 那一个动作 |
|---|---|---|
| 学生 | "It didn't complain" is not the same as "it checked".(中译:“它没抱怨”不等于“它检查过了”。) | 找出你依赖的某一项自动化检查,让它在无法运行时也能打印出点什么。 |
| 工程师 | 三种状态,每一种都要有输出。 | 给你的审查器加一条 unmeasured 分支,再写一个测试把这句措辞钉死。 |
| 创始人 | 响应时钟是一份策略文件加一个定时任务,不是靠人。 | 把两个数字——首次响应要等多少小时、做出决定要等多少天——连同豁免名单写下来,交给平台自己去跑。 |
| 高管 | 你看不见的失败,才是代价最大的那个。 | 问一句:你的合并决定依据的是什么?这个依据能不能显示出一个从未启动过的工作流? |
| 投资人 | 一台会自己停下来的织机,比一台织得更快的织机更值钱。 | 让团队在一个真实的 PR 上,给你看一次门禁报出 "could not run"(中译:无法运行)的样子。 |
模式、反模式,与第一性原理
站住脚的模式。 三种状态,每种都有明确输出。空列表必须附带理由。输入按事件类型分类处理。分类器是基于策略文件的纯函数。仪表盘只有一个,且是覆盖写入的。机器人正式上线前先跑一次反向验证(即上线前的预演式检验)。两半齐全原则。
被替换掉的反模式。 一个审查者在缺少密钥时只打印机器闸门结果,看起来像是一次干净的审查通过。一份服务水平协议躺在提案里整整一周没人管,三个 PR 就这样被拖过了期限。合并决策依据一份根本显示不出关键失败的列表。一个把缺失输入当作失败输入来处理的闸门。
这套机制,取个名字。 审查者和机器人里的每一条代码路径,最终都会落到一次发帖上;「什么都不说」在结构上根本不可能发生——唯一能陷入沉默的情况,是平台本身在代码运行之前就已经失效,而这恰恰是合并规则要专门应对的场景。
第一性原理,一句话说完。 一个无法做出的判断,本身就是关于这个系统的一项事实,必须记录在下一个决策发生的地方;沉默不是一种状态,它是状态的缺失。
现实任务
第 1 集曾许下承诺:到第 2 集时,响应机器人会处理那三个卡在五十七小时的 PR。现在它做到了:这三个 PR 都被打上了标签,看板上也列出了它们,创建看板的那次运行记录在案卷里,编号可查。到第 3 集,抓出「隐形红灯」的那次循环审计,将在一条绿色的主分支上重新跑过一遍,报告也会提交存档;而那三个联合创始人提交的 PR,要么已经收到第一次回应,要么看板会如实写着——它们还没有。
接下来读什么
第 2 集,出自 ANDON · Agentic PR Review and CI/CD。每个数字都标明了它的适用范围;厨房只是一个类比模型,不是实测数据。文中描述的审查者、响应机器人、循环审计以及三起事故,都存在于一个私有仓库中;相关结构已在本文的规范中还原,因此读者无需访问该仓库即可理解。本集所引用的四视野案卷,记录在作品集的 plans 目录下。
参考文献
- GitHub, 《PR 数量限制如何降低噪音》, 2026-06-18. github.blog
- He, Agarwal, Denisov-Blanch, Azaletskiy, Koyejo, Vasilescu, AI Writes Faster Than Humans Can Review: A Longitudinal Study of an Enterprise 2x Mandate,arXiv:2607.01904,2026-07-02。 arxiv.org
- Duma 等, These Aren't the Reviews You're Looking For,arXiv:2605.02273,2026-05-04。 arxiv.org
- Peralta 等, Why Are Agentic PRs Merged or Rejected?,arXiv:2605.22534,2026-05-21。 arxiv.org
- Toyota Motor Corporation, Toyota Production System. global.toyota
- Toyota Industries Corporation, Sakichi Toyoda. toyota-industries.com
- Toyota Motor Corporation, 75 Years of Toyota,Type G。 toyota-global.com
- Autonomation, Wikipedia,引用 Ohno 1988,第 6、58 页。 en.wikipedia.org (二手引用;未直接获取 Ohno 原书)
- Best, Neuhauser, Walter A Shewhart, 1924, and the Hawthorne factory,《Quality & Safety in Health Care》,2006 年。 pmc.ncbi.nlm.nih.gov
- Shewhart, Economic Control of Quality of Manufactured Product,Van Nostrand,1931 年,第 3 条公设(archive.org 扫描件)。 archive.org
- Toyota UK, TMUK's 25 Objects – Andon Cord, 2017-12-11. mag.toyota.co.uk
- Rigby, Bird, Convergent Contemporary Software Peer Review Practices,ESEC/FSE 2013。 users.encs.concordia.ca(作者本人留存版本,引文已据此核对;Microsoft Research 镜像站拒绝自动抓取)
- Google Engineering Practices, Speed of Code Reviews. google.github.io
- Sadowski, Söderberg, Church, Sipko, Bacchelli, Modern Code Review: A Case Study at Google,ICSE-SEIP 2018,作者本人留存版本。 sback.it
- Anthropic, Code Review,Claude Code 文档。 code.claude.com
- Cursor, Bugbot 文档。 cursor.com
- Paul Jialiang Wu, AI PR Review That Cannot Lie,2026-09-08(该审查器的设计及其最初两次运行)。 futuremake.io