AI-Native 시리즈 · ANDON · 에이전트형 PR 리뷰와 CI/CD · 5부작 중 2화
저장소를 위한 지도카: 침묵하지 않는 PR 게이트
에이전트형 PR 리뷰와 CI/CD, 두 번째 에피소드. 1896년, 한 직기가 실이 끊어지면 스스로 멈추는 법을 배웠다. 대부분의 CI 파이프라인은 그 교훈을 배우지 못했다. 실행할 수 없는 게이트는 아무것도 발견하지 못한 게이트와 똑같이 보이고, 둘 다 초록불이다. 이번 에피소드는 ANDON의 N이다. 두 가지가 아니라 세 가지 상태를 가진 게이트, 사람의 기억이 아니라 GitHub의 cron에서 자동으로 동작하는 응답 시계를 만들고, 마지막으로 목소리가 전혀 없어 설계가 잡아내지 못한 단 하나의 실패를 보고한다.
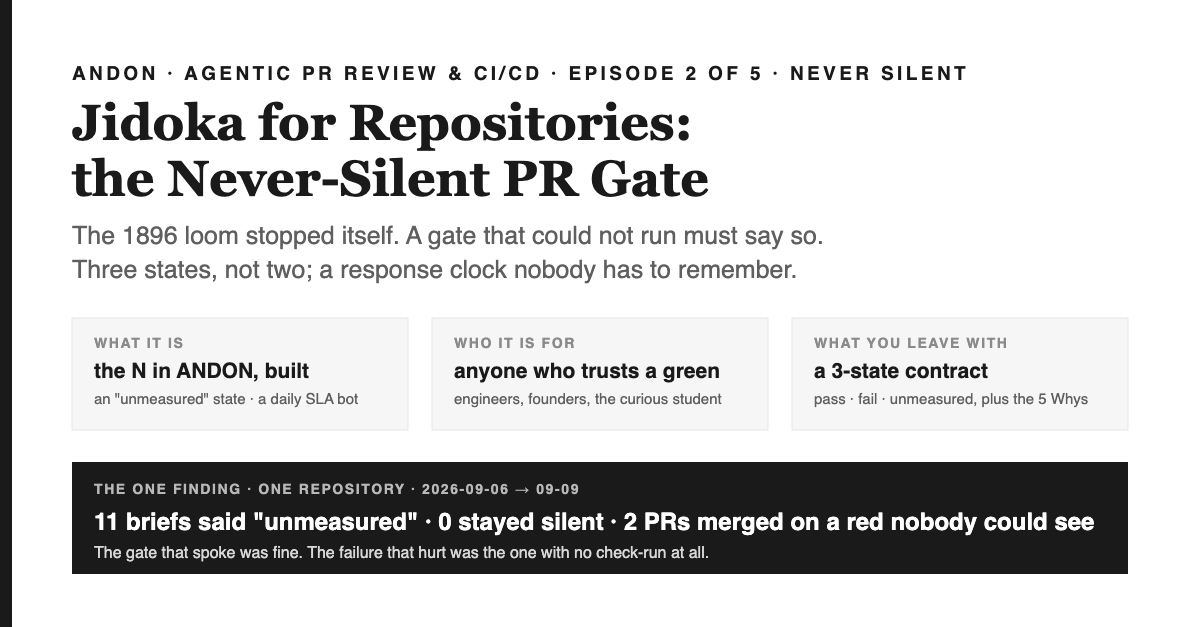
1분 요약 — 이 글을 읽고 얻어갈 것
이 글은 무엇인가. ANDON ANDON의 5부작 중 두 번째 에피소드다. 이번 편의 규칙은 침묵하지 않음, 실제 저장소에 구현한 침묵하지 않는 PR 게이트이다. 세 가지 상태(통과, 실패, 그리고 측정 불가)를 가진 AI 리뷰어, PR에 라벨을 붙이고 대시보드를 매일 자동으로 덮어쓰는 응답 시간 봇, 그리고 상태가 남지 않은 실패까지 정직하게 보고하는 시스템이다.
왜 중요한가. 엔지니어라면 알아야 한다. 두 가지 상태만 가진 게이트는 누락으로 인해 거짓 신호를 준다. "실행할 수 없음"이 "문제 없음"으로 처리되고, PR 홍수 속에서 이런 누락은 일상적이다. 창업자라면 주목할 만하다. 기업 데이터에 따르면 처리량이 두 배로 늘어나는 동안 휴먼 리뷰 비율은 89%에서 68%로 떨어졌다. 당신이 놓치는 신호는 바로 침묵하는 게이트가 감추는 그 신호다. 학생에게는 품질 관리에서 가장 오래된 아이디어, 즉 스스로 멈추는 기계를 최신 문제에 적용한 사례다.
읽고 나서 할 수 있는 일 모든 자동화된 판단에 세 가지 상태와 각 상태에 대해 게시되는 출력을 부여하라. GitHub의 cron에 정책 파일을 두고, 대시보드를 매일 덮어쓰는 방식으로 응답 시계를 두라. 그리고 이 에피소드가 대가를 치르고 얻은 병합 규칙을 채택하라. 체크리스트가 아니라 워크플로 실행 결과(자체 결론)에 따라 병합하라. 체크 실행이 없는 실패는 체크리스트에 보이지 않는다.
ANDON — 시리즈 줄기
- A · Assess — PR 홍수는 측정되는 것이지 느껴지는 것이 아니다 1화
- N · 침묵하지 않음 — 저장소를 위한 지도카 이번 화
- D · Data, not prose — 어긋날 수 없는 규칙 3화
- O · 경계선 내부에서만 — 영향 범위는 경로 목록으로 정한다 4화
- N · 네거티브 테스트 — 게이트는 반드시 실패(레드)를 경험한 뒤에만 설치된다 5화
이번 에피소드의 범위와, 왜 침묵하지 않는 PR 게이트가 두 번째로 오는지
에피소드 1에서는 PR 홍수의 규모를 측정했다. 2023년 1월부터 2026년 중반까지 GitHub에서 병합된 PR 수는 세 배 이상 늘었고, 자체 측정한 한 기업에서는 1인당 처리량이 기준선의 2.09배에 도달하는 동안 휴먼 리뷰가 들어간 PR 비율은 89%에서 68%로 떨어졌다 [1, 2]. 마지막은 기계 게이트로 끝났다. 판단이 개입되지 않는 저울, 즉 스크립트가 결정할 수 있는 것만 결정하는 저울이다. 이번 에피소드는 그 저울이 무게를 잴 수 없을 때 무엇을 해야 하는지에 관한 이야기다.
이런 상황은 흔하다. AI 리뷰어는 자격 증명이 필요하다. 이 자격 증명은 만료되거나 잘못 붙여넣거나 교체되기도 한다. PR 본문을 읽는 게이트는 푸시 이벤트에서는 본문을 받지 못한다. 워크플로 파일은 파싱에 실패할 수 있다. 대시보드를 작성하는 봇은 대시보드 기능이 꺼져 있음을 발견할 수 있다. 이런 모든 경우에, 통과/실패 두 상태만 가진 게이트는 아무것도 실행되지 않고 아무것도 실패하지 않았을 때 기본적으로 통과 상태를 낸다. PR의 독자는 초록불만 본다. 문헌에 따르면, 이 독자가 점점 유일하게 PR을 보는 인간이 되어간다. 2026년 한 연구에서는 AI가 생성한 PR의 대부분이 인간 리뷰를 받지 않았고, 리뷰가 있더라도 대개 봇이 작성했다[3], 그리고 11,048개의 에이전트형 PR을 수작업으로 조사한 결과, 5.5%는 상호작용의 흔적이 전혀 보이지 않았다[4].
그래서 이번 에피소드의 규칙은 이렇다. 게이트에는 세 가지 상태가 있고, 그중 세 번째는 반드시 말을 한다. 실제 예시는 1화와 같은 비공개 품질 관리 레포지토리다. 여기서 AI 리뷰어의 첫 11번 실운영 모두가 세 번째 상태에 도달했고, 응답 시간 봇이 처음으로 작동했으며, 같은 날 상태가 전혀 남지 않은 실패에서 두 개의 PR이 병합되었다. 마지막에 등장하는 '5 Whys'는 왜 세 번째 상태가 단순한 부재가 아니라 반드시 게시된 코멘트여야 하는지 묻고, 그 답의 기원은 1896년 방직기까지 올라간다.
가장 오래된 규칙의 형태: 스스로 멈추는 기계
도요타가 자사 생산 시스템의 기원을 설명할 때, 방직기에서 시작한다. 1896년 Sakichi Toyoda가 만든 동력 방직기는 회사 설명에 따르면 "a new weft-breakage automatic stopping device (developed in 1896)"(번역: 1896년에 개발된 새로운 씨실 끊김 자동 정지 장치)를 탑재했다. 씨실이 끊어지면 방직기는 천에 결함을 남기지 않고 스스로 멈췄다[5]. Type G 자동 방직기는 씨실뿐 아니라 날실이 끊어져도 멈췄고, 최초의 제품은 1925년 11월 생산 라인에서 나왔다[6, 7]. Taiichi Ohno가 이 원칙을 해설하며 사용한 용어, 즉 지도카(jidoka)는 "automation with a human touch."(번역: 인간적인 감각이 더해진 자동화) [8]였다. 이 방직기의 핵심은 끊어진 실을 감지했다는 데 있지 않다. 감지와 정지가 동일한 사건이라는 점에 있다. 즉, 사람이 모르는 상태로 기계가 결함 상태에서 계속 움직일 수 없다는 것이다.
여기서 계보상 더 중요한 두 가지가 있다. 1924년 5월 16일, Walter Shewhart는 Western Electric의 상사들에게 관리도를 제안하는 메모를 보냈다[9]. 이 도구는 우연 변동과 그가 '할당 가능한 원인'이라 부른 것을 구분한다. 그의 1931년 저서는 이 명제를 직접적으로 밝힌다: "Assignable causes of variation may be found and eliminated."(번역: 변동의 할당 가능한 원인은 찾아내어 제거할 수 있다.) [10] 신호를 내지 않는 원인은 발견될 수 없고, 따라서 제거될 수도 없다. 그리고 도요타가 안돈 시스템, 즉 생산 라인을 멈추기 위해 누구나 당길 수 있는 코드를 도입한 것은 회사 기록에 따르면 1950년으로 거슬러 올라간다. 그 설명은 "a team member on the production line can pull the cord to flag up the issue, stop the process and receive immediate assistance."(번역: 생산 라인의 팀원이 코드를 당겨 문제를 알리고, 공정을 멈추며, 즉각적인 지원을 받을 수 있다.) [11]이다. 멈추는 것은 권리이자 의무이지, 비난이 아니다.
1화에서 사용한 주방 비유는 여전히 유효하다. 저울은 통과 여부만 판단한다. 이번 화에서 추가된 것은 스프링이 끊어지면 멈추는 믹서기와, 무게를 짐작하지 않고 "저울이 고장났다"고 소리 내어 말하는 요리사다. 둘 다 요리에 대한 판단이 아니다. 둘 다 주방이 미지의 상태에서 진행을 거부하는 것이다.
| 주방 | 레포지토리 |
|---|---|
| 스프링이 끊어지면 멈추는 믹서기 | 리뷰어의 세 번째 상태: "unmeasured"(측정 불가), 사유와 함께 PR에 게시 |
| 스스로 울리는 주방 티켓 타이머 | 응답 시계: GitHub의 cron에서 동작, 첫 응답까지 48시간, 결정까지 7일 |
| 출력이 한 번도 찍히지 않은 티켓, 그래서 아무도 요리를 시작하지 않고 아무도 모른다. | 파싱에 실패한 워크플로: 체크-런이 없고, 체크 리스트에도 아무것도 없다. |
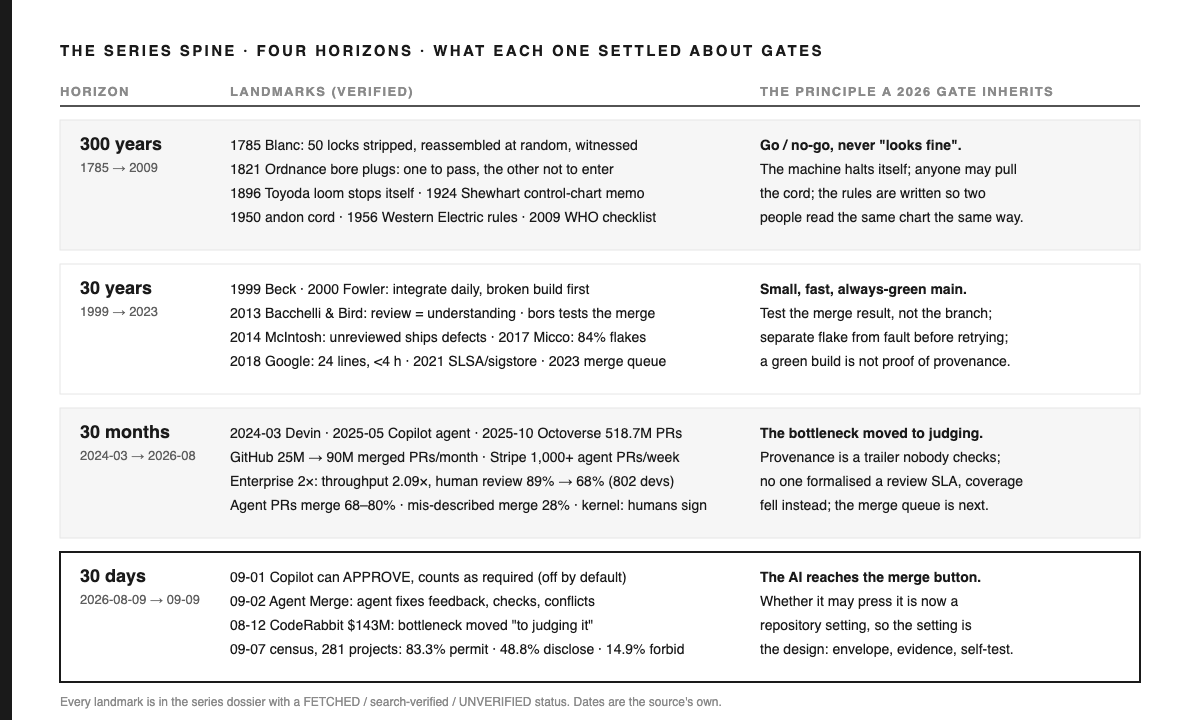
침묵의 수치: PR 홍수 속에서 실제로 인간의 눈길이 닿는 비율은 얼마나 될까.
2026년에 세 번째 상태가 2016년보다 더 중요한 이유는, 인간이 마지막 보루 역할을 하는 빈도가 점점 줄어들고 있기 때문이다. 2013년 측정된 현대 코드 리뷰의 수렴적 관행은"performed regularly and quickly just before the code is committed"(번역: 코드가 커밋되기 직전에 정기적이고 신속하게 수행된다)로, 보통 두 명의 리뷰어가 참여하며, 중간 완료 시간은 대략 15~21시간이었다 [12]. 구글 엔지니어링 가이드에서는 한 문장으로 기준을 제시한다:"One business day is the maximum time it should take to respond to a code review request"(번역: 코드 리뷰 요청에 대한 응답은 최대 영업일 기준 하루 이내여야 한다) [13], 그리고 2018년 약 900만 건의 리뷰 변경을 분석한 연구에서는 전체 리뷰의 중간 지연 시간이 4시간 미만임을 발견했다 [14].
이 기준선과 비교하면, 에이전트 시대의 수치는 속도가 아니라 커버리지의 붕괴로 읽힌다. 엔터프라이즈 연구에서는 AI 리뷰 커버리지가 PR의 약 19%에서 84%로 상승한 반면, 인간 커버리지는 89%에서 68%로 하락했다 [2]. GitHub의 에이전트형 PR 중 대부분은 인간의 리뷰를 전혀 받지 못한다 [3]. 717개의 PR을 수작업으로 점검한 결과, 거절된 PR의 3분의 1은 관찰 가능한 근거가 없었고, 5.5%는 상호작용의 흔적조차 전혀 없었다 [4]. 벤더의 기본 설정도 같은 이야기를 반대편에서 보여준다. Anthropic의 관리형 코드 리뷰는 차단(check-blocking)이 아닌 중립 체크를 남기며, 한 번 실행에 평균 15~25달러가 든다 [15]; Cursor의 Bugbot은 미해결 이슈에 대해 실패로 처리하도록 명시적으로 선택하지 않는 한 중립 상태를 보고한다 [16]. 중립 체크란 공손한 침묵의 한 형태다. 존재는 하지만, 아무 결정도 내리지 않는다.
이 자료집에 실린 어떤 연구도 에이전트 볼륨에 대해 공식적인 리뷰 서비스 레벨로 대응한 조직을 찾지 못했다. 30개월의 기록은 오히려 커버리지 하락만을 보여준다. 바로 그 격차가 이번 에피소드 후반부가 겨냥하는 지점이다.
구현: 세 가지 상태, 그리고 GitHub의 cron에 올린 응답 시계
1. AI 리뷰어의 세 번째 상태
프리커서 글과 1화의 리뷰어는 diff를 읽고, 머신 게이트를 실행하며, 모델에 구조화된 결과를 요청하고,file:line 인용이 없는 결과는 버린다. 그리고 PR마다 하나의 코멘트를 남긴다. 침묵하지 않게 만드는 변화는 코드상 작지만, 결과는 크다. 코멘트가 게시되지 않고 끝나는 경로가 프로그램에 존재하지 않는다. 자격 증명이 없거나, 플랫폼이 인증 오류를 반환하거나, 모델이 거부하거나, 구조화된 출력이 파싱에 실패하면, 브리프는 'unmeasured'라는 섹션을 정확한 사유와 함께 렌더링한다. 이어서 "이것은 '문제 없음'이 아니다"라는 문장, 머신 게이트 결과, 그리고 이제 모든 인간 전용 질문에는 인간이 필요하다는 메모가 붙는다. 워크플로는 어쨌든 이를 게시한다. 각 문구는 유닛 테스트로 고정되어 리팩터링 시 조용히 2상태로 돌아가지 못하게 한다.
실제 기록이 바로 증거다. 2026-09-09의 PR 코멘트에서 확인할 수 있다(첫 두 번의 실행은 [17]에 설명되어 있다). 2026-09-06부터 09-09까지, 해당 워크플로는 도입된 시점 이후 저장소의 모든 PR에서 실행되었고, 총 11개 모두에 브리프를 남겼다. 이 11개 모두 'unmeasured'였다. 처음에는 저장소에 키가 없어서였고, 그 다음에는 주어진 키가 401로 거부되어서였다. 침묵한 경우는 없었다. 이 실행 마지막에 구축된 루프 감사는 GitHub API에서 이 두 사실을 직접 읽어들여, "모든 PR에 브리프가 있다"와 "unmeasured가 게시되어 침묵이 없다"라는 기준을 모두 통과로 보고한다. 반면 "AI가 실제로 PR을 측정했다"라는 기준은 유효한 자격 증명이 생길 때까지 unmeasured로 남는다. 감사는 이를 임의로 올려서 통과시킬 수 없으며, 아래의 세 번째 사건이 바로 한 번 그렇게 했을 때 벌어진 일이다.
2. 응답 시계
저장소 자체의 제안서는 2026-09-02에 문제를 측정했다. 머지된 PR은 모두 작성자가 직접 썼고, 리뷰는 하나도 없었으며, 가장 오래 열린 PR은 398시간이 넘었다. 누군가의 기억에 의존하는 해결책은 이런 상황을 반복할 뿐이다. 이 상태로 일주일이 흘렀다. 2026-09-07, 도메인 공동 창업자가 PR 세 개를 올렸고, 09-09 아침까지 유지관리자의 응답 없이 57시간이 지났다. 바로 이 상황을 막으려 제안서가 만들어졌고, 그날 아침 봇이 만들어졌다.
이 봇은 순수 함수와 cron으로 구성된다. 함수는 PR, 현재 시각, 정책 파일을 받아 다섯 가지 상태 중 하나를 반환한다: ok, needs-first-response, overdue-decision, exempt, draft. 유지관리자 활동은 정책의 maintainer 목록에 포함된 이름으로 남긴 댓글, 리뷰, 머지, 클로즈를 모두 포함한다. 단, 유닛 테스트에서 도출된 세 가지 예외가 있다. 작성자가 maintainer여도 자신의 댓글은 인정하지 않는다. AI 리뷰어의 댓글도 인정하지 않는다(기계의 "unmeasured"는 사람의 "봤다"와 다르기 때문이다). 대시보드의 댓글 역시 인정하지 않는다. 유지관리자 응답 없이 48시간이 지나면 하드(threshold), 7일이 지나면 소프트(threshold)다. 두 개의 PR은 정책에 사유가 명시되어 번호로 면제된다. 하나는 게이트 도입 전의 레거시 PR, 다른 하나는 프리커서 글에서 의도적으로 열어둔 negative-test PR이다.
cron은 GitHub 인프라에서 매일 실행된다. 매번 실행할 때마다 두 개의 라벨을 추가하거나 제거하고, 제목으로 찾은 대시보드 이슈를 제자리에서 덮어쓴다. 즉, 보드는 누적되는 알림 스레드가 아니라 항상 하나의 표면만 남는다. 첫 실운영은 제안서가 요구한 역방향 검증으로 수동 실행되었고, 세 개의 공동 창업자 PR에 라벨을 붙이고 두 개의 면제 PR은 그대로 두었다. 이후 비정상 종료했다. 저장소에서 이슈 기능이 꺼져 있어 대시보드를 만들 수 없었기 때문이다. 이는 올바른 동작이었다. 계약이 라벨과 보드, 두 부분으로 나뉘어 있으니, 한쪽만 성공하면 나머지 미실행 부분을 실패로 보고한다. 저장소 설정을 바꾼 뒤 봇을 다시 돌리자, 세 개의 위반 행과 두 개의 면제 행이 있는 보드가 나타났다. 이제 이 봇은 동일한 실패가 다시 발생하면 그 이유를 명확하게 알려준다.
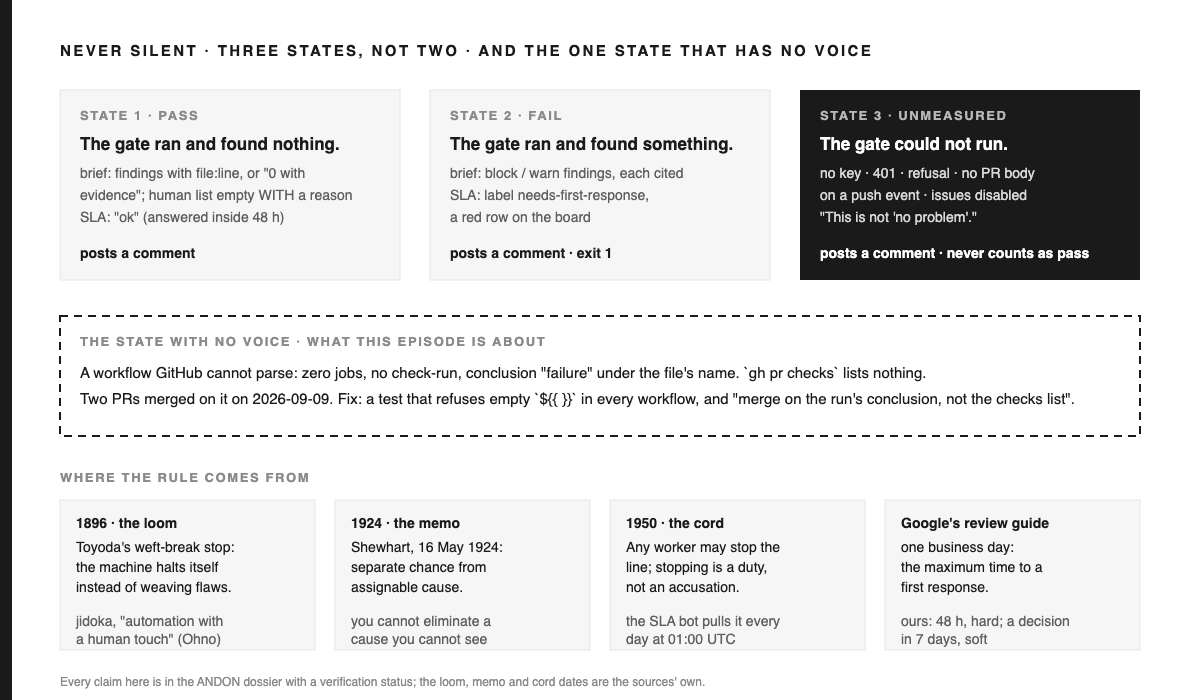
목소리가 없는 상태: 보이지 않는 빨간불에 머지하기
여기 설계가 잡아내지 못한 실패가 있다. 실제로 일어난 그대로 보고한다. 그날 아침 머지된 PR 하나가 CI 워크플로 파일에 주석을 추가했다. 그 주석에는 "셸에 식을 삽입하지 말라"는 의미로, 빈 중괄호 쌍이 문자 그대로 들어 있었다. GitHub은 워크플로 파일 어디서든(주석 포함) 식을 평가하는데, 빈 식은 파싱 에러다. 그 커밋 이후로 워크플로가 실행되지 않았다.
외부에서 보면 이게 핵심이다. 파싱에 실패한 워크플로는 잡이 0개인 실행(run), 실패 결론, 그리고 워크플로 이름이 아닌 파일 경로를 이름으로 가진다. 체크런도 생성하지 않는다. PR의 체크를 나열하는 명령(내가 머지 여부를 결정할 때 쓰던 것)은 아무것도 보여주지 않았다. 다른 워크플로의 결과 하나만 보여주고 멈췄다. 나는 그 PR을, 그리고 이어서 두 번째 PR도, 행이 없는 빨간불 상태에서 머지했다.
루프 감사는 같은 날 이 문제를 잡았다. CI의 실질적 기준이 체크 리스트가 아니라 메인 브랜치의 최신 실행 결론을 읽기 때문이다. 그 실행은 파일 이름과 함께 실패를 기록했다. 해결책은 주석을 수정하고, 워크플로 파일에 빈 식이 있으면 실패하는 유닛 테스트를 추가하고, 저장소 자체의 교훈 파일에 기록하며, 내게는 새로운 머지 규칙을 남겼다: PR은 체크 리스트가 아니라 워크플로 실행 결론을 기준으로 판단할 것. 리스트가 보여줄 수 없는 상태가 바로 치명적이기 때문이다.
같은 날 오후, 감사는 반대 방향의 같은 계열 두 번째 실패도 잡았다. 새로 도입된 provenance gate는 에이전트가 작성한 PR에 검증 결과를 PR 본문에 붙이도록 요구한다. 머지 이후 push 이벤트에서는 PR 본문이 없으므로, CI 단계가 빈 파일을 쓰고 게이트는 그 빈값을 "섹션이 없음"으로 읽어 메인 브랜치를 빨간불로 만들었다. 이는 결측을 실패로 읽는 2상 게이트로, 통과로 읽는 것보다 안전하지만 여전히 잘못이다. 해결책은 세 번째 상태를 부여하는 것이었다. 즉, 빈 본문은 "확인할 본문 없음"으로 간주해 unmeasured로 보고하고, CI 단계는 pull-request 이벤트에서만 본문을 쓴다. 두 사건 모두 저장소의 lessons 파일 8.27, 8.28 항목에 기록되어 있고, 테스트도 있다.
그리고 감사는 자기 자신에게도 같은 실수를 저질렀다. CI 내 첫 실행에서 하나의 빨간 기준과 하나의 초록 기준이 나왔는데, 초록이 결함이었다. 빨간 기준은 정직했다. 테스트 러너가 설치되어 있지 않아 테스트를 실행하지 못했고, 실패로 기록했다. 초록 기준은 누적 체크로, 각 카운트를 기준 커밋과 비교한다. CI 체크아웃에는 로컬 메인 브랜치가 없었고, 기준을 찾는 명령이 실패했다. 코드의 폴백은 에러 메시지를 커밋 ID로 간주해 모든 기준 카운트를 0으로 읽었다. 0에서 어떤 값이든 증가이므로 체크는 통과했다. 침묵하는 기본값을 잡으려 만든 도구 안에 침묵하는 기본값이 숨어 있었다. 해결책은 앞의 두 경우와 같다. 테스트 러너가 없으면 "unmeasured", 기준선을 찾을 수 없으면 "unmeasured"로 처리하고, 다섯 개의 유닛 테스트가 이를 고정한다. 이게 lessons 파일 8.29 항목이고, 위에서 감사가 unmeasured를 올려서 통과로 처리하지 못하게 한다고 쓴 이유다.
다섯 번의 왜: 왜 "실행 불가"는 부재가 아니라 게시된 상태여야 하는가
| # | 왜? | 이유 | 증거 |
|---|---|---|---|
| 1 | 게이트에 왜 세 번째 상태가 필요한가? | 2상 게이트에서는 "실행 안 됨"과 "아무것도 없음"이 같은 결과를 내놓기 때문에, 읽는 사람은 둘을 구분할 수 없다. | 실제 사례의 11개 브리프 모두가 "unmeasured"였고, 이는 2026-09-09의 PR 댓글에서 확인했다. 2상 설계였다면 전부 깨끗한 것으로 보였을 것이다. 첫 두 번의 실행은 [17] |
| 2 | 왜 지금이 예전보다 더 심각한가? | 예전엔 알아챘을 사람이 점점 안 본다. 기업 연구에서 커버리지가 89%에서 68%로 떨어졌고, 대부분의 에이전트형 PR은 인간 리뷰를 받지 않는다. | [2, 3] |
| 3 | 왜 세 번째 상태는 로그가 아니라 게시여야 하는가? | 로그에만 남는 상태는 머지 결정 시점에 아무도 읽지 않는다. 방직기는 현장에서 멈추지, 장부에서 멈추지 않는다. | 1896년 방직기의 정지는 곧 감지다 [5]; invisible-red 사건은 실행 로그에만 존재하고 머지 결정이 보는 곳엔 없는 실패를 보여줬다 |
| 4 | 왜 절대 통과로 간주하면 안 되는가? | 기여도 할당이 우연으로 처리되면, 그 원인은 결코 찾아낼 수도, 제거할 수도 없다. "unmeasured"를 "pass"로 올려버린 감사는 실제로 한 번도 실행된 적 없는 루프를 건강하다고 보고하게 된다. | Shewhart의 가설 [10]; 루프 감사는 "AI가 PR을 측정했다"를 의도적으로 unmeasured로 남겨둔다 |
| 5 | 왜 응답 시계가 이 에피소드에 함께 있어야 할까? | 아무도 답하지 않은 PR은 인간 쪽에서의 침묵과 같다. Google의 영업일 하루 규칙과 안돈 코드 모두 같은 메시지를 준다. 매일 누군가가 줄을 당길 때만 라인을 멈출 권리가 실제로 작동한다. | [13, 11]; 첫 실행에서 57시간이 지난 세 개의 PR에 라벨이 붙었다 |
핵심은 한 문장으로 요약된다:게이트가 실행되지 않은 것 자체가 하나의 측정이며, 그 측정이 머지 결정이 내려지는 곳에 게시되지 않는다면, 그 측정은 이루어진 것이 아니다.
30분 만에 만드는 침묵하지 않는 계약
30분은 이 계약을 복사해 적용하는 독자를 위한 예산일 뿐, 내가 실제로 시간을 쟀던 것은 아니다. 세 번째 상태는 리뷰어에 분기 하나와 테스트 하나만 추가하면 되고, 응답 봇은 오전 한나절, 세 가지 사건은 각각 오후 한나절씩 걸렸다.
| 요소 | 명세 |
|---|---|
| 세 가지 상태 | 모든 자동화된 판단은 pass, fail, unmeasured 중 하나를 반환하며, 각 상태마다 PR에 게시되는 출력이 있다. unmeasured는 사유(자격 증명 누락, 401, 거부, 파싱 실패, 해당 이벤트 타입에 입력 없음)를 그대로 담고, 이것이 통과가 아님을 명시하는 문장을 포함한다. |
| 빈 목록도 이유를 담는다 | 보고할 내용이 없어서 비어 있는 섹션은 반드시 그 이유를 밝혀야 한다. 이유 없는 빈 섹션은 계산조차 되지 않은 섹션과 구별할 수 없다. |
| 이벤트 인지 입력 | 게이트의 입력이 이벤트 타입에 따라 다르다면(PR 이벤트에는 본문이 있지만 push에는 없음), "입력 불가"는 unmeasured로 처리해야 하며, fail이나 pass가 되어서는 안 된다. |
| 응답 시계 | (PR, 현재 시각, 정책) 위에서 동작하는 순수 분류기이며, 상태는 ok · needs-first-response · overdue-decision · exempt · draft 중 하나다. 정책은 데이터로서: 첫 응답까지의 시간(시간 단위), 결정까지의 기간(일 단위), 관리자의 목록, 무시할 코멘트 마커, 서면 사유가 있는 면제 목록을 포함한다. 플랫폼 자체 스케줄러의 크론에서 동작한다. 두 개의 라벨, 제목으로 찾는 대시보드 하나를 매번 덮어쓴다. |
| 2분할 규칙 | 봇의 계약이 두 가지 출력(라벨과 보드)을 가진다면, 둘 중 하나만 제공하고 다른 하나를 제공하지 못하면, 누락된 절반을 명시하는 실패로 간주해야 하며, 성공으로 처리해서는 안 된다. |
| 머지 규칙 | 브랜치의 워크플로 실행 결론에 따라 머지하고, 체크 리스트로는 머지하지 않는다. 작업이 0개인 실행이 파일 이름으로 표시된다면, 이는 파싱 실패이며 빨간불이다. |
| 가드 | 모든 워크플로 파일에 빈 표현식이 들어 있으면 실패하는 테스트, 그리고 게이트 스크립트에 자체 테스트가 없으면 실패하는 테스트(에피소드 5). |
| 의도적으로 비워둔 항목 | unmeasured 상태에 대해 재시도하지 않는다. 라벨과 보드 이상의 추가 조치나 페이징도 없다. 이런 경로들은 모두 조용히 실패할 수 있는 여지를 만든다. |
# The classifier is the whole bot; everything else is plumbing.
def classify(pr, now, policy):
    if str(pr.number) in policy["exempt"]:     return "exempt"      # with a written reason
    if pr.is_draft:                             return "draft"
    responses = [t for who, t, body in pr.activities
                 if who in policy["maintainers"] and who != pr.author
                 and not any(m in body for m in policy["ignore_comment_markers"])]
    if not responses:
        return "needs-first-response" if age_h(pr, now) > policy["first_response_h"] else "ok"
    return "overdue-decision" if age_h(pr, now) > policy["decision_days"] * 24 else "ok"

# The merge rule, as a command (the checks list cannot show a parse failure):
# gh run list --workflow ci.yml --branch <branch> --json conclusion   →  merge only on "success"
같은 이야기, 다섯 갈래의 출구
| 독자 | 단 하나의 결정 | 단 하나의 행동 |
|---|---|---|
| 학생 | "불평하지 않았다"는 "확인했다"와는 다르다. | 당신이 신뢰하는 자동화 체크 중 하나를 골라, 실행할 수 없을 때 반드시 무언가를 출력하게 만들어라. |
| 엔지니어 | 세 가지 상태, 각각 게시된다. | 리뷰어에 "unmeasured" 분기를 추가하고, 그 문구를 고정하는 테스트를 만들어라. |
| 창업자 | 응답 시계는 정책 파일과 크론이지, 사람이 아니다. | 첫 응답까지의 시간(시간 단위)과 결정까지의 일수, 그리고 면제 목록을 적고, 플랫폼이 이를 자동으로 돌리게 하라. |
| 임원 | 보이지 않는 실패가 가장 큰 비용을 부른다. | 당신의 머지 결정이 무엇을 근거로 하는지, 그리고 그 표면이 한 번도 시작되지 않은 워크플로를 보여줄 수 있는지 물어보라. |
| 투자자 | 스스로 멈추는 직기가 더 빠르게 짜는 직기보다 더 값지다. | 실제 PR에서 "could not run"을 보고하는 게이트를 팀에게 보여달라고 요청하라. |
패턴, 안티패턴, 그리고 첫 번째 원칙
유지된 패턴. 각 상태에 대해 게시되는 출력이 있는 세 가지 상태. 이유를 명확히 밝히는 빈 목록. 이벤트 유형별로 분류된 입력. 정책 파일을 입력으로 받는 순수 함수형 분류기. 한 번만 덮어쓰는 대시보드. 봇을 실제로 적용하기 전 실행하는 역방향 검증. 투-하프(two-halves) 규칙.
이 패턴이 대체한 안티패턴. 키가 없을 때 기계 게이트만 출력해서 겉보기엔 정상 리뷰처럼 보이던 리뷰어. 제안서에만 존재하고 실제로는 일주일 동안 세 개의 PR이 방치된 서비스 레벨. 중요한 실패를 보여주지 못하는 목록에 의존한 머지 결정. 입력이 없으면 실패로 간주하던 게이트.
이 메커니즘의 이름. 리뷰어와 봇의 모든 코드 경로는 반드시 게시로 끝난다. 부재는 구조적으로 불가능하다. 침묵이 발생할 수 있는 유일한 경우는 플랫폼 자체가 코드 실행 전에 실패할 때뿐이며, 바로 그 상황을 머지 규칙이 다룬다.
첫 번째 원칙, 한 문장으로. 판단을 내릴 수 없었다는 사실 자체가 시스템의 정보이며, 다음 결정을 내리는 곳에 반드시 기록되어야 한다. 침묵은 상태가 아니라 상태의 부재다.
현실 미션
에피소드 1에서 약속한 대로, 에피소드 2까지 응답 봇이 57시간이 지난 세 개의 PR에 대해 실행되었다. 실제로 이 PR들은 라벨이 붙었고, 대시보드에 등재되어 있으며, 대시보드를 만든 실행 내역이 번호와 함께 기록되어 있다. 에피소드 3까지는, 보이지 않는 레드를 잡아낸 루프 감사가 녹색 메인 브랜치에서 다시 실행되어 보고서가 커밋될 것이고, 세 공동창업자 PR은 첫 응답을 받거나, 아니면 대시보드가 여전히 응답이 없다고 표시할 것이다.
다음 읽을 거리
에피소드 2: ANDON · 에이전트형 PR 리뷰와 CI/CD. 모든 수치는 해당 위치에서 범위가 명확히 지정된다. 주방은 모델일 뿐, 측정값이 아니다. 리뷰어, 응답 봇, 루프 감사, 그리고 여기서 설명한 세 가지 사건은 모두 비공개 저장소에 존재한다. 이 구조들은 계약서에 재현되어 있으므로 접근 권한에 의존하지 않는다. 본 에피소드가 인용한 4-수평선 도시는 포트폴리오의 계획 디렉터리에 기록되어 있다.
참고문헌
- GitHub, How pull request limits are cutting down the noise, 2026-06-18. github.blog
- He, Agarwal, Denisov-Blanch, Azaletskiy, Koyejo, Vasilescu, AI가 인간의 리뷰 속도보다 더 빠르게 PR을 작성한다: 엔터프라이즈 2배 명령의 장기적 연구, arXiv:2607.01904, 2026-07-02. arxiv.org
- Duma 외, 이 리뷰는 당신이 찾는 그 리뷰가 아니다, arXiv:2605.02273, 2026-05-04. arxiv.org
- Peralta 외, 에이전트형 PR은 왜 병합되거나 거절되는가?, arXiv:2605.22534, 2026-05-21. arxiv.org
- Toyota Motor Corporation, 도요타 생산 시스템. global.toyota
- Toyota Industries Corporation, Sakichi Toyoda. toyota-industries.com
- Toyota Motor Corporation, 도요타 75년사, Type G. toyota-global.com
- Autonomation, Wikipedia, quoting Ohno 1988, pp. 6, 58. en.wikipedia.org (2차 출처; Ohno의 저서는 입수하지 못했다)
- Best, Neuhauser, Walter A Shewhart, 1924년과 호손 공장, Quality & Safety in Health Care, 2006. pmc.ncbi.nlm.nih.gov
- Shewhart, Economic Control of Quality of Manufactured Product, Van Nostrand, 1931, Postulate 3 (archive.org scan). archive.org
- Toyota UK, TMUK의 25개 오브젝트 – Andon Cord, 2017-12-11. mag.toyota.co.uk
- Rigby, Bird, 동시대 소프트웨어 동료 리뷰 관행의 수렴, ESEC/FSE 2013. users.encs.concordia.ca (저자 사본, 인용문은 재확인함; Microsoft Research 미러는 자동 수집을 거부한다)
- Google Engineering Practices, 코드 리뷰 속도. google.github.io
- Sadowski, Söderberg, Church, Sipko, Bacchelli, 구글의 현대적 코드 리뷰: 사례 연구, ICSE-SEIP 2018, 저자 사본. sback.it
- Anthropic, Code Review, Claude Code documentation. code.claude.com
- Cursor, Bugbot 문서. cursor.com
- Paul Jialiang Wu, AI PR Review That Cannot Lie, 2026-09-08 (리뷰어 설계와 첫 두 번의 실행 기록). futuremake.io