AI-Native 연재 · 에이전트 엔지니어링 비교: 프롬프트 · 컨텍스트 · 하니스 · 루프 · 그래프
프롬프트 엔지니어링은 마법 주문이 아니라 명세다
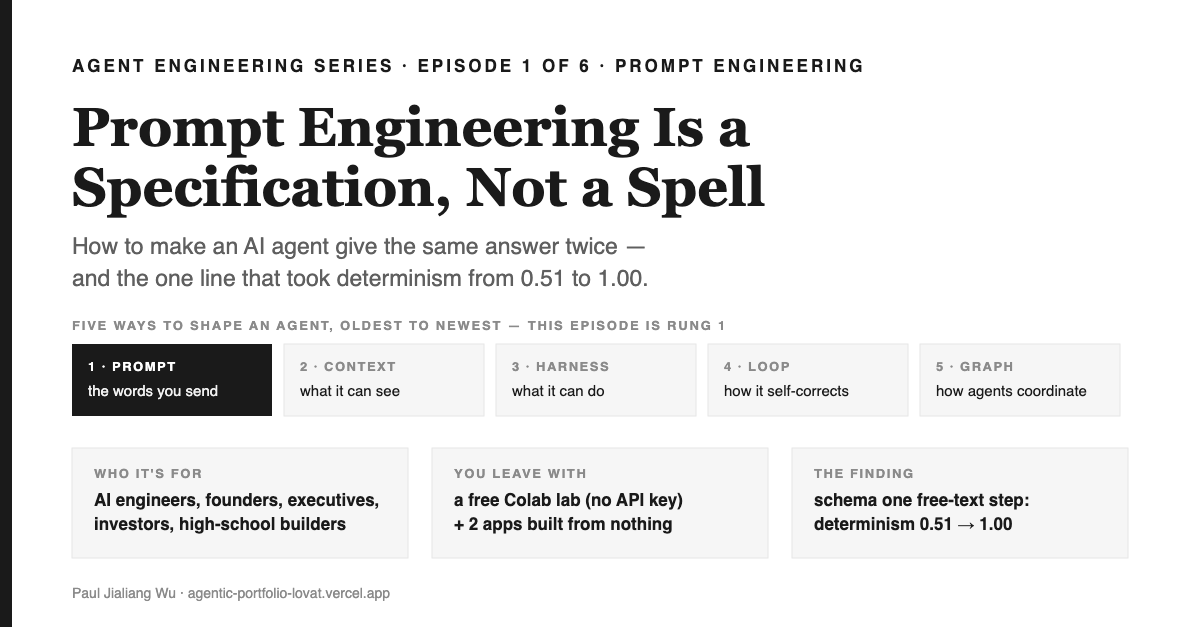
총 6화 중 1화. 이 연재는 AI 에이전트를 설계하는 다섯 가지 방식—프롬프트, 컨텍스트, 하니스, 루프, 그래프 엔지니어링—을 비교한다. 각 방식의 기원, 제어 범위, 주도자, 그리고 실제 측정에서 살아남은 원칙을 다룬다. 이번 편은 가장 오래된 단계인 프롬프트 엔지니어링과, 2026년의 실험에서 아직 이 문제가 완전히 풀리지 않았음을 보여주는 결과를 중심으로 한다.
1분 요약 — 이 글에서 꼭 챙겨갈 핵심
이 글에서 다루는 내용AI 에이전트를 설계하는 다섯 가지 방법을 비교하는 연재다. 프롬프트 엔지니어링(내가 입력하는 문장, 모델이 볼 수 있는 정보, 모델이 할 수 있는 일, 스스로를 어떻게 교정하는지, 그리고 여러 에이전트가 어떻게 협력하는지 — 이 다섯 가지를 각각 프롬프트 엔지니어링, 컨텍스트 엔지니어링, 하니스 엔지니어링, 루프 엔지니어링, 그래프 엔지니어링이라 부른다. 이번 편에서는 프롬프트 엔지니어링을 다룬다. 2020년 GPT-3부터 2026년까지의 역사, 이 분야를 이끄는 주체, 그리고 지금도 유효한 원칙들이 무엇인지 짚는다.
왜 이 문제가 중요한가에이전트는 같은 요청에도 서로 다른 답을 내놓는다. 이 때문에 제품을 고객에게 내놓지 못하고, 감사를 통과하지 못하며, 돈을 맡길 신뢰도 얻지 못한다. 2026년의 한 연구는 그 원인이 프레임워크의 부재가 아니라 딱 한 군데제약 없이 자유롭게 텍스트를 쓰는 단계 때문임을 밝혔다. 그 한 단계를 스키마로 제한하자 100회 실행에서 재현성이 1.000에 도달했다. 네 개 셀 중 세 곳, 두 개의 합성 과제와 두 개의 오픈 웨이트 모델에서 얻은 결과이며, 아직 독립적 재현은 없지만 우리 라우터도 여섯 개의 합성 티켓에서 같은 패턴(0.510 → 1.000)을 재현했다. 창업자에게는 이것이 데모와 제품의 간극이고, 엔지니어라면 오늘 오후에 바로 고칠 수 있는 문제다.
이 글을 읽고 나면 할 수 있는 것프롬프트를 체크 가능한 명세로 작성하고, 동일한 출력을 내는 빈도를 직접 측정해보라. 분산을 일으키는 자유 텍스트 단계를 찾아내어 게이트를 걸면 된다. 별도의 API 키 없이 바로 쓸 수 있는 무료 Colab 노트북과, 처음부터 직접 만든 두 개의 실용 앱이 제공된다. 첫 측정에서 내 명세가 틀렸음을 드러낸 장보기 리스트 생성기, 그리고 결정성이 0.510에서 1.000으로 오르는 IT 변경 요청 라우터(CI 게이트가 미끄러지면 빌드를 실패시킨다)다.
Season 7 — 시리즈 줄기
- 프롬프트 엔지니어링 — 주문이 아니라 명세다 이번 화
- 컨텍스트 엔지니어링 — 더 큰 윈도우가 아니라 예산 2화
- 하니스 엔지니어링 — 에이전트가 아니라 경계선 3화
- 루프 엔지니어링 — 재시도가 아니라 외부 심판 4화
- 그래프 엔지니어링 — 페르소나 출연진이 아닌 일정 5화
- 평가 엔지니어링 — 진리 함수이며, 리더보드는 그 결과일 뿐이다 6화
이번 편에서 다루는 주제와 프롬프트 엔지니어링이 맨 앞에 오는 이유
AI 에이전트를 구축하는 다섯 가지 분야가 이제 이름을 얻었고, 대략 이 순서로 등장했다. 프롬프트 엔지니어링(2020), 루프 엔지니어링(2022), 그래프 엔지니어링(2023), 하니스 엔지니어링(2024), 컨텍스트 엔지니어링(2025). 이 다섯 가지를 가장 명확하게 정리한 것은 Feng 외의 서베이(arXiv:2608.21156)다. 이 논문은 각 분야를 등장 시기가 아니라 각 단계가 실제로 다룰 수 있는 제어 지점 연대순이 아니라, 프롬프트 → 컨텍스트 → 하니스 → 루프 → 그래프 순으로 배열된다. 이 시리즈는 그 순서대로 각 분야를 한 편씩 다루며, 매번 네 가지를 묻는다. 어디서 시작됐는가? 정확히 무엇을 제어하는가? 누가 주도하는가? 그리고 어떤 실패가 다음 단계로 밀어붙이는가?
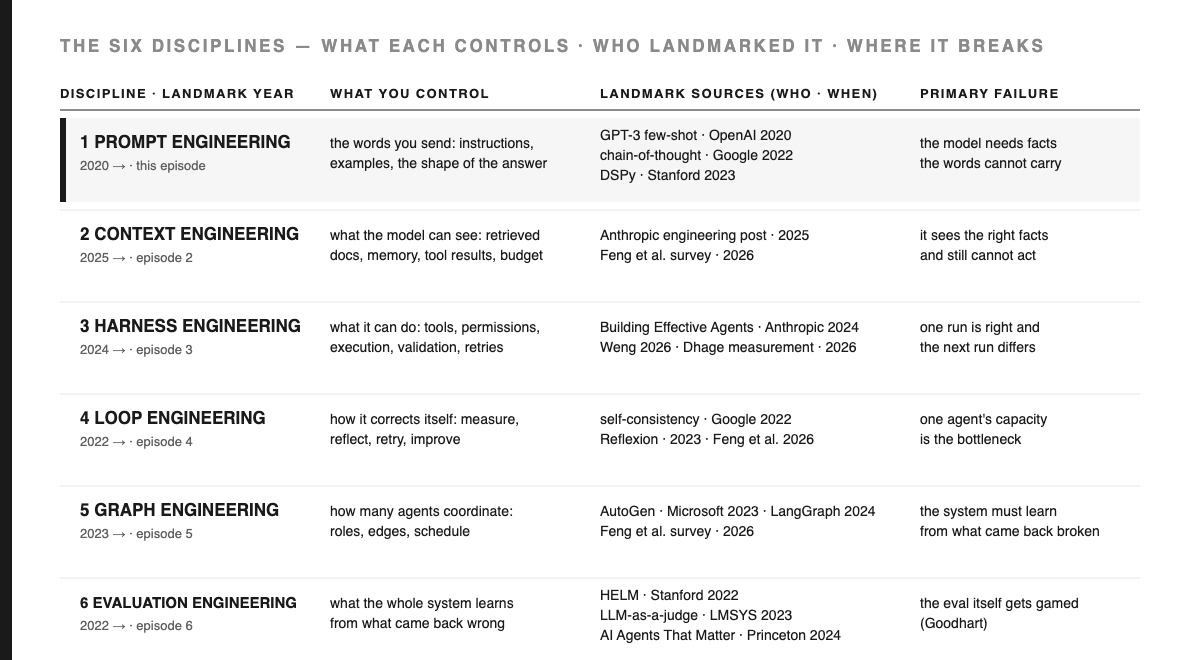
프롬프트 엔지니어링이 가장 먼저 다뤄지는 이유는, 그 위의 모든 단계가 결국 프롬프트의 한계에 의해 결정되기 때문이다. 이번 에피소드의 중심에 있는 2026년의 실측 결과(Dhage, arXiv:2608.26197)는 하니스 — 즉 세 번째 단계 — 가 에이전트의 재현성을 보장할 수 있는지 검증하려 했다. 하지만 실제로 남아 있던 변동성의 원인은, 모델이 여전히 자유롭게 문장을 쓸 수 있었던 단 하나의 지점이었다. 그 프롬프트 단계 하나만 제약하자 하니스로도 해결하지 못한 문제가 사라졌다. 1단계를 건너뛸 수는 없다.
이 글을 읽으면 도움이 될 사람 동일한 입력에 대해 항상 같은 출력을 얻어야 하는 AI 엔지니어, 에이전트 데모가 실제 제품이 될 수 있을지 고민하는 창업자, '프롬프트 엔지니어링'이 신비주의가 아니라 실제로 무엇인지 알고 싶은 고등학생 제작자. 필요한 사전 지식은 언어 모델을 한 번이라도 호출해 본 경험이면 충분하다.
프롬프트 엔지니어링의 기원과 현재 주도 세력
[정의] 프롬프트란 언어 모델에 보내는 텍스트다. 즉, 지시문과 예시, 그리고 원하는 답변의 형태까지 모두 포함한다. 프롬프트 엔지니어링은 그 텍스트를 원하는 결과가 나오도록 작성하는 기술 분야다. 이게 전부다. 역사는 이 기술이 단순한 요령에서 엄밀한 명세로 진화해 온 과정이다.
| 시기 | 주요 사건 | 주체 | 무엇이 달라졌는가 |
|---|---|---|---|
| 2020-05 | GPT-3: Language Models are Few-Shot Learners (arXiv:2005.14165) | Brown 외, OpenAI | 입력에 예시 몇 개만 추가해도 모델의 가중치를 바꾸지 않고 동작을 조정할 수 있다는 사실이 밝혀졌다. 즉, 단어 자체가 제어판 역할을 하게 된 것이다. |
| 2021-02 | Prompt Programming for Large Language Models (arXiv:2102.07350) | Reynolds & McDonell | 예시가 아니라 문제의 틀(프레이밍)이 핵심임을 주장한다. 이 논문에서 "프롬프트 프로그래밍"이라는 용어가 처음으로 학계에 등장한다. |
| 2021-07 | Pre-train, Prompt, and Predict 관련 서베이(arXiv:2107.13586) | Liu et al., Carnegie Mellon | 프롬프트를 파인튜닝과는 구별되는 독자적 패러다임으로 명확히 규정한다. |
| 2022-01 | Chain-of-thought prompting(arXiv:2201.11903) | Wei et al., Google Research, Brain Team | 프롬프트의 문장 패턴 하나만으로도 추론 정확도가 달라진다. 프롬프트가 점차 프로그램처럼 동작하기 시작한다. |
| 2022-03 | Self-consistency(arXiv:2203.11171) | Wang et al., Google | 여러 개의 추론 경로를 샘플링해 다수결로 답을 정한다. 프롬프트에서 루프 구조가 처음 등장한 사례다. |
| 2022-05 | "Let's think step by step"(arXiv:2205.11916) | Kojima et al., University of Tokyo and Google | 마법 주문 시대의 정점: 단 한 문장으로도 측정 가능한 큰 효과를 냈던 시기다. |
| 2022-09 | "Prompt injection" 용어 등장(simonwillison.net) | Simon Willison | 프롬프트는 공격 표면이므로, 마케팅 문구가 아니라 보안 아티팩트로 다뤄야 한다. |
| 2023-03 | 프롬프트 엔지니어링 서베이 (lilianweng.github.io) | Lilian Weng | 프롬프트 관련 기법들이 체계적으로 정리된 지도가 만들어진다. 이 저자는 3년 뒤 하니스 엔지니어링 글도 직접 쓴다. |
| 2023-10 | DSPy (arXiv:2310.03714) | Khattab 외, Stanford | 프롬프트가 선언적 시그니처와 평가 지표에서 자동으로 조합된다. 프롬프트 엔지니어링이 옵티마이저를 갖춘 프롬프트 프로그래밍으로 진화한다. |
| 2024–25 | 주요 모델 연구소의 프롬프트 엔지니어링 가이드 (Anthropic, OpenAI) | 각 모델 연구소 | 실무자들이 공통적으로 따르는 원칙: 명확한 지침, 예시 제공, 구조화된 출력, 추론 과정의 여지, 큰 작업은 체인 호출로 분할. |
| 2025-03 | Promptware Engineering (arXiv:2503.02400) | Chen 외 | 프롬프트를 소프트웨어 아티팩트로 다룬다. 즉, 요구사항 명세, 테스트, 버전 관리, 유지보수까지 포함한다. |
| 2026-08 | 5단계 사다리 (arXiv:2608.21156)와 결정성 연구 (arXiv:2608.26197) | Feng 외; Dhage | 프롬프트 엔지니어링이 다섯 단계 중 첫 번째에 자리하며, 여전히 전체 시스템의 제약 조건임이 실험적으로 확인된다. |
[DESIGN] 그 표에서 눈여겨볼 점이 세 가지 있다. 첫째, 이 분야는 처음부터 '엔지니어링'으로 출발한 것이 아니다. 2020년에 입력에 들어가는 단어만으로도 모델의 동작을 바꿀 수 있다는 사실이 밝혀진 것이 시초였다. 둘째, '마법의 문구' 시대는 2022년에 절정에 달했다가, 2023년 말 Stanford의 DSPy가 수작업 프롬프트를 선언적 시그니처와 옵티마이저로 대체하면서 막을 내렸다. 셋째, 실무자 정전—Anthropic와 OpenAI의 공식 가이드—은 결국 같은 짧은 목록에 수렴했다. 명확하게 지시하고, 예시를 보여주며, 출력 구조를 지정하고, 답을 내리기 전에 모델이 추론할 시간을 주고, 큰 작업은 체인 호출로 쪼갠다. 이 목록 어디에도 주문이나 마법은 없다. 모든 항목이 출력이 검증 가능한 제약 조건이며, 이번 에피소드가 삼는 정의도 바로 이것이다.
지금 이 분야를 이끄는 주체. 현재는 모델 랩(OpenAI, Anthropic, Google)들이 가이드를 내놓고 시스템 프롬프트를 관리한다. Stanford NLP의 DSPy와 소프트웨어 엔지니어링 'promptware' 프로그램은 프롬프트를 버전 관리되고 테스트 가능한 아티팩트로 만들고 있다. 독립 실무자들도 랩의 정직성을 감시한다. Simon Willison은 2022년에 prompt injection이라는 용어를 붙였고, 이 글이 출고되기 전날까지도 Claude의 최신 시스템 프롬프트에 주석을 달고 있었다. 그런데 이번 에피소드의 근거가 되는 측정치는 이들 누구에게서도 나오지 않았다. 출고 3주 전, 단독 저자가 올린 실증 연구가 그 출처다.
이 시리즈를 관통하는 사고 틀: 주방 사다리
여섯 편 전체를 관통하는 이미지는 도구로서 제시한다. 모든 요리사는 같은 사다리를 오른다. 처음엔 자기 자신을 위해 요리하고, 그다음 가족을 위해, 그다음엔 식당 주방에서 일하고, 그다음엔 패스트푸드 체인을 운영하며, 마지막엔 여러 체인을 먹여 살리는 국가 공급망을 책임진다. AI 엔지니어도 마찬가지다. 학생, 주니어 개발자, 시니어 개발자, AI 테크 리드, CTO, 프런티어 리더 순서로 올라간다. 에이전트 엔지니어링의 각 단계는 이 사다리의 한 주방에 해당한다. 1단계는 레시피 카드다. 내가 카드를 쓰고, 말을 섞을 수 없는 요리사가 그걸로 요리한다. 나는 주방에 없고, 중간에 맛을 볼 수도 없다. 내가 원하는 모든 것은 미리 카드에 담아야 하고, 추가 설명은 불가능하다:
2인분 토마토 달걀볶음. 달걀 3개, 토마토 2개, 소금 3g, 설탕 1티스푼. 달걀은 먼저 부드럽게 스크램블해서 팬에서 빼놓고, 그다음 토마토를 넣는다—달걀이 부드럽게 남도록. 12분 안에 식탁에 올릴 것.
이 카드가 곧 프롬프트다. 요리사는 모델이다. 그 위 단계마다 주방의 다른 부분을 건드릴 수 있다. 요리사가 쓰는 식재료와 조리대(컨텍스트), 조리대와 도구, 패스(하니스), 맛보기와 수정(루프), 여러 주방을 먹여 살리는 공급망(그래프)이 그것이다. 이번 에피소드에서 내가 통제할 수 있는 건 오직 카드뿐이다. 식재료도, 도구도, 카드가 넘어간 뒤에 일어나는 일도 내 손을 떠난다.
| 단계 | 주방 역할 | 당신의 위치 | 내가 통제할 수 있는 범위 |
|---|---|---|---|
| 1. 프롬프트 | 레시피 카드 — 자기 자신을 위한 요리 | 학생 | 요리사가 참고하는 서면 지시사항 |
| 2. 컨텍스트 | 식재료 창고 — 가족을 위한 요리 | 주니어 개발자 | 작업 중 조리대와 냉장고에 놓인 모든 것 |
| 3. 하니스 | 식당 주방 | 시니어 개발자 | 각 조리 스테이션, 손 닿는 도구, 모든 접시를 점검하는 패스 |
| 4. 루프 | 패스트푸드 체인 | AI 테크 리드 | 맛을 보고, 측정하고, 수정하며, 모든 매장에 그 수정을 적용한다 |
| 5. 그래프 | 전국 단위 공급망 | CTO | 여러 주방, 하나의 일정표, 하나의 트럭 집합 |
| 6. 평가 | 리콜 로그 | 프론티어 리더 | 전체 식품 시스템이 잘못 돌아온 것에서 배우는 내용 — 6화에서 다룬다 |
축은 하나가 아니다. 두 개다. 표를 곱씹어 보면, 이건 단순히 한 번 오르고 끝나는 사다리가 아니다. 모든 주방에는 여섯 개의 층위가 동시에 존재한다. 집에서 요리하는 사람도 카드, 저장고, 조리도구, 맛보기, 공급자를 모두 갖고 있다. 요리사든 엔지니어든, 올라갈수록 달라지는 건 바로 내가 직접 다룰 수 있는 층위의 수와 각 층위를 얼마나 엄격하게 운영하는가다. 처음엔 감으로 하다가, 점차 측정하고, 게이트를 두고, 자기 교정까지 간다. 장식용 공급망 도식만 있고 맛보기가 없는 전국 체인은, 모든 접시를 저울에 올리는 단일 레스토랑보다 오히려 미성숙하다. 그래서 다섯 가지 공학은 층위 (내가 통제하는 범위)이고, 시니어리티는 성숙도 (내가 그것을 얼마나 엄격하게 운영하는가)다. 그리고 "그래프"가 "루프"보다 무조건 더 고급이라는 뜻은 아니다. 여섯 번째, 아직 열려 있는 층위에는 강력한 후보가 있다 — 평가 엔지니어링, 즉 다른 모든 층위가 개선 여부를 판단하기 위해 빌려 쓰는 진리 함수 — 6화에서 가정이 아니라 논증할 예정이다.
이 비유는 주장을 소개하는 데는 쓸 수 있지만, 결코 증거로 삼을 수 없다. 아래 1:1 기술 맵에서 모든 요소는 코드의 한 지점에 정확히 대응된다. 그리고 이 에피소드는, 아무리 완벽하게 쓴 레시피 카드라도 여전히 다른 요리가 나온다는 사실로 끝난다. 왜냐하면 실제로 조리할 때 조리대 위에 있는 것이 카드만이 아니기 때문이다. 바로 그 지점이 2화의 주제다.
이 사다리는 내 것이 아니다
[정의] 각 용어는 그 출처에 정확히 연결되어 있다. 다섯 개의 이름이 같은 영역을 두고 경쟁하는데, 대부분의 리스트형 글은 이 구성을 잘못 소개한다.
이 사다리를 가장 명확하게 정리한 공식 자료는 Feng 외의 서베이(arXiv:2608.21156, 2026-08-26 개정판)다. 네 단계를 제시한 뒤, 다섯 번째 단계를 추가로 논증한다:"Prompt Engineering to elicit model capabilities, Context Engineering to manage information access, Harness Engineering to organize external tools and resources, and Loop Engineering to support continual reflection and self-improvement"(번역: 프롬프트 엔지니어링은 모델의 능력을 이끌어내고, 컨텍스트 엔지니어링은 정보 접근을 관리하며, 하니스 엔지니어링은 외부 도구와 자원을 조직하고, 루프 엔지니어링은 지속적인 반성과 자기 개선을 지원한다) 그리고 마지막으로 저자들이 System Intelligence라 부르는, 즉 한 에이전트의 조직적 역량이 더 이상 개별 능력이 아니라 전체 시스템의 제약 조건이 되는 지점에서 '그래프 엔지니어링'을 추가한다.
[설계] 흔히 접하는 네 가지 라벨(프롬프트, 하니스, 루프, 그래프)만으로 설명하는 구성이 있다면, 그 방식이 한 단계를 빠뜨리고 있다는 점을 눈여겨봐야 한다. 그리고 그 누락된 단계는 결코 사소하지 않다.여기서 컨텍스트 엔지니어링이 두 번째에 위치한다 — 프롬프트와 하니스 사이에 있으며, 실무자 문헌에서 가장 많은 논의가 이루어진 단계다. 2화는 바로 이 리스트형 글들이 건너뛰는 이 단계를 다룬다.
[열린 질문] 또한 이 서베이가 명시적으로 주장하지 않는 점도 짚고 넘어가야 한다. 각 단계가 이전 단계를 완전히 대체한다는 식의 해석은 라벨들이 암시하는 바지만, 이번 시즌 내내 계속 검증할 대상이다. 지난 시즌 6에서는 중첩(nesting) 구조, 즉 프롬프트가 하니스 안에, 하니스가 루프를 돌리고, 그래프가 여러 루프를 조정한다는 식의 계층 구조를 실제로 검증했다. 그런데 Anthropic의 정의에 따르면 하니스는 루프 그 자체이지, 그 위의 계층이 아니라는 1차 자료에 의해 이 구조가 반박되었다. 이 결론은 여전히 유효하다. 이번 시즌은 다른 질문을 던진다: 한 단계가 실패하면, 그 다음 단계가 진짜 해법이 되는가?
이 주장의 분류
[정의] 프롬프트란 명세다. 단순한 요청도, 주문(incantation)도, '마법의 단어'도 아니다. 산출물이 반드시 충족해야 할 조건을 명확히 적어, 추가 질문이 불가능한 작업자에게 전달하는 문서다.
[근거] 이 정의를 시적 은유가 아니라 말 그대로 받아들여야 하는 이유는, 실제로 누군가가 이를 측정했고 그 결과가 전해 내려오던 통념보다 훨씬 날카로웠기 때문이다.
Dhage의 실증 연구(arXiv:2608.26197, 2026-08-25)는 에이전트에 결정적 실행 계층(유한 상태 제어, 강제 도구 선택, 출력 검증, 제한된 재시도, 구조화된 계획)을 씌우면 재현성이 확보되는지 실험했다. 두 개의 합성 과제(금융, 법률), 두 개의 오픈 웨이트 모델(Qwen-2.5-7B-Instruct, Gemma-3-27B), 네 개의 모델-과제 셀을 대상으로 했다.
첫 번째 실험 결과는 혼란스러웠고, 논문에서도 이를 명확히 밝힌다. 하니스 엔지니어링은 "significantly improves reproducibility in one of four model-task cells, significantly degrades it in two, and has no effect in the fourth."(번역: 네 개의 모델-작업 셀 중 하나에서는 재현성을 크게 높이지만, 두 개에서는 오히려 심각하게 떨어뜨리고, 나머지 하나에는 아무런 영향도 주지 않는다.)
다시 한 번 곱씹어볼 만하다. 네 셀 중 세 곳은 개선이 없거나 오히려 악화됐다. 연구진은 추가 안전장치를 도입했고, 대시보드는 불만을 토로했다. 만약 여기서 멈췄다면, 정직한 결론은 이랬을 것이다.하니스 엔지니어링은 통하지 않는다.
[EVIDENCE] 그런데 트레이스 레벨의 진단이 원인을 찾아냈고, 바로 그 지점이 이 에피소드의 핵심 이유다. 도구 시퀀스, 상태 시퀀스, 출력까지 이미 상당히 일관적인 상황에서, 남아 있던 주요 런 간 변동성의 근원은 바로 제약 없는 자유 텍스트 계획 단계였다. 즉, 파이프라인 어딘가에서 모델이 여전히 산문을 쓸 수 있도록 허용된 단 하나의 지점이 남아 있었다.
그 한 곳만 제약하면 — "validating the plan against a fixed schema before any tool is invoked"(번역: 어떤 도구를 호출하기 전에 계획을 고정된 스키마로 검증하는 것) — "eliminates the effect entirely: three of four cells reach a Reproducibility Rate and Determinism Index of 1.000 at N=100, and task success rises to 100% in three of four cells."(번역: 그 효과가 완전히 사라진다. 네 셀 중 세 곳에서 N=100 기준 재현성 비율과 결정성 지수가 1.000에 도달하고, 작업 성공률도 세 곳에서 100%로 오른다.)
[DERIVATION] 이 발견을 실천 규칙으로 정리하면 이렇다. 아무리 복잡한 상위 단계의 장치도, 시스템 어딘가에 남아 있는 가장 덜 제약된 언어 조각에 의해 한계가 결정된다. 계층을 쌓는다고 결정성이 생기지 않는다. 여전히 자유 텍스트를 내보내는 단 하나의 지점을 찾아내어, 그 부분에 구조를 부여해야만 한다.
이것은 3단계를 증명하려던 사람들이 오히려 1단계에서 발견한 문제이자, 1단계에서 해결할 수 있는 문제다.
[DESIGN] 그리고 비용이 0이 아님을 논문은 분명히 짚고 넘어간다. "token cost falls in every cell, but latency shows a genuine, sample-size-robust split by model — one becomes faster under the constraint, the other markedly slower."(번역: 모든 셀에서 토큰 비용은 줄어들지만, 지연 시간은 모델에 따라 뚜렷하게 갈린다. 한 모델은 제약을 두면 더 빨라지고, 다른 모델은 오히려 현저히 느려진다.) 더 저렴하고, 더 신뢰할 수 있지만, 어떤 모델을 쓰느냐에 따라 오히려 느려질 수도 있다. 논문이 내린 결론이야말로 가져와야 할 요점이다. 하니스 엔지니어링은 실재하는 분야이지만 "but its cost is model-dependent and must be measured, not assumed."(번역: 그러나 그 비용은 모델마다 다르므로 반드시 측정해야 하며, 추정해서는 안 된다.)
[OPEN] 위 모든 논의에는 솔직하게 인정해야 할 한계가 두 가지 있다. 논문은 단 한 편, 두 개의 합성 작업, 7B와 27B 오픈 웨이트 모델 두 개, 독립적 재현 없음. 그리고 '결정성'이라는 목표는 생각보다 낯설다 — 매번 같은 답을 내놓는 시스템이 반드시 올바른 답을 내놓는 것은 아니다. 재현성과 정답성은 서로 다른 축이며, 논문이 두 지표를 모두 측정한 이유는 이 둘이 얼마든지 반대 방향으로 움직일 수 있기 때문이다.
1:1 기술적 대응표
이 비유의 각 요소는 코드에서 정확히 짚어낼 수 있는 구체적인 대상과 1:1로 연결된다. 은유는 논지를 소개하는 데 쓸 수 있지만, 결코 증거로 삼아서는 안 된다. 그래서 여기서는 장식적 표현을 모두 걷어내고, 오직 대응되는 기술적 실체만을 번역해 둔다.
| 주방 | 시스템 | 실제 위치 |
|---|---|---|
| 요리사에게 건네는 레시피 카드 | 프롬프트 — 시스템 메시지와 사용자 메시지 | messages[] |
| "소금 3g" | 검증 가능한 강제 제약 조건 | 경계가 명확히 지정된 스키마 필드 |
| "계란이 부드럽게 남도록" | 그 제약을 둔 이유 | 모델이 실제로 모호함을 해소할 때 참고하는 부분 |
| "12분 안에 식탁에 올릴 것" | 주방에서 절대 양보할 수 없는 마감 시간 | 예산: 토큰 수, 벽시계 기준 시간, 재시도 횟수 |
| "기호에 따라 간 맞추기" — 위 카드에서 의도적으로 쓰지 않은 문구 | 유일하게 자유롭게 작성되는 프리 텍스트 단계 | 트레이스 진단에서 발견된, 제약 없는 계획(플래닝) 필드 |
| 요리사의 판단력 | 당신이 명시하지 않은 모든 것 | 모델의 프라이어 — 결국 당신의 진짜 기본값 |
| 같은 레시피 카드를 써도 요리가 두 가지로 달라진다. | 실행할 때마다 결과가 달라지는 현상 | N번 반복 실행에서 동일한 결과가 나온 비율(재현성 비율) |
| 명세대로 완벽하게 만든 요리지만, 먹는 사람이 알레르기라면 아무 소용 없다. | 명세는 통과했지만, 실제 목적에는 실패했다. | 내가 쓴 단언문이 빠진 부분이 있었다. |
| 패스 — 접시가 나가기 직전의 마지막 검수 | 출력 검증 | 사용 전에 검증하는 JSON 스키마 |
정의이 시즌 전체가 기댈 두 가지 수치, 여기서 한 번만 정의한다.
- 재현성 비율— N번 똑같이 실행했을 때, 완전히 동일한 출력을 내는 비율이다. 품질과는 무관하다. 오직: 두 번 실행해서 결과가 같으면 1, 다르면 0.
- 결정성 지수— 같은 개념을 궤적에 적용한 것. 즉, 최종 답이 아니라 도구 사용 순서, 상태 변화, 출력까지 모두 동일한지를 본다.
이 두 값이 모두 1.000이어도 시스템이 틀릴 수 있다. 이건 지표의 결함이 아니라 의도된 특징이다. 즉, "안정적인가"와 "정답인가"를 분리해주며, 두 번째(정답성)는 반드시 첫 번째(안정성)가 확보된 뒤에야 디버깅할 수 있다.
예측 게이트
스크롤하기 전에 반드시 답을 적어두라. 이 장치의 핵심은, 기록하지 않은 예측은 나중에 스스로 맞췄다고 착각하게 된다는 데 있다.
구조화된 출력을 내는 프롬프트 하나를 고른다. 그 출력이 반드시 만족해야 할 조건을 스무 가지 적는다. 예를 들어, 필드가 모두 있는지, 타입이 올바른지, 열거형 값이 허용 범위 안에 있는지, 길이가 제한을 넘지 않는지 등을 꼼꼼히 적는다. 그런 다음 온도를 0으로 맞추고 100번 실행한다.
Q1. 이 중에서 바이트 단위로 완전히 동일한 출력이 나온 비율은 얼마인가?
Q2. 이제 단 하나의 변화를 준다. 모델이 반드시 먼저 plan을(를) 고정된 스키마에 맞춰 검증받고 나서야 어떤 도구도 호출할 수 있게 한다. Q1에서 구한 비율은 어떻게 달라지는가? 그리고 지연 시간(latency)은 어떻게 변하는가?
Q3.다음 세 가지를, 실행할 때마다 결과가 달라지는 정도를 줄이는 효과가 큰 순서대로 나열하라: (a) 온도를 0으로 낮추기, (b) 프롬프트 텍스트에 명시적 단언문 20개 추가, (c) 자유 텍스트 단계 하나를 스키마로 검증.
정답은 Failure Room과 노트북에 있다. Q3의 순서를 직관적으로 맞췄다면, 이 노트북에 15분 투자할 만하다.
Failure Room
일부러 망가뜨려 보라. 망가뜨릴 수 없는 메커니즘은 그저 주장일 뿐, 진짜 메커니즘이 아니다.
실패 1 — 온도 0은 결정성이 아니다. 이 단계에서 가장 흔히 믿는 이야기지만, 실제로는 사실이 아니다. 온도 0은 sampling을 탐욕적으로 만들 뿐, 시스템을 결정적으로 만들지는 못한다. 그 아래에는 배치 처리, GPU 커널의 비결정성, 도구 결과, 타임스탬프, 검색 순서 등 다양한 변동 요인이 숨어 있다. Dhage의 네 셀 모두 통제된 환경임에도 논문 한 편 분량의 분산이 남았다. 만약 당신의 신뢰성 근거가 "우리는 온도를 0으로 맞췄다"라면, 아직 출발선에도 서지 않은 것이다.
실패 2 — 당신이 쓰지 않은 단언문. 카드에는 3 g salt라고 적혀 있다. 요리사는 정확히 3g을 썼다. 그런데도 음식이 너무 짜다. 당신이 소금만 명시하고, 간장(자체적으로 염분이 있음)은 언급하지 않았기 때문이다. 불완전한 명세는 첫 접시가 나오기 전까지는 항상 완전해 보인다. 그래서 노트북은 반드시 출력을 보기 전에 단언문을 쓰게 한다. 나중에 쓰는 단언문은 그저 결과에 대한 설명일 뿐이다.
실패 3 — 과도한 명세는 당신이 기대한 능력까지 갉아먹는다. 반대로 모든 필드를 제한하고, 모든 일탈을 금지하면, 당신은 매우 비싼 if 명세서를 쓴 셈이 된다. 카드를 그대로 따라 하는데 스테이플러만큼 상상력이 없는 요리사와 다를 바 없다. 요리사의 판단력이야말로 당신이 고용한 것이다. 엔지니어링의 질문은 결코 얼마나 많이 제한할 수 있는가가 아니라어떤 한 비제약 단계가 전체 변동성의 주범인지 — 바로 이 질문에 arXiv:2608.26197의 트레이스 레벨 진단이 감이 아니라 실증적으로 답한다.
실패 4 — 1.000이지만 무의미한 지표재현성을 1.000으로 만드는 가장 손쉬운 방법은 모델이 {}만 반환하게 하는 것이다. 농담이 아니다. 이것이 대부분의 리워드 해킹이 실제로 취하는 방식이다. 어떤 결정성 지표든 반드시 작업 성공률 지표와 나란히 보고되어야 한다. 그렇지 않으면 부정행위의 초대장이 된다. 논문도, 노트북도 두 지표를 모두 함께 제시한다.
Q3의 정답:(c), 그 다음 (b), 마지막이 (a) — 그리고 그 차이는 결코 작지 않다. 자유 텍스트 단계 하나만 스키마로 검증해도 네 셀 중 세 곳이 1.000에 도달한다. 프롬프트 텍스트에 단언문을 추가하면 모델이 더 열심히 시도하긴 하지만, 실제로 체크 가능한 것은 아무것도 늘어나지 않는다. 분산이 측정될 때 이미 temperature 0은 적용된 상태였다.
노트북
실험 01 — 분산, 그리고 그 분산을 없애는 단 하나의 단계 
labs/01_prompt_as_specification.ipynb · Colab 무료 티어 · API 키 필요 없음 · CPU 약 15초 · 모든 셀은 공개 전 미리 실행됨.
총 8개 셀. 워커는결정이 자유 텍스트plan필드에서 파생되는 스텁이다. 바로 이 설계 선택 하나가 실험 전체의 핵심이다. 결정 상류에 자유 텍스트 단계가 있으면, 이는 단순한 표면적 분산이 아니라 결정 자체를 바꾼다.
- 워커는 네 가지 패키징 실패 모드를 의도적으로 플랜과 독립적으로 유지한다. 그래서 진단이 결정이 바뀌었는지와 JSON이 잘못됐는지.
- 를 구분할 수 있다. 단언문들은 출력 전에 스키마로 작성된다.출력 결과를 보기 전에 어떤 결과도 확인하지 않은 상태에서.
- N=100 기준선: 재현성 0.280, 결정성 0.330, 과업 성공률 0.890.
- 제한적 재시도 — 모든 프레임워크가 기본으로 제공하는 한 줄짜리 수정이다. 이로써 과업 성공률이 1.000까지 오른다. 결정성은 0.440.
- 필드별 분산을 추적하는 트레이스 레벨 진단.
plan그리고 그 이후 단계의 결정 필드가 주도적으로 영향을 미친다;ticket_id는 절대 변하지 않는다. - 스윕 — 그리고 반드시 눈여겨봐야 할 셀. 자유 텍스트 단계의 불안정성을 다양하게 조정하며, 두 개 개입의 효과가 어떻게 달라지는지 직접 확인할 수 있다.
- 구조적 계획 — 계획을 미리 제약한다 결정 단계가 그것을 읽기 전에 — 그리고 그 결과 플롯까지.
- 브릿지: 동일한 측정 코드를 어떤 OpenAI 호환 엔드포인트에도 그대로 적용할 수 있다.
[EVIDENCE] 이 실험실을 만들 가치가 있었던 결과는 셀 6에 있다. 내가 초안을 쓸 때 예상했던 것과는 달랐다. 재시도는 어떤 설정에서도 절대 결정성을 낮추지 않는다 — 나는 그럴 것이라 예측했지만, 노트북의 평가는 사전에 써놓지 않고 런타임에 계산되도록 했기에 내 예상을 정면으로 뒤집었다. 실제로 일어나는 일은 훨씬 더 미묘하고, 실용적이다:
| 업스트림 드리프트 | 기준선 | 재시도 | 재시도 효과 | 계획 게이트 |
|---|---|---|---|---|
| 0.00 | 0.885 | 1.000 | +0.115 | 0.885 |
| 0.25 | 0.680 | 0.815 | +0.135 | 0.870 |
| 0.50 | 0.480 | 0.665 | +0.185 | 0.860 |
| 0.75 | 0.340 | 0.440 | +0.100 | 0.875 |
| 1.00 | 0.260 | 0.290 | +0.030 | 0.865 |
상류 단계가 이미 안정적일 때는 재시도가 확실히 이기지만, 문제가 어려워지는 순간 그 이점은 사라진다. 계획 게이트는전 구간에서 평평하다— 증상을 완화하는 대신 원인을 제거하기 때문이다. 이것이 구조적 해결책과 임시 처방의 차이다. 단 하나의 설정에서만 측정하면 이 차이는 완전히 가려진다. 실제로 대부분이 그렇게 측정한다.
[설계]왜 스텁(stub)이지, 실 모델이 아닌가? 시즌 1의 실험실은 원리 검증이 목적이다. "do not pretend a four-action bandit is an LLM"(번역: 네 가지 행동만 하는 밴딧을 LLM인 척하지 말라) 시뮬레이터는분산이 어디서 들어오고 무엇이 그것을 없애는지 몇 초 만에, 무료로, 키 없이 재현한다. 단,규모(크기)는재현하지 않는다. 노트북이 출력하는 어떤 값도 Dhage의 N=100에서 1.000을 입증하지 않는다. 그 수치는 실제 모델에서 측정된 것이고, 논문만이 인용 근거가 된다. 8번 셀은 정직한 다리다 — 환경 변수 두 개만 설정하면 동일한 측정 코드가 실제 엔드포인트에서도 동작한다. 측정 방식은 바뀌지 않는다. 바뀌는 것은 워커뿐이다.
프로젝트
두 가지 빌드, 처음부터 직접 만들었다. 프레임워크도 없고, 표준 라이브러리 외에는 의존성도 없다. 둘 다 같은 아이디어를 전혀 다른 맥락에 적용한 결과물이다. 아래 모든 수치는 이 섹션을 쓰기 전에 실제로 측정한 값이다.
프로젝트 1 — 실전 사례:the-grocery-slip
projects/01-real-grocery-slip/ · python3 measure.py 20
주간 식단표를 장보기 목록으로 바꿔주는 생성기다. 이런 것에 명세를 쓸 생각을 하는 사람은 거의 없다. 그래서야말로 첫 실습에 딱 맞다. 틀려도 아무 손해 없는 상황에서 내 주장(assertion)이 얼마나 불완전한지 바로 드러나기 때문이다.
prompt version : slip-v4
conformance    : 0.700   (14/20 passed every assertion)
reproducibility: 0.450 (identical output share)[증거]세 가지가 망가졌고, README에는 각 문제와 고치기 전의 상태가 기록되어 있다.
1회차 — 내 버그, 모델 탓 아님.적합성(conformance)이0.000로 돌아왔다. 모든 실행이 실패했다. 명세에는0 < qty <= 20단위마다 라고 적혀 있었고, 목록에는500g 당근. 문제는 제약 조건이 너무 빡빡해서가 아니라, 적용된 세분화 기준이 잘못됐기 때문이다. 예를 들어 "한 가구의 일주일치"는 그램으로는 5000, 단으로는 20인데, 이 둘을 하나의 숫자로 묶으면 제약 조건을 흉내만 낸 범주 오류가 된다. 이 부분을 바로잡으니 적합도가 0.700까지 올랐다. 측정 가능한 명세가 내게 처음 알려준 사실은, 명세 자체가 틀렸다는 점이었다. 이게 바로 실전에서 흔히 겪는 일이고, 결과를 신뢰하기 전에 스무 번쯤 돌려봐야 하는 이유다.
7번째 실행 — 이 프로젝트가 반드시 드러내게끔 설계된 허점. 목록에는 milk와 Milk가 서로 다른 두 통로에 있었고, 모든 단언문을 통과했다. 각 항목은 따로 보면 모두 유효했다. 하지만 명세는 요소만 검사했지, 전체 집합은 아예 보지 않았다. 분석 단위가 잘못된 채로 완전하다고 착각한 셈이다. 내 장보기 목록은 모든 테스트를 통과했지만, 정작 장보기에는 실패했다.
11번째 실행 — 흔들림의 순간. 모델이 명세가 허용한 것보다 훨씬 더 나은 목록을 내놓았고, 그 실행이 통과하도록 단언문을 느슨하게 바꾸고 싶은 유혹이 강하게 들었다. 명세가 틀렸다면 반드시 의도적으로, 별도의 커밋에서, 그 이유를 기록하며 바꿔야 한다. 우연히 마음에 든 한 번의 출력을 맞추려고 명세를 고쳐서는 안 된다.
프로젝트 2 — 엔터프라이즈 사례the-change-ticket
projects/01-enterprise-change-ticket/ · make compare · make gate
ITSM 변경 요청 라우터: 자유 텍스트를 입력받아 구조화된 라우팅 결정을 내린다 — 위험 등급, 승인자 그룹, 동결 기간 플래그. 골든 티켓 6개, 각 N=100.
[EVIDENCE] 단 하나의 변수만 바꿨다:
                        WITHOUT plan gate      WITH plan gate
determinism                     0.510                 1.000
conformance                     1.000                 1.000
escalation_recall               1.000                 1.000
make gate exits 0.make gate 구조화된 계획 단계를 빼면 exits 1. 이게 바로 논문의 핵심 결과를 완전히 다른 과제에서 재현한 것이다 — 그리고 개입 없이도 이미 적합도가 1.000이었다. 각각의 개별 결정은 모두 유효했다. 단지 두 번 연속 같은 결정을 내리지 않았을 뿐이고, 이것이 바로 모든 단위 테스트를 통과하는 실패 모드다.
30분 만에 구축하는 계약서
라우터에 필요한 모든 내용을, 엔지니어가 실제로 묻는 순서대로 정리했다. 입력: 자유 텍스트. 출력: 하나의 Decision. 불변 조건: 계획이 스키마를 통과하기 전에는 어떤 결정도 내려지지 않는다. 중단 규칙: 거부된 계획은 에스컬레이션되고, 재시도하지 않는다.
PLAN_SCHEMA = {                       # the "to taste" step, given a shape
  "strategy":   enum["standard","expedited","emergency","reject"],
  "risk_tier":  enum["low","medium","high"],
  "freeze_hit": bool,
  "confidence": number in [0, 1],
}
def route(ticket, prompt_version):
    plan = model.plan(ticket)               # free text → structured plan
    if not validates(plan, PLAN_SCHEMA):    # 1 check, before ANY tool runs
        return escalate(ticket, "plan_rejected", prompt_version)  # no retry
    if plan.confidence < 0.60:
        return escalate(ticket, "low_confidence", prompt_version) # refusal path
    return decide(plan, prompt_version)     # deterministic given the plan

# CI gate (make gate): N=100 per golden ticket
#   determinism       == 1.000   (Decision.key() excludes decided_at)
#   conformance       == 1.000
#   escalation_recall == 1.000   (under-specified tickets escalate in ALL 100)
# any line below threshold → exit 1 → the build fails
일부러 뺀 항목: 거부된 계획에 대한 재시도(결정을 다시 뽑게 됨), 비교 키에 타임스탬프(모든 실행을 고유하게 만들어버림), 그리고 실시간 모델(아무 엔드포인트로 model.plan 어떤 엔드포인트에도 연결할 수 있으며, 측정 코드는 그대로다).
[설계] 이 프로젝트가 단순 데모가 아니라 엔터프라이즈급임을 보여주는 네 가지 핵심 요소가 있다. 각각의 선택에는 분명한 이유가 있다.
- 모든 행동 이전에 구조화된 계획을 세운다. 계획은 네 가지 승인된 라우팅 전략 중 하나를 선택하는 방식이며, 이 선택은 결정이 내려지기 전에 검증된다. 사후 검증은 단지 로그를 정돈하는 데 그친다.
- 거부된 계획에 대해 재시도하지 않는다. 재시도는 새로운 샘플을 뽑는 것과 같다. 계획이 다시 생성되고, 그에 따라 결정도 달라진다. 거부는 '다시 시도'가 아니라 상위로 에스컬레이션하는 것을 의미한다. 노트북의 스윕 결과가 이를 보여주는데, 문제 난이도가 높아질수록 재시도의 효과는 +0.030까지 급격히 줄어든다.
- 거부 경로를 불변 조건으로 강제한다. 두 개의 골든 티켓은 의도적으로 명세가 불완전하게 설계되어 있다. 신뢰도 하한이 0.60 미만일 때 유일하게 허용되는 결과는 지정된 인간에게 에스컬레이션하는 것이다. 그리고
escalation_recall는 에스컬레이션이 100번의 실행에서 모두 만장일치해야만 1.000으로 게이트된다. 단순히 '대부분 그렇다'는 수준이 아니다. - 모든 결정 행에 프롬프트 버전이 기록된다. 3월에 #4471 티켓이 왜 플랫폼으로 라우팅됐는지 묻는 감사인은 재구성 가능한 근거를 요구한다. 이 때문에 프롬프트가 감사 추적의 일부가 되고, 버전 관리되는 아티팩트가 된다. 바로 이 점이 이번 에피소드의 논지가 컴플라이언스 관점에서 도달하는 지점이다.
[설계] 논쟁할 만한 선택이 하나 있다.Decision.key() 에서는 의도적으로 decided_at타임스탬프를 제외한다. 타임스탬프는 결정이 아니라 출처 정보이기 때문이다. 타임스탬프를 포함하면 모든 실행이 무의미하게 유일해지고, 결정성 지표는 영원히 1/N이 된다. 모든 결정성 수치에는 이런 선택이 숨어 있다. 비교 기준에서 무엇을 왜 제외했는지 설명할 수 없다면, 당신은 자신이 무엇을 측정하는지 모르는 것이다.
[열린 질문] 두 프로젝트 모두 증명하지 못한 것이 있다. 두 골든 세트는 모두 합성 데이터이고, 두 워커 모두 기본적으로 스텁이다. 엔터프라이즈 빌드의 솔직한 상태는 실행 가능하며 게이트된(runnable and gated) 상태이지 실제 서비스에 배포되어 측정까지 마친 상태이 빌드를 '진짜'로 만들려면, 실제 라우팅 결과가 남아 있는 과거 티켓에서 추출한 골든 세트와, 결정성 옆에 일치율(agreement rate)을 함께 공개해야 한다. 일치 없는 결정성은, 신뢰성 있게 틀리는 라우터일 뿐이다.
이야기는 같지만, 출구는 다섯 개다
중심은 하나, 그리고 각 독자마다 열리는 문이 하나씩 있다. 한 번의 결정과 한 번의 행동만 가져가고, 나머지는 남겨두라.
| 당신이 만약 | 이번 글이 바꾸는 핵심 결정 | 이번 주에 바로 실천할 수 있는 한 가지 |
|---|---|---|
| 고등학생 빌더라면 | "프롬프트 엔지니어링"은 마법의 주문을 찾는 일이 아니라, 검증 가능한 레시피 카드를 쓰는 일이다. | Colab 실험실을 15초만에 돌려보고(키 불필요), 주방 사다리 비유를 친구 한 명에게 설명해 보라. |
| AI 엔지니어라면 | 결정성은 레이어를 쌓는다고 생기지 않는다. 자유 텍스트로 남아 있는 단 한 단계를 구조화해야 얻을 수 있다. | 위에서 제시한 계약을 당신이 관리하는 프롬프트에 적용해 실제로 돌려보고, N=20에서 게이트를 걸어보라. |
| 창업자라면 | 두 번 요청할 때 답이 달라지는 데모는 제품이 아니다. 이 문제의 해결은 싸고, 측정도 쉽다. | 팀에게 핵심 프롬프트의 재현성 수치를 물어보라. 아무도 대답 못하면, 그게 바로 이번 글의 발견이다. |
| 임원이라면 | 신뢰성은 곧 감사의 대상이다. 어떤 프롬프트 버전이 이 결정을 만들었고, 그 결과가 반복되는가? | 다음 아키텍처 리뷰 때 '모든 결정 행에 프롬프트 버전 기록'을 반드시 추가하라. |
| 투자자라면 | 진짜 해자는 팀이 임대한 모델이 아니라, 측정되고 게이트된 명세에 있다. | 어떤 에이전트 스타트업이든 결정성과 작업 성공률을 함께 물어보라. 둘 중 하나만 있으면 그건 연극이다. |
실전 과제
이번 주에 이미 쓰고 있는 실제 작업을 15분만 투자해 점검해보자.
- 실제로 의존하는 프롬프트 하나—즉, 지금 당신이 실제로 쓰는 것—를 고른다.
- 출력 결과를 보기 전에 반드시 충족해야 할 조건을 미리 적는다. 필드, 타입, 열거형 값, 길이 제한 등, 최소 열 가지 단언문을 목표로 한다. 이 작업이 생각보다 훨씬 어렵다는 사실 자체가 바로 핵심 발견이다.
- 20번 실행해서 단언문 실패 횟수를 센다. 그 숫자를 기록한다.
- 파이프라인 어딘가에 여전히 제약 없이 자유 텍스트를 내보내는 단 하나의 지점—바로 당신의 "season to taste"—를 찾아낸다. 거의 항상 정확히 하나가 있고, 대개 예상과는 다른 곳에 있다.
- 그 한 단계를 스키마로 제한한다. 다시 20번 실행해서 결과를 비교한다.
만약 4단계에서 아무것도 찾지 못했다면, 즉 파이프라인이 계획 단계 없이 한 번의 호출로 끝난다면, 오히려 더 중요한 사실을 알게 된 것이다. 당신은 아직 이 사다리의 첫 칸에도 올라서지 않은 셈이고, 다음 에피소드가 바로 당신을 위한 내용이다.
연구 미션
이 실험을 에이전트에게 맡기고, 실행 전에 반드시 예측을 미리 적어둔다. 예측하지 않은 결과는 반드시 사후에 합리화하게 된다.
arXiv:2608.26197의 구조를 소규모로 재현한다. 체크 가능한 출력이 있는 작업 하나를 고른 뒤, 고정된 설정에서 N=100번의 기준 재현성 비율과 결정성 지수를 측정한다. 그 다음, 단 한 가지 개입만 무작위 순서로 적용한다: (a) 계획 단계를 스키마로 검증, (b) 도구 선택 강제, (c) 재시도 횟수 제한, (d) 출력 검증 추가. 각 개입이 결정성 과 작업 성공률, 그리고 토큰 비용과 지연 시간에 미치는 변화를 보고한다.
사전 등록: 어떤 단일 개입이 효과의 대부분을 가져가는지, 그리고 지연 시간이 두 모델에서 같은 방향으로 움직이는지 예측한다.
논문에서는 구조화된 계획이 가장 큰 효과를 내고, 지연 시간은 모델마다 갈린다고 밝힌다—하나는 빨라지고, 다른 하나는 현저히 느려진다. 확인 전에 반드시 예측을 적어둔다. 만약 당신의 작업에서 다른 순서가 재현된다면, 그것은 3주 된 논문과 출판 가능한 불일치이지, 당신의 셋업에 문제가 있다는 뜻이 아니다.
최근 변화
이 단계의 최신 현황은 30개 개척자 소스의 실시간 주간 피드 동기화로 집계된다.research-anything (make watch-sync기술적 신호만으로 순위가 매겨지며, 대중적 인기도는 반영하지 않는다.
동기화 기준일: 2026-09-03.
- arXiv:2608.26197 (2026-08-25) — 이번 에피소드의 근간이 된 실증 연구. 집필 시점에서 3주 된 논문이다.
- arXiv:2608.21156v2 (2026-08-26 개정) — 다섯 단계 사다리의 명칭을 정리한 서베이로, 흔히 쓰이는 네 단계 분류에서 빠진 '컨텍스트' 단계를 포함한다.
- Simon Willison (2026-09-02) — Claude의 새 시스템 프롬프트는 정말로 노래 가사를 재현하고 싶어하지 않는다: 시스템 프롬프트는 업계에서 가장 많이 읽히면서도, 정작 버전 관리가 거의 이루어지지 않는 산출물로 남아 있다.
- 더 오래됐지만 기반을 이루는 논문들: arXiv:2401.14423 Prompt Design and Engineering; arXiv:2503.02400 Promptware Engineering; Lilian Weng의 Prompt Engineering (2023-03-15), 여전히 해당 단계의 기법을 가장 명확하게 정리한 단일 서베이로 꼽힌다.
[OPEN] 달라지지 않은 점: 아직까지 arXiv:2608.26197의 복제 연구는 발표된 바 없다. 단일 저자가 쓴 한 편의 논문, 두 개의 합성 과제 결과가 이번 에피소드 핵심 주장 전체의 실증적 근거이며, 누군가가 이를 반복해주기 전까지는 그 한계로 읽어야 한다.
자기 점검
위로 스크롤하지 말고, 스스로 답을 적어보라.
- 공개된 다섯 단계를 순서대로 말하고, 대중적인 네 단계 분류에서 빠진 단계가 무엇인지 지적하라.
- 재현률(Reproducibility Rate)과 결정성 지수(Determinism Index)는 어떻게 다르며, 시스템이 둘 다 1.000을 기록하고도 왜 무용지물이 될 수 있는가?
- arXiv:2608.26197에서 1차 하니스 적용이 오히려 재현성을 악화시킨 셀은 네 개 중 몇 개였으며, 어떤 단일 변화가 이를 바로잡았는가?더 악화됨 네 개 셀 중 몇 곳에서였으며, 어떤 한 가지 변화가 이 문제를 해결했는가?
- 노트북이 실제 모델 대신 스텁을 사용하는 이유는 무엇이며, 그 스텁이 하지 않는 근거로 삼아 주장할 수 없는 것은 무엇인가?
- temperature를 0으로 두었으니 파이프라인이 완전히 결정적이라고 들었다고 하자. 이것이 성립하지 않는 이유를 세 가지 들어라.
다음 회 예고
나는 완벽한 레시피 카드를 쓴다.
모든 수치는 명확히 제한되어 있고, 검증도 가능하다. 규칙뿐 아니라 그 이유까지 빠짐없이 적었다. 유일하게 '기호에 따라'였던 부분도 숫자로 바꿨다. 이 카드를 백 번 돌리면 재현성 지표가 1.000을 찍는다. 그날 오후만큼은 주방의 모든 문제가 풀렸다고 믿게 된다.
그리고 같은 카드를 같은 요리사에게 화요일 아침이 아니라 금요일 밤에 건넨다.
이번에는 전혀 다른 요리가 나온다.
카드는 그대로다. 요리사도 변하지 않았다. 달라진 것은 조리대 위에 요리할 때 놓여 있던 것들 — 어젯밤 반쯤 남은 소스, 아직 레일에 꽂혀 있는 다른 테이블 주문서, 소금 옆에 누군가 열어둔 병 같은 것들이다.
카드만이 주방의 전부였던 적은 한 번도 없다.
에피소드 2 — 팬트리. 네 가지 레이블이 건너뛴 바로 그 단계, 출판된 사다리에서는 두 번째에 해당하며, 실제 운영 에이전트에서 가장 값비싼 실패가 벌어지는 곳이다.
이어 읽기
Intelligence Engineering Adventures, 시즌 7 — Intelligence Engineering Adventures, Season 7 — The Kitchen Ladder. 이 시리즈의 출처는 정의, 도출, 증거, 엔지니어링 선택, 오픈 퀘스천 등으로 구분해 태그한다. 비유는 주장을 소개할 수 있지만, 그 자체로 증거가 되지는 않는다. 각 에피소드에는 Colab 무료 티어에서 API 키 없이 바로 실행할 수 있는 노트북과, 처음부터 직접 만든 두 개의 애플리케이션(하나는 개인용, 하나는 엔터프라이즈용)이 함께 제공된다. 이 사다리의 원저자는 Feng 외(arXiv:2608.21156)이며, 내 창작이 아니다. 'what moved' 섹션은 30개 선구적 소스를 기술적 신호만으로 주간 동기화해 생성하며, 대중적 인기와는 무관하다. 본 기사에는 어떤 고용주나 클라이언트의 자료도 전혀 포함되어 있지 않다. — Paul Jialiang Wu · futuremake.io
참고문헌
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2, 2026-08-26 개정. — 다섯 단계 사다리, "The ladder is not mine"에서 인용된 원문.
- Dhage, S. (2026). Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197, 2026-08-25. — 1-of-4 / 2-of-4 1차 결과, 트레이스 레벨 진단, 그리고 Structured Planning이 네 셀 중 세 곳에서 N=100에서 1.000에 도달한 사례.
- Chen, B., Zhang, Z., Langrené, N. et al. (2023). Unleashing the potential of prompt engineering for large language models. arXiv:2310.14735. — 기법 서베이.
- Amatriain, X. (2024). Prompt Design and Engineering: Introduction and Advanced Methods. arXiv:2401.14423.
- Chen, Z., Wang, C. et al. (2025). Promptware Engineering: Software Engineering for Prompt-Enabled Systems. arXiv:2503.02400. — "프롬프트는 소프트웨어 아티팩트다"라는 논지 전체.
- Weng, L. (2023). Prompt Engineering. lilianweng.github.io, 2023-03-15. — 그리고 같은 저자의 Harness Engineering for Self-Improvement (2026-07-04): 한 명의 저자가 세 개의 단계를 7년에 걸쳐 탐구했다.
- Willison, S. (2026-09-02). Claude's new system prompt really doesn't want to reproduce song lyrics. simonwillison.net.
- Brown, T. B., Mann, B. 등 (2020). Language Models are Few-Shot Learners. arXiv:2005.14165. — 연표에서 2020년을 대표하는 논문이다.
- Reynolds, L., McDonell, K. (2021). Prompt Programming for Large Language Models: Beyond the Few-Shot Paradigm. arXiv:2102.07350.
- Liu, P., Yuan, W. 등 (2021). Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing. arXiv:2107.13586.
- Wei, J., Wang, X. 등 (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. arXiv:2201.11903.
- Wang, X., Wei, J. 등 (2022). Self-Consistency Improves Chain of Thought Reasoning in Language Models. arXiv:2203.11171.
- Kojima, T., Gu, S. S. 등 (2022). Large Language Models are Zero-Shot Reasoners. arXiv:2205.11916.
- Willison, S. (2022-09-12). Prompt injection attacks against GPT-3. simonwillison.net.
- Khattab, O., Singhvi, A. et al. (2023). DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714.
- Shinn, N., Cassano, F. et al. (2023). Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366. — 시리즈 표에서 루프 엔지니어링의 기준점으로 삼은 논문.
- Wu, Q., Bansal, G. et al. (2023). AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation. arXiv:2308.08155. — 시리즈 표에서 그래프 엔지니어링의 기준점으로 인용; LangGraph: github.com/langchain-ai/langgraph.
- Anthropic (2024-12-19). Building Effective AI Agents. anthropic.com/engineering. — 시리즈 표에서 하니스 엔지니어링의 기준점.
- Anthropic (2025-09-29). Effective context engineering for AI agents. anthropic.com/engineering. — 시리즈 표에서 컨텍스트 엔지니어링의 기준점.
- 히스토리 표에서 인용 없이 서술된 프롬프트 엔지니어링 가이드: Anthropic · OpenAI.
- Liang, P., Bommasani, R. et al. (2022). Holistic Evaluation of Language Models. arXiv:2211.09110. — 이 표에서 평가 엔지니어링의 대표 논문이다.
- Zheng, L., Chiang, W.-L. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. arXiv:2306.05685. — 이 표에서 평가 엔지니어링의 대표 논문이다.
- Kapoor, S., Stroebl, B. et al. (2024). AI Agents That Matter. arXiv:2407.01502. — 이 표에서 평가 엔지니어링의 대표 논문이다.
- Intelligence Engineering Adventures, Season 6 — The Governor Engine, 에피소드 1, 3 — 네스팅 도식이 실제로는 성립하지 않으며, 이 다섯 가지 레이블 중 어느 것도 안정성을 표현하지 못한다는 논증을 담았다.