AI-Native 연재 — 에이전트 엔지니어링 비교: 프롬프트, 컨텍스트, 하니스, 루프, 그래프
평가 엔지니어링: 진리 함수, 리더보드가 아니다
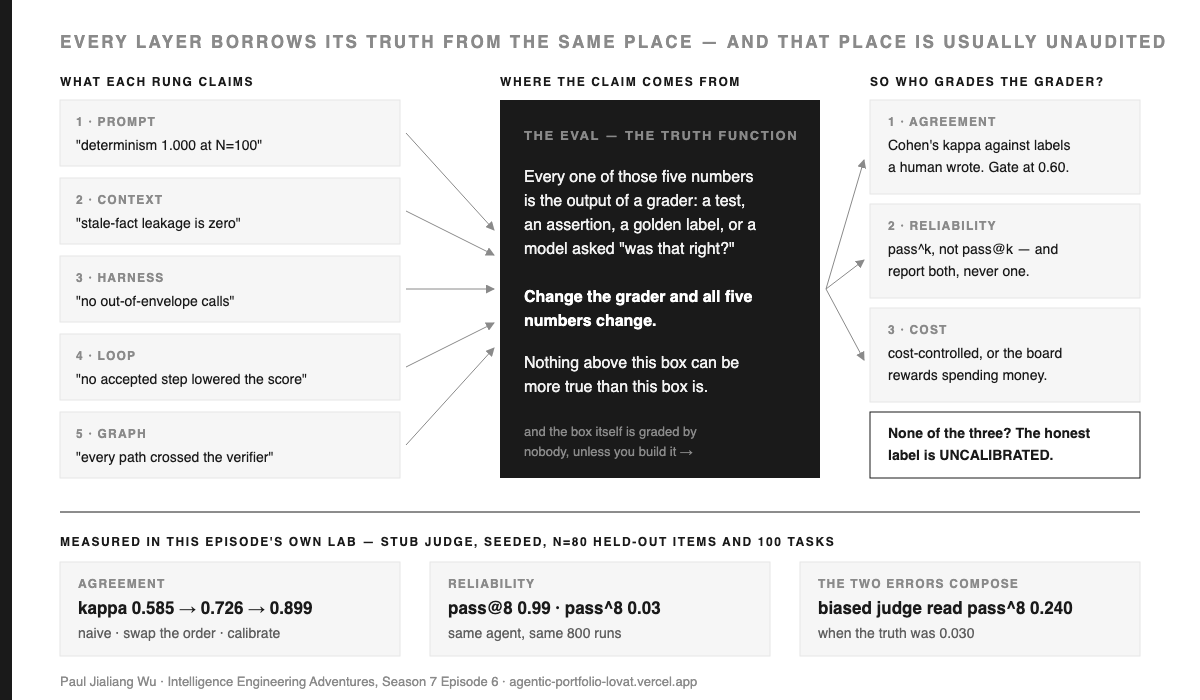
이번 연재의 마지막 글이다. 앞선 다섯 편은 각각 결정성 1.000, 유출 0, 봉투 밖 호출 없음 등 하나의 수치로 끝났다. 그리고 그 모든 수치는 아무도 감사를 하지 않은 채점자에서 나왔다. 이번 편은 채점자를 평가하는 계층이며, 사다리의 여섯 번째 칸을 지금까지 비워둔 이유이기도 하다.
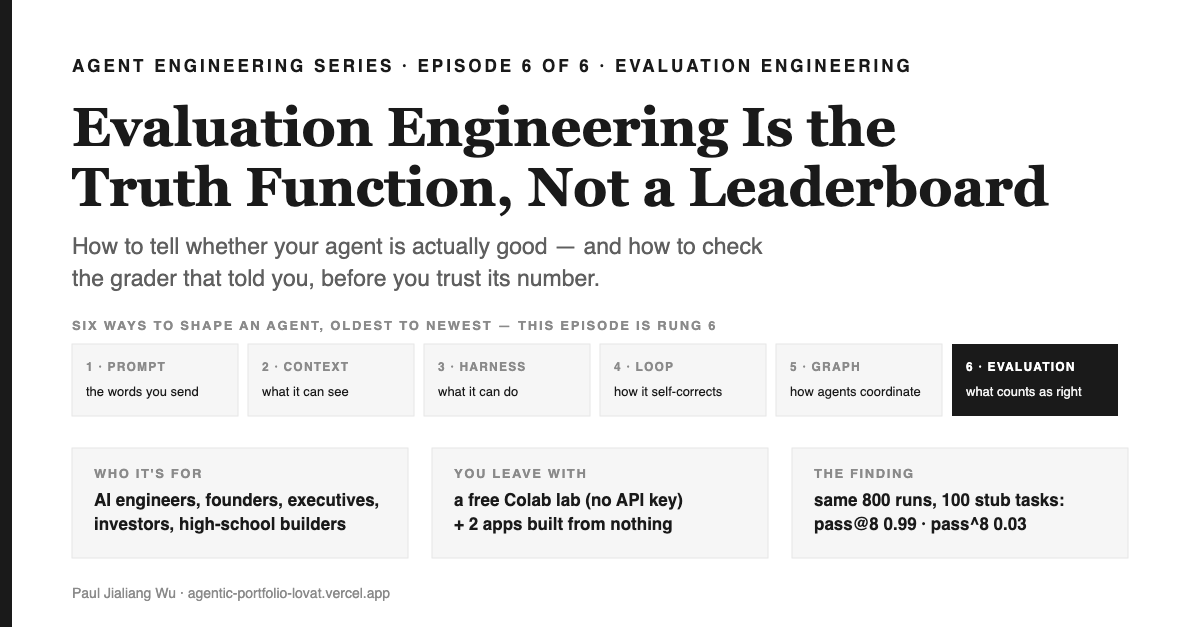
1분 요약 — 이 글에서 얻을 핵심
이 글의 성격AI 에이전트 개발의 여섯 가지 방법을 비교하는 연재의 마지막 편이다. 프롬프트 엔지니어링(보내는 단어), 컨텍스트 엔지니어링(에이전트가 볼 수 있는 정보), 하니스 엔지니어링(에이전트가 할 수 있는 범위), 루프 엔지니어링(스스로 수정하는 구조), 그래프 엔지니어링(여러 에이전트의 협력 구조), 그리고 평가 엔지니어링(무엇이 정답으로 간주되는가). 이번 글에서는 2022년 HELM부터 지난달 판정 벤치마크까지, 평가 엔지니어링의 역사와 이를 주도하는 집단, 그리고 측정 이후에도 살아남은 원칙들을 다룬다.
왜 이 주제가 중요한가. 여러분의 팀이 AI 시스템에 대해 인용하는 모든 수치—정확도, 결정성, 패스율, "평가가 초록불이다"—는 모두 채점자의 산출물이다. 그런데 채점자를 실제로 측정하는 경우는 거의 없다. 이번 글의 실험에서는 한 판정자가 80개의 홀드아웃 항목에 대해 Cohen의 kappa를 0.585 기록했고, 0.899 두 번의 간단한 수정만으로 판정자 자체는 바꾸지 않은 채 이 수치에 도달했다. 그리고 한 에이전트의 800번 실행 결과는 pass@8 = 0.99 또는 pass^8 = 0.03 으로, 오직 리포팅 방식만 다를 뿐 이렇게 달라진다. 창업자에게는 이 차이가 곧 메트릭과 환불의 간극이고, 엔지니어에게는 오늘 오후에 바로 적용할 수 있는 검증 게이트다.
이 글을 읽고 나서 할 수 있는 실천. 에이전트의 출력 20개를 직접 손으로 라벨링하고, 채점자와의 일치도를 먼저 측정하라. 그다음에야 채점자의 결과를 신뢰할 수 있다. 별도 API 키 없이 표준 라이브러리만으로 동작하는 무료 Colab 노트북과, 처음부터 만든 두 가지 앱도 제공한다: 내가 실제로 지키지 않은 습관을 68% 연속 성공했다고 판정한 습관 추적기 리포트 카드, 그리고 측정되지 않은 항목이 패스로 처리되면 CI 검증이 실패(exit 1)하는 감사 벤치.
Season 7 — 시리즈 줄기
- 프롬프트 엔지니어링 — 주문이 아니라 명세다 1화
- 컨텍스트 엔지니어링 — 더 큰 윈도우가 아니라 예산 2화
- 하니스 엔지니어링 — 에이전트가 아니라 경계선 3화
- 루프 엔지니어링 — 재시도가 아니라 외부 심판 4화
- 그래프 엔지니어링 — 페르소나 출연진이 아닌 일정 5화
- 평가 엔지니어링 — 진리 함수이며, 리더보드는 그 결과일 뿐이다 이번 화
이번 글에서 다루는 주제와, 왜 평가 엔지니어링이 여섯 번째 계단이 되었는지
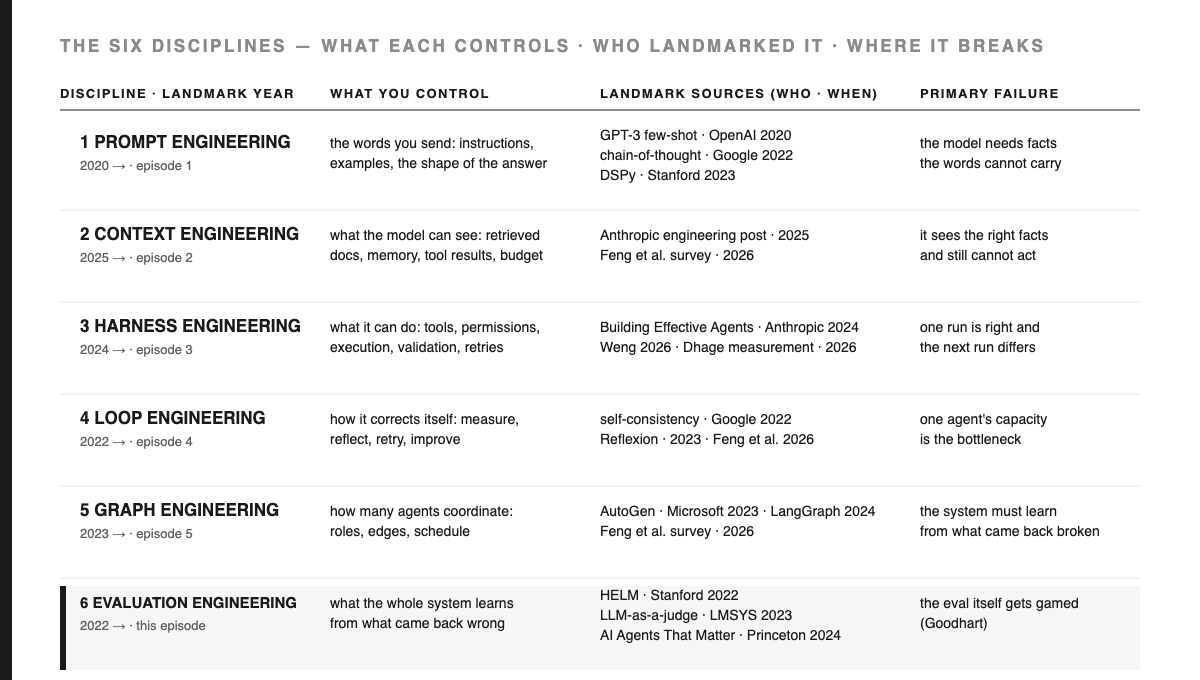
이번 시즌에서는 AI 에이전트 구축을 위한 여섯 가지 명확히 구분된 엔지니어링 분야를 비교했다. 다섯 분야는 이미 출판되어 연도까지 특정할 수 있다 — 프롬프트(2020), 루프(2022), 그래프(2023), 하니스(2024), 컨텍스트(2025). Feng 등(arXiv:2608.21156)은 각 분야가 무엇을 통제할 수 있게 하는지에 따라 순서를 정했다. 즉, 프롬프트, 컨텍스트, 하니스, 루프, 그래프 순이며, 이 순서가 이번 시즌의 글 전개 순서이기도 하다. 단, 각 분야가 등장한 연도 순서와는 다르다. 여섯 번째 행은??? 첫 글부터 매번 표에 빈칸으로 남겨 두었다.
[DESIGN] 그 이유를 한 번은 명확히 기록해 둔다. 2026-09-03에 1편이 공개되었을 때, 외부 리뷰어가 여섯 번째, 아직 비워둔 레이어는평가 엔지니어링이어야 한다고 제안했다. 이는 다른 모든 레이어가 자신이 개선되었는지 판단할 때 근거로 삼는 진리 함수이며, 그 이면에는 거버넌스, 경제, 조직이 놓여 있다. 1편에서는 이 제안을후보로 기록하고, 결정은 내게 남겼다. 논증 없이 계단을 명명하는 것은 이 시리즈가 피하려 했던 피상적 나열에 불과하기 때문이다. 이제 논증이 갖춰졌으니, 여기서 선언한다:여섯 번째 계단은 평가 엔지니어링이다. 이름이 비워져 있었던 이유는, 한 분야가 자신의 자리를 얻으려면 바로 아래 계단을 넘어야 하고, 아래 계단들이 먼저 존재해야만 그 사실을 증명할 수 있기 때문이다.
각 글마다 해당 계단에 네 가지 질문을 던졌다: 어디서 비롯되었는가, 무엇을 통제하는가, 누가 주도하는가, 어떤 실패가 다음 단계로 밀어올리는가. 이번에는 다섯 번째 질문이 추가된다. 그래서 이 글이 부록이 아니라 결론이 된다:앞선 다섯 분야가 실제로 작동했다는 사실은 무엇이, 어떻게 증명해줬는가?
이 글을 읽어야 할 사람 CI는 초록불인데 사용자는 불만인 AI 엔지니어, 벤치마크 수치를 발표 자료에 넣으려는 창업자, 실제 금전이 오가는 에이전트에 최종 승인하는 임원, "평가"가 무엇인지 궁금한 고등학생 개발자. 전제 조건: 숫자를 한 번이라도 믿어본 경험이 있는 사람.
평가 엔지니어링의 기원과, 현재 이를 이끄는 주체
[DEF] 평가(eval)는 Anthropic의 정의에 따르면,"a test for an AI system: give an AI an input, then apply grading logic to its output to measure success"(번역: AI 시스템을 평가하는 시험: AI에 입력을 주고, 그 출력에 채점 논리를 적용하여 성공 여부를 측정하는 것) — 이 정의가 옳은 이유는 채점 논리를 내부에 두기 때문이다. 옆에 두는 것이 아니다.평가 엔지니어링은 이 채점 논리를 신뢰할 수 있도록 설계하고, 그 채점 논리 자체를 측정하는 학문이다. 바로 이 부분을 거의 모든 사람이 생략한다.
| 시기 | 전환점 | 주도자 | 무엇이 달라졌는가 |
|---|---|---|---|
| 2022-11 | HELM: Holistic Evaluation of Language Models (arXiv:2211.09110) | Liang 외, Stanford CRFM | HELM 이전에는 모델이 평균적으로 핵심 시나리오의 17.9%만 평가되었다. 이후에는 표준화된 조건에서 96.0%까지 평가되었고, 정확도 하나가 아니라 7가지 지표로 측정되었다. 평가가 인프라로 자리 잡았다. |
| 2023-06 | Judging LLM-as-a-Judge (arXiv:2306.05685) | Zheng 외, LMSYS / UC Berkeley | 강력한 모델은 개방형 답변을 인간 수준에 가까운 합의도로 채점할 수 있다. 동시에 위치, 장황함, 자기 강화 편향 등 측정 가능하고 완화 가능한 편향을 지닌다. 채점자가 연구의 대상이 되었다. |
| 2023-07 | A Survey on Evaluation of Large Language Models (arXiv:2307.03109) | Chang 외 | 이 분야를 무엇을 평가할지, 무엇을 그리고 어떤 방식으로를 체계적으로 정리하며, 평가를 하나의 독립된 공학 분야로 다루어야 한다고 분명히 주장한다. |
| 2023-10 | SWE-bench (arXiv:2310.06770) | Jimenez et al., Princeton | 실제 GitHub 이슈에서 추출한 2,294개 과제를, 해당 저장소의 자체 테스트가 통과하는지로 판정한다. 유사도 점수 대신 실행 오라클을 도입했다. 당시 최고 성능 모델의 해결률은 1.96%에 불과했다. |
| 2024-03 | Your AI Product Needs Evals (hamel.dev) | Hamel Husain | 실무자라면 반드시 읽어야 할 표준서. 실패한 LLM 제품은 "almost always share a common root cause: a failure to create robust evaluation systems"(번역: 거의 항상 견고한 평가 시스템을 구축하지 못했다는 공통된 근본 원인을 가진다.)고, 그 해법은 단위 테스트, 인간·모델 평가, A/B 테스트로 이어지는 3단계 계층 구조다. |
| 2024-06 | τ-bench (arXiv:2406.12045) | Yao et al., Sierra | pass^k를 도입했다. 즉, k번의 시도 모두에서 성공해야 통과로 인정한다. 한 번이라도 통과하면 되는 기존 방식은 실제 배포가 불가능한 에이전트까지 과대평가하는 문제가 있었기 때문이다. |
| 2024-07 | AI Agents That Matter (arXiv:2407.01502) | Kapoor et al., Princeton | 비용은 반드시 평가 지표에 포함되어야 하며, 홀드아웃 세트는 대체로 불충분하거나 아예 없는 경우가 많다. 벤치마크와 실제 배포 환경의 요구는 다르다는 점을 지적한다. 현행 에이전트 평가 실무에 대한 가장 널리 인용되는 비판이다. |
| 2023–26 | OpenAI Evals (github.com/openai/evals)와 공개 평가장 (lmarena.ai) | OpenAI; LMSYS / LMArena | Evals는 이제 테스트를 등록할 수 있는 프레임워크이자, 실시간 크라우드소싱 기반의 순위 시스템으로 자리 잡았다. 이 두 곳 모두 Goodhart의 법칙이 실제로 작동하는 현장이기도 하다. |
| 2026-01 | Demystifying evals for AI agents (anthropic.com/engineering) | Anthropic | Evals는 논문이 아니라 CI의 일부로 다뤄진다: "Automated evals are especially useful pre-launch and in CI/CD, running on each agent change and model upgrade as the first line of defense against quality problems."(번역: 자동화된 평가는 출시 전과 CI/CD 환경에서 특히 유용하다. 에이전트가 변경되거나 모델이 업그레이드될 때마다 실행되어 품질 문제에 대한 1차 방어선 역할을 한다.) |
| 2026-08 | 채점자 벤치마크 (arXiv:2608.26623)와 오염 분류 체계 (arXiv:2608.29463) | Verma et al.; Angulo et al. | 출간 3주 전: 이제 채점자 자체가 벤치마크 대상이 되었고, 오염은 각 완화책을 무력화하는 방식으로 체계적으로 분류된다. |
[DESIGN] 저 목록에 없는 것을 주목해야 한다. 리더보드는 빠져 있다. 채점자 역시 에이전트와 마찬가지로 완전 일치, 유사도 점수, 실행 오라클, 모델의 단계를 밟으며, 단계마다 커버리지를 넓히는 대신 확실성을 일부 포기한다. 리더보드는 결과일 뿐이고, 진짜 공학은 그 뒤에서 작동하는 시스템에 있다. 이 둘 중 실제로 스크린샷이 남는 것은 하나뿐이다.
현재 이 분야를 이끄는 주체 학계에서는 Princeton(Kapoor, Narayanan, Jimenez), Stanford CRFM, LMSYS/LMArena가 비판적 논의를 주도한다. 실무는 연구소가 이끈다. Anthropic은 evals를 CI의 일부로 운영하고, OpenAI는 테스트 등록 프레임워크를 배포한다. 그리고 가장 최근의 변화는 채점자 자체를 연구 대상으로 삼는 빠르게 성장하는 문헌이다 — AgentJudgeBench, 음성 에이전트와 모바일 에이전트 채점자 연구가 대표적이다. 불과 2년 전만 해도 존재하지 않았으니, 이 여섯 번째 계층이 실제로 자리를 잡았음을 보여주는 가장 분명한 신호다.
개념적 모델: 리콜 로그
이 시리즈 전체를 관통하는 한 장의 그림이 있다. 마지막으로 이 그림을 꺼내 본다. 모든 요리사는 자신, 가족, 레스토랑 주방, 패스트푸드 체인, 여러 체인을 아우르는 국가 공급망까지 점차 더 넓은 무대로 올라간다. AI 엔지니어도 마찬가지다. 학생, 주니어 개발자, 시니어 개발자, AI 테크 리드, CTO, 그리고 최전선의 리더로 성장한다. 첫 번째 단계는 레시피 카드였다. 여섯 번째 단계는 리콜 로그.
국가 식품 시스템은 아무 문제 없던 접시에서 배우지 않는다. 잘못된 결과에서 배운다 — 사람을 아프게 만든 불량 배치, 라벨과 다른 기름을 납품한 공급업체. 리콜 로그만이 시스템 전체가 만들어낸 수치가 잘못되었음을 공식적으로 선언할 수 있는 유일한 문서다.
그리고 이 로그에는 누구도 달가워하지 않는 속성이 있다. 리콜 로그가 비어 있다는 사실은 두 가지 경우 중 하나를 뜻하며, 그중 진짜 좋은 경우는 하나뿐이다. 음식이 정말 안전하거나, 아무도 검증하지 않고 있다는 뜻이다. 로그 안에서 보면 두 상황은 구분되지 않는다 — 그래서 초록색 대시보드는 결코 증거가 아니다.
| 단계 | 주방 | 나의 역할 | 이 단계에서 바꿀 수 있는 것 |
|---|---|---|---|
| 1. 프롬프트 | 레시피 카드 — 나를 위한 요리 | 학생 | 요리사가 참고하는 글로 된 지침 |
| 2. 컨텍스트 | 팬트리 — 가족을 위한 요리 | 주니어 개발자 | 요리하는 동안 조리대와 냉장고에 놓인 모든 재료 |
| 3. 하니스 | 레스토랑 주방 | 시니어 개발자 | 각 스테이션, 손이 닿는 도구, 모든 접시를 점검하는 패스 |
| 4. 루프 | 패스트푸드 체인 | AI 테크 리드 | 맛을 보고, 측정하고, 수정한 뒤, 모든 매장에 그 수정을 적용한다 |
| 5. 그래프 | 전국 단위 공급망 | CTO | 여러 주방을 하나의 일정과 하나의 운송망으로 연결한다 |
| 6. 평가 | 리콜 기록 | 프런티어 리더 | 전체 식품 시스템이 잘못된 결과에서 얻는 교훈 |
축은 하나가 아니라 둘이다.모든 주방은 여섯 가지 계층을 동시에 운용한다. 집에서 요리하는 사람도 레시피 카드, 식재료 저장고, 조리도구, 맛보기, 공급업체, 그리고 누군가 탈이 났던 요리의 기억까지 모두 갖춘다. 계층을 올라갈수록 달라지는 것은 내가 직접 다룰 수 있는 계층의 수와 각 계층을 얼마나 엄밀하게 운영하는가이다. 처음에는 감으로 하다가, 점차 측정하고, 기준선을 두고, 자기 교정까지 이르게 된다. 이 여섯 가지는 내가 통제하는 계층이고, 경력의 단계는 성숙도— 즉, 각 계층을 얼마나 체계적으로 운영하는가로 구분된다. 평가는 그래프보다 더 고차원적이지 않다. 예를 들어, 보정된 골든셋을 갖춘 3노드 그래프가, 데모만 잘 돌아가는 40에이전트 토폴로지보다 더 성숙한 것이다. 이 점이 특히 중요하다. 평가 엔지니어링은 다른 모든 영역에서 정교한 팀조차 가장 자주 성숙도 0으로 운영하는 계층이기 때문이다.
이 비유는 논지를 소개할 수는 있지만, 그 자체가 증거가 될 수는 없다. 결정적 근거는 아래의 일대일 대응표에 있다.
주요 용어와 그 출처
[DEF]여기서 핵심이 되는 네 가지 용어가 있다. 그중 세 가지는 실제로는 반대 의미로도 자주 쓰인다.
- 골든 세트 — 결과를 사람이 직접 기록한 입력값을 의미한다. 이는 모델이 생성하고 당신이 대충 훑어본 출력이 아니다. 골든 레이블의 본질은, 시스템의 결과와 불일치할 때에도 사람이 쓴 정답이 이길 수 있다는 점이다.
- 채점자 — 평가 로직 전반을 가리킨다. 문자열 비교, 어설션, 테스트 스위트, 혹은 "정답인가?"라고 묻는 모델 호출까지 모두 포함된다. Zheng 등은 마지막 방식 역시 실용적이며, 측정 가능한 편향을 지닌다는 점을 보였다. 이 두 측면 모두가 핵심이다.
- Cohen의 카파(κ) — 두 명의 라벨러가 우연을 넘어서 얼마나 일치하는지를 나타낸다. 단순 일치율은 지표가 아니다. 이번 글의 첫 실험에서 동전 던지기는 고정된 목록과 47.7% 일치(κ = −0.046)를 기록했다. 관례적 κ 구간은 Landis와 Koch(1977)에서 제시한 임의의 벤치마크일 뿐, 도출된 값이 아니다. 논문은 유료라 인용 대신 설명만 한다. 나는 엔지니어링 기준선으로 κ ≥ 0.60을 쓴다. 이는 이 구간이 그들의 "상당함(substantial)"이 시작되는 지점이기 때문이지, 0.60이 세계의 어떤 본질적 사실이기 때문은 아니다.
- pass@k와 pass^k — k번 시도에서 한 번이라도 성공한 경우와, k번 모두 성공한 경우를 구분한다. Yao 등은 τ-bench에서 후자를 도입했다. 최첨단 함수 호출 에이전트조차 "quite inconsistent (pass^8 <25% in retail)"(번역: 실제 환경에서 pass^8이 25% 미만일 정도로 일관성이 떨어진다).
[OPEN] 내가 의도적으로 정의하지 않는 표현이 하나 있다: "the eval passed". 이 말은 골든 세트가 무엇인지, 무엇으로 평가했는지, 어떻게 보고했는지, k값은 무엇인지, 사람과의 일치율은 얼마인지 밝히기 전까지 아무 의미도 없다. 이 다섯 가지를 모두 답하면 그 표현이 필요 없고, 답하지 않으면 그 표현이 바로 허점을 숨긴다.
주장, 분류별로
[DEF] 평가 엔지니어링은 진리 함수다. 다른 모든 계층의 자기주장은 이 계층의 출력에 의존한다. 따라서 당신 시스템의 정확도는 채점자의 정확도에 의해 상한이 결정된다. 이는 자의 오차가 측정값의 오차를 제한하는 것과 같다.
[EVIDENCE] 세 가지 출판된 측정 결과가 이 사실을 수치로 뒷받침한다.
첫째 — 채점자가 결과에 영향을 미치고 있으며, 그 영향이 실제로 측정되었다. Zheng 등(arXiv:2306.05685, v4)은 "the usage and limitations of LLM-as-a-judge, including position, verbosity, and self-enhancement biases, as well as limited reasoning ability"(번역: LLM을 판정자로 쓸 때 발생하는 위치, 장황함, 자기강화 편향과 제한된 추론 능력 등, 판정자의 활용 방식과 한계) 그리고 긍정적인 측정 결과도 함께 제시했다: 강력한 판정자는 "can match both controlled and crowdsourced human preferences well, achieving over 80% agreement, the same level of agreement between humans."(번역: 통제된 환경과 크라우드소싱된 인간 선호 모두와 80% 이상의 합의율로 잘 일치할 수 있으며, 이는 인간들끼리의 합의 수준과 같다.) 이 두 결과가 곧 핵심이다. 판정자는 사람만큼 신뢰할 수 있지만, 어떤 답을 먼저 보여주느냐에 따라 결과가 달라진다. 전반부만 받아들인 팀은 측정되지 않은 도구에 명성만 기대는 셈이다.
둘째 — 보고 규칙은 대부분의 모델 업그레이드보다 더 큰 영향력을 가진다. Yao 등(arXiv:2406.12045)은 최첨단 함수 호출 에이전트들—추상적으로는 gpt-4o—이 "succeed on <50% of the tasks, and are quite inconsistent (pass^8 <25% in retail)"(번역: 전체 과제의 절반도 성공하지 못하고, 일관성도 매우 낮다(pass^8이 실제 환경에서 25% 미만임))는 사실을 밝혔고, 일관성이 평균에 묻히지 않도록 pass^k를 도입했다. pass@8과 pass^8 사이에서 에이전트 자체는 변하지 않는다. 바뀌는 것은 동일한 실험에 대해 어떤 질문을 던졌는가뿐이다.
셋째 — 벤치마크는 실제로 중요한 것과 점점 멀어진다. Kapoor 등(arXiv:2407.01502)은 세 논문 중 가장 불편한데, 그 어떤 결과도 모델 자체에 관한 것이 아니다. 여기에는 "a narrow focus on accuracy without attention to other metrics"(번역: 정확도에만 좁게 집중하고, 다른 지표는 고려하지 않는다)는 점이 있고, 그 결과 "SOTA agents are needlessly complex and costly, and the community has reached mistaken conclusions about the sources of accuracy gains."(번역: SOTA 에이전트들은 불필요하게 복잡하고 비용이 많이 들며, 커뮤니티는 정확도 향상의 원인에 대해 잘못된 결론에 도달했다.) 그리고 가장 치명적인 문제는 다음과 같다: "many agent benchmarks have inadequate holdout sets, and sometimes none at all"(번역: 많은 에이전트 벤치마크가 부적절한 홀드아웃 세트를 가지고 있거나, 아예 없는 경우도 있다)는 점이며, 이로 인해 에이전트들은 "fragile because they take shortcuts and overfit to the benchmark in various ways."(번역: 다양한 방식으로 지름길을 택하거나 벤치마크에 과적합되어 취약해진다.)
[DERIVATION] 이 세 가지를 합치면, 바로 이 글이 존재하는 이유이자 핵심 원칙이 도출된다. 보고된 점수는 단일 측정값이 아니라, 세 가지가 합성된 결과다 — 에이전트의 동작, 판정자가 인간과 얼마나 일치하는지, 그리고 반복 실험에서 어떤 보고 규칙을 적용했는지다. 우리가 보는 것은 첫 번째뿐이고, 그것이 전부라고 들을 뿐이다. 에이전트를 5% 개선하고 판정자는 그대로 두면, 점수는 어느 방향으로 얼마나 변할지 알 수 없다.
지난달 공개된 오염 분류 체계 역시 리더보드의 시각에서 같은 결론을 내린다. 벤치마크 점수란 모델, 하니스, 유도 예산, 샘플링된 집단, 오염 상태라는 다섯 요소의 결합된 속성이다 — 그리고 "Leaderboards publish the model and the score, so capability and leakage stay observationally equivalent"(번역: 리더보드는 모델과 점수만을 공개하므로, 실제 성능과 정보 유출이 관찰상 구별되지 않는다) (arXiv:2608.29463). 다섯 입력 중 두 가지만 공개된다. 이것이 바로 이번 글의 제목이 설명하는 이유다.
일대일 기술적 대응표
리콜 로그의 각 요소는 코드에서 구체적으로 지목할 수 있는 대상과 일대일로 연결된다.
| 리콜 로그 | 시스템 | 존재 위치 |
|---|---|---|
| 문제가 있어 회수된 배치 | 실패한 항목 | 골든셋의 한 행 |
| 출하 전에 '문제'의 기준을 미리 정의해둔 파일 | 골든 라벨 | 사람이 직접 작성한 고정 데이터 |
| 배치의 이상 여부를 판정하는 검사관 | 채점자(판정자) | 테스트, 단언문, 혹은 모델 호출 |
| 한 번도 주방을 불합격 처리한 적 없는 검사관 | 퇴화된 채점자 | 합격률 100%에서 κ = 0.000 |
| 같은 주방을 다시 방문한 두 번째 검사관 | 합치도 측정 | 사람이 부여한 라벨과의 Cohen의 κ |
| 화요일에 한 번, 금요일에 다시 방문하기 | 순서를 바꿔 두 번 채점하기 | 두 순서 모두에서 채점한 뒤, 점수를 평균한다 |
| 검사관이 어느 쪽도 판정하지 못하는 배치 | 측정되지 않은 항목 | UNMEASURED — 제외, 절대 합격으로 간주하지 않음 |
| 여덟 번 방문 중 한 번의 불량 사례 | 여러 번 시행에서의 신뢰도 | pass^k, 이 아니라 pass@k |
| 검사 기준에 맞춰 학습하는 체인 | 벤치마크 과적합 | 홀드아웃 세트 없음 (Kapoor 등) |
| 비어 있는 리콜 로그 | 신호 없음, 또는 테스트 자체가 없음 | 커버리지: 측정된 항목 수를 채점된 항목 수로 나눈 값 |
[정의] 이 한 줄은 별도의 단락이 필요하다 — 두 프로젝트 모두 이 불변식 위에 세워졌고, 내 연구 역시 이미 이 원칙을 따른다: 증거가 없다는 것은 측정되지 않았다는 뜻이며, 그리고 그것은 결코 합격을 의미하지 않는다. 채점자가 판정하지 못한 항목은 아슬아슬한 성공이 아니라 정보의 부재다. 정직하게 기록하면 제3의 상태가 된다. 이 상태가 없는 시스템은 더 정확해지지 않는다. 조용히, 보고하는 사람에게 유리하게 관대해질 뿐이다.
예측 판정 게이트
스크롤을 내리기 전에, 먼저 스스로 답을 생각해보라. 당신의 채점자가 100개 전체 항목 중 79개에서 당신이 직접 라벨링한 값과 일치한다. 이때 20개의 보정 항목은 홀드아웃된다.
Q1. 이때 Cohen의 카파 값은 대략 얼마인가? 그리고 79% 일치는 충분히 좋은가?
Q2. 채점자 자체는 바꾸지 않고, 모든 항목을 두 번씩 보여준다 — 한 번은 후보가 먼저, 한 번은 후보가 두 번째로 — 그리고 평균을 낸다. 이때 카파 값은 어떻게 변하고, 100개 중 몇 개가 순서에 따라 판정이 바뀌는가?
Q3. 한 에이전트가 100개의 작업을 각각 성공 확률 0.25~0.95로 8회씩 수행한다. 크기 순서대로 나열하라: pass@1, pass@8, pass^8.
Q4. 당신의 채점자가 한 방향으로 고정된 편향을 가진 경우, 이 편향이 실제로 측정된 pass@8와(과) pass^8 중 어느 쪽에 더 큰 영향을 미칠까?
정답은 '실패 분석실'에 있다. Q4가 너무 당연하게 느껴졌다면, 노트북의 8번 셀에 4분만 투자해 보라.
실패 분석실
일부러 망가뜨려 보라. 깨뜨릴 수 없는 메커니즘은, 그 자체로 검증되지 않은 주장일 뿐이다.
실패 사례 1 — 개별 판정은 틀렸는데 집계값만 그럴듯한 경우. 이 실험실의 단순 채점자는 골든 기준 0.510에 대해 0.720의 패스율을 보고하고, 100개 중 79개에서 인간과 일치했다. 둘 다 그럴듯해 보이지만, 카파는 0.576(전체 100개 기준; 홀드아웃 80개에서는 0.585)로, 그 일치의 상당 부분은 우연이었다. 집계값이 진실에 가까워 보여도, 그 아래 개별 판정들이 심각하게 잘못될 수 있고, 실제로 시스템이 내보내는 것은 바로 그 판정들이다. 일치율 없는 패스율은 소문에 소수점만 붙인 것과 다름없다.
실패 사례 2 — 어떤 것도 실패로 처리하지 않는 채점자. 나는 의도적으로 모든 항목에 대해 PASS만 반환하는 채점자를 만들었다. 패스율 1.000, 카파는 정확히 0.000. 한 번도 주방을 불합격시킨 적 없는 식품 검사관과 같다 — 완벽한 기록이지만, 그래서 그곳에서 식사하면 안 되는 이유다. 이건 허수아비 논리가 아니다. 대시보드 수치가 좋아질 때까지 임계값만 조정한 모든 채점기의 극한 사례다. 나 역시 그런 채점기를 만들어 봤고, 내부에서는 진짜 개선된 것처럼 느껴진다.
실패 사례 3 — Episode 1의 빈 접시는 여전히 메뉴에 남아 있다. Episode 1은 매번 {}을 반환하는 에이전트로 끝났고, 그 결과 재현성 지표는 1.000을 기록했다. 다섯 편이 지난 지금, 그 빈 접시는 이번 편의 감사 벤치도 통과한다. 벤치의 자체 규칙이 그 이유를 설명한다: 빈 답변은 결코 판정할 수 없으므로, 모든 항목이 UNMEASURED 상태로 기록된다 — 그리고 make negative 이 거부를 위해 존재하는 플래그가 바로 UNMEASURED 를 분모가 아닌 분자로 옮긴다. {}는 이제 여섯 개의 주방을 모두 통과했다; 시즌 내내 가장 성공한 에이전트지만, 한 번도 출력을 내놓은 적이 없다. 모든 지표는 그것을 극대화하는 퇴행 입력을 허용하며, 그 방어책은 결코 더 나은 지표가 아니다 — 반드시 필요한 것은 그 퇴행 입력을 무력화하는 두 번째 지표다. 결정성은 작업 성공률 옆에, 패스율은 카파 옆에, 커버리지는 둘 다 옆에 두어야 한다.
실패 사례 4 — 한 편향을 고치면 다른 편향이 드러나 오히려 퇴보처럼 보일 수 있다. 이 때문에 실험실을 다시 설계해야 했다. 첫 버전에서는 각 항목의 위치를 무작위로 섞었는데, 순서를 바꿔 평가하니 카파가 0.820에서 0.780으로 떨어졌다. 무작위 위치 오프셋이 장황성 오프셋을 일부 상쇄하고 있었기 때문이다. 반대 방향의 두 오류가 합쳐지면 정확해 보인다. 만약 수정 후 지표가 더 나빠진다면, 첫 번째로 의심해야 할 것은 수정이 잘못됐다는 것이 아니라, 당신의 지표가 두 번째 오류에 의해 미화되고 있었다는 점이다.
실패 사례 5 — 검사 기준에 맞춰 시스템이 학습되는 현상.Goodhart의 원래 논지는 1975년 화폐 집계에 관한 글(1984년 재출간)에서 출발한다. 통계적 규칙성도 통제의 목표가 되는 순간 깨진다는 주장이다. 대다수가 인용하는 간결한 표현은 Marilyn Strathern이 1997년 대학 감사 제도에 대해 정식화한 문장이다. 두 논문 모두 유료로 잠겨 있어 직접 인용 대신 요약만 제공한다. 에이전트 규모에서 이 논의는 실증적으로 측정된다. 지난달의 오염 분류 체계(arXiv:2608.29463)는 오염 유형별로 어떤 완화책이 무력화되는지 기준으로 정리했고, 사설 테스트 세트는 다섯 유형 중 첫 번째만 방어할 수 있다. 골든 세트 역시 누군가가 내용을 읽고 나서 에이전트를 작성하는 순간 동일한 오염에 노출된다.
정답 해설. Q1:κ ≈ 0.58 — 79% 일치율은 충분하지 않다. 동전만 던져도 약 50%는 우연히 맞는다.Q2:카파는 전체 100개 항목에서 0.780(이 글의 나머지에서 인용하는 80개 홀드아웃 항목에서는 0.726)까지 상승한다.100개 중 50개항목의 판정이 순서에 따라 뒤바뀐다. 즉, 채점된 항목의 절반이 자리 배치에 의해 결정된 셈이다.Q3:pass@8 (0.99) > pass@1 (0.57) > pass^8 (0.03).Q4:pass^k는 차이가 훨씬 크다. k번 모두 성공해야 하므로, 한 방향으로 치우친 편향은 평균화되지 않고 누적된다. 예를 들어, 길이 편향이 있는 채점자는 실제 값이 0.030임에도 pass^8을 0.240으로 읽었다.
노트북
Lab 06 — 진리 함수: 채점자 드리프트와 pass^k. 
06_eval_truth_function.ipynb· Colab 무료 버전 ·API 키 불필요· 표준 라이브러리만 사용 · 시드 고정SEED=20260911· CPU 약 2초 소요 · 모든 셀은 출판 전 실행됨. 요약본(gist)에도 두 프로젝트가 모두 포함되어 있다:gist.github.com/wjlgatech/752a9450…
아홉 개 셀. 이 실험을 실행할 가치가 있는 이유는, 채점자가 verdict(판정)가 아니라score만을 산출하고, 편향은 가산적 오프셋으로 더해진다는 점이다. 이는 교육용 단순화가 아니라, 각 보정이 어디서 비롯됐는지 추적 가능하게 하며, 이름 붙일 수 있는 오프셋은 상쇄하고 남은 값을 확인할 수 있게 한다.
- Cohen의 카파: 정답이 알려진 두 입력에서 확인 — 동일 입력(1.000)과 독립 동전(−0.046, 단순 일치율 47.7%).
- 골든 세트: 숨겨진 품질, 사람이 직접 부여한 라벨, 그리고 품질과 독립적인 두 속성(길이와 슬롯)을 가진 100개 항목으로 구성된다.설계상 독립적으로.
- 채점자: 위치 편향 ±0.30, 장황함 편향 ±0.12, 노이즈 ±0.08. 순진한 판정κ 0.576, 골든 세트 기준 0.510에 대해 pass rate 0.720.
- 순서를 바꿔 두 번 채점하고 평균을 낸다. 양쪽 순서로 모두 채점한 뒤 평균을 내면, 한쪽은 +d, 다른 쪽은 −d의 편향이 적용되어 정확히 상쇄된다. 100개 중 50개 항목이 순서에 따라 판정이 뒤집힌다. κ 값은 전체 100개 항목에서 0.780까지 오르고(홀드아웃 80개에서는 0.726), 장황성 편향은 의도적으로 그대로 두었다. 남은 오차가 수정이 정밀하게 이루어졌음을 보여준다.
- 보정용 세트 — 사람이 직접 라벨링한 20개 항목으로, 학습이 아니라 골든 라벨을 고정한 채 길이 편향을 추정하는 데 쓴다. 실제 +0.240에 대해 +0.259가 측정된다.
- 동일한 80개 홀드아웃 항목에서, 게이트를 적용한 세 가지 평가 체제.
- pass@k와 pass^k를 k = 1, 2, 4, 8에 대해 비교 — 100개 과제, 각 8회 반복.
- 두 가지 오류가 합성된 결과: 동일한 실험을 편향 없는 판정자, 편향된 판정자, 보정된 판정자가 각각 채점한 결과.
- 굿하트 항목: 항상 PASS를 반환하는 판정자, 그리고 1화의
{}에이전트가 마지막으로 등장한다.
[EVIDENCE] 이 글의 나머지 논의가 근거로 삼는 두 개의 표, 실제 실행 결과로 출력된 것이다:
held-out items: 80   (the 20 calibration items are excluded)
judge                      kappa     agree  measured pass
naive, one pass            0.585     64/80          0.738
+ swapped position         0.726     69/80          0.475
+ calibration set          0.899     76/80          0.537
golden labels (truth)      1.000     80/80          0.537
  gate kappa >= 0.60: naive, one pass        FAIL  (0.585)
  gate kappa >= 0.60: + swapped position     PASS  (0.726)
  gate kappa >= 0.60: + calibration set      PASS  (0.899)

100 tasks, k=8 trials each, per-task success probability drawn in [0.25, 0.95]
  k    pass@k    pass^k       gap
  1     0.570     0.570     0.000
  2     0.750     0.360     0.390
  4     0.900     0.120     0.780
  8     0.990     0.030     0.960
두 번의 간단한 조치만으로 판정자는 변경 없이 κ가 0.585에서 0.899까지 상승한다. 그리고 아래: 동일한 에이전트, 동일한 800회 실행이 0.990 또는 0.030으로 보고된다. 둘 다 사실이지만, 실제 사용자가 경험하는 것은 오직 하나뿐이다.
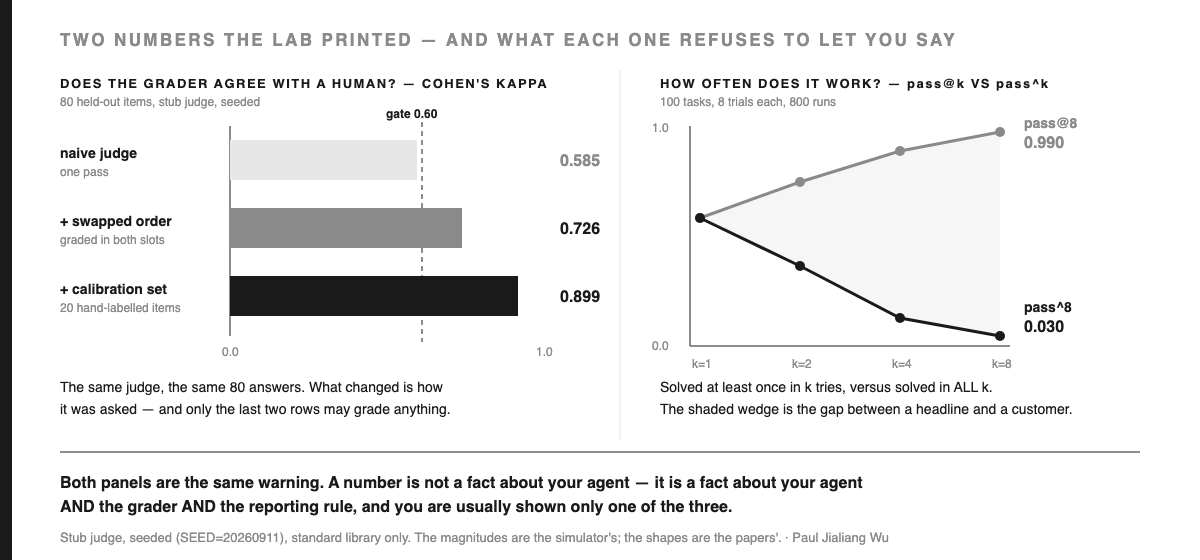
[DESIGN] 왜 스텁이고 실제 모델이 아닌가? 시뮬레이터는 오류가 어디서 유입되고 무엇이 그것을 제거하는지 를 몇 초 만에, 무료로, API 키 없이 재현한다. 단, 실제 수치와는 다르다 : 출력되는 값은 Zheng et al.의 80% 일치율이나 τ-bench의 pass^8 25% 미만처럼 실제 시스템에서 측정된 수치의 증거가 아니다. 그런 수치는 논문에서만 인용할 수 있다. 실제 환경과의 간극은 짧다 — judge_score() 를 OpenAI 호환 엔드포인트로 한 번만 교체하면 나머지는 그대로 동작한다. 측정 코드는 자신이 무엇을 평가하는지 알지 못한다.
프로젝트
표준 라이브러리만으로, 아무런 사전 준비 없이 두 가지 프로젝트를 구현했다. 이 섹션을 작성하기 전에 모두 직접 실행했으므로, 여기 나오는 모든 수치는 예측이 아니라 실제 측정 결과다.
프로젝트 1 — 현실 사례:the-report-card
p1_report_card.py · python3 p1_report_card.py
습관 추적기는 하루에 한 줄씩 기록하고, 채점자가 이를 읽어 내가 습관을 지켰는지 판정한다. 나는 60일치 데이터를 직접 손으로 라벨링했다. 여기서 핵심 질문은 내 에이전트의 성능이 얼마나 뛰어난가가 아니라, 내 에이전트의 성능을 평가한 그 채점자의 정확도가 얼마나 되는가.
the-report-card - grading the grader of a habit tracker
  golden set        : 60 days labelled by hand
  calibration       : 10 days re-read, 50 days graded
  note-length offset: estimated +0.284, true +0.320

  grader                     kappa    gate   measured streak
  before calibration         0.572    FAIL             0.680
  + swapped batch order      0.797    PASS             0.400
  + 10-day calibration       0.960    PASS             0.440
  my own labels              1.000       —             0.460
[EVIDENCE] 앱은 내가 전체 중 68% 일 동안 습관을 지켰다고 판정했다. 실제로 내가 지킨 날은 46%일이었다. 앱의 판정은 실제와 달랐고, 그 방향이 내게 유리했기에 나는 한 번도 검증하지 않았다. 나는 예의 바른 반올림 오류에 스스로 만족하고 있었던 셈이다.
이 두 가지 왜곡은 Zheng 등 논문에서 지적한 바이어스가 일상에 적용된 사례다. 트래커는 최신 기록을 먼저 보여주기 때문에, 같은 기록도 목록의 맨 위에 있으면 점수가 더 높게 나온다: 위치 바이어스. 숫자가 포함된 메모 — "5.2km 달림" — 는 "달리기 함"보다 실제 여부와 상관없이 더 신뢰할 만한 것으로 간주된다: 장황성 바이어스. 10일을 다시 손으로 검토해본 결과, 두 번째 바이어스는 실제 +0.320에 대해 +0.284로 추정됐다.
프로젝트 2 — 조직 환경:the-audit-bench
p2_audit_bench.py · make report · make gate · make negative
지원 티켓 120건에 대해, 결과를 사람이 직접 기록했고, 지원 해결 에이전트가 이를 평가했다. 24건은 보정용으로 분리하고, 96건을 채점했다. 하니스는 채점자를 신뢰하지 않는다 — 직접 측정하고, 수치를 공개하며, 채점자가 기준에 미달하거나 측정 불가 항목이 통과로 처리되면 빌드를 실패시킨다.
  kappa, single pass, raw   : 0.455   <- what a one-shot judge gives you
  kappa, calibration, before: 0.577   <- FAILS the 0.60 gate
  kappa, calibration, after : 1.000   on the 22 of 24 calibration tickets the harness could measure
  measured / unmeasured     : 80 / 16   (coverage 0.833)
      order-dependent               14
      inside the uncertainty band    2
  pass rate, measured only  : 0.500
  pass rate, if UNMEASURED were counted as passes: 0.583   <- the number the gate refuses

gate
  PASS  kappa on the calibration set >= 0.60         1.000
  PASS  coverage >= 0.70                             0.833 (80/96 measured)
  PASS  no UNMEASURED item is counted as a pass      0 leaked
  => green
[EVIDENCE] 두 결과를 0.500 나란히 0.583 비교하면, 하니스가 실제로 측정할 수 있었던 80건에 대한 정직한 통과율은 0.500이고, 아첨하는 통과율은 0.583이다. 달라진 것은 16개의 판정불가 티켓을 조용히 통과로 처리했느냐 뿐이다. 8.3포인트의 차이 — 세 번째 상태를 구현하지 않은 시스템이라면 누구나 쉽게 얻을 수 있다. 거짓말이 필요 없다. 세상은 세 가지 값을 가지는데, 자료형은 두 가지뿐이기 때문이다.
make gate는 exit 0으로 종료된다.make negative는 결함을 다시 도입하고 exit 1을 요구한다:
gate  (negative test: unmeasured items deliberately counted as passes)
  FAIL  no UNMEASURED item is counted as a pass      16 leaked, first: TCK-1029, TCK-1034, TCK-1035
  => RED          # exit 1
한 번도 실패한 적 없는 게이트는, 게이트가 아예 없는 것과 구분되지 않는다 — 나는 이 원칙을 다른 시리즈에서 얻었고, 이제는 계측기를 신뢰하지 않는 벤치에 이 규칙을 적용했다.
30분 만에 구현하는 평가 벤치 — 실전 계약
엔지니어가 실제로 요구하는 순서에 맞춰, 벤치에 필요한 모든 구성 요소를 갖춘다. 입력: 사람이 직접 결과를 기록한 N개의 항목. 출력: 오직 하나, PASS · FAIL · UNMEASURED. 불변 조건: 증거가 없으면 측정되지 않은 것이며, 결코 통과로 간주하지 않는다. 중단 규칙: 게이트가 빌드를 실패 처리하며, 재시도는 없다.
GOLDEN   = [(item, human_label), ...]        # a human wrote these, not the model
CAL, TEST = GOLDEN[:24], GOLDEN[24:]         # calibration is HELD OUT of the score

def verdict(item, offset):
    a = judge(item, candidate_first=True)    # score, not a verdict
    b = judge(item, candidate_first=False)   # the SAME item, other order
    a, b = a - bias(item, offset), b - bias(item, offset)
    if (a >= T) != (b >= T):      return UNMEASURED, "order-dependent"
    if abs((a+b)/2 - T) < BAND:   return UNMEASURED, "inside the band"
    return (PASS if (a+b)/2 >= T else FAIL), "two orders agreed"

offset = mean(score | long, label=g) - mean(score | short, label=g)   # over CAL, per g

# CI gate (make gate)
#   kappa(verdicts, human_labels) on CAL   >= 0.60   else UNCALIBRATED
#   coverage = measured / graded           >= 0.70   else vacuously green
#   UNMEASURED items counted as passes     == 0      (make negative proves it bites)
# any line below threshold -> exit 1 -> the build fails
의도적으로 빠진 항목: 실시간 모델( judge() 을 임의의 엔드포인트로 교체), 항목별 근거 설명, 그리고 동점 판정을 위한 세 번째 채점자. 이 마지막 요소는 실수가 아니라 명확한 선택이다 — 동점은 정보다. 이 항목은 해당 채점자가 판정할 수 없음을 의미하며, UNMEASURED 가 바로 정직한 기록이다. 동점 판정자를 두면 이미 알려진 미지수를, 알 수 없는 것으로 바꾼 셈이 된다. 그 편이 오히려 더 나쁘다.
[DESIGN] 네 가지 설계 원칙이 이 벤치를 단순 데모가 아닌 실제 기업 환경에 적합하게 만든다:
- 보정(캘리브레이션) 항목은 점수 산정에서 완전히 제외된다.채점자가 평가 대상 항목에 맞춰 조정되면, 홀드아웃 세트가 존재하지 않는다 — Kapoor 등이 지적한 바로 그 결함이다. 24개의 보정 티켓은 절대 패스율 계산에 포함되지 않는다.
- 커버리지는 단순히 보고하는 것이 아니라, 게이트로 엄격히 관리된다. 하한선이 없다면, 하니스는 거의 모든 항목을 측정 불가로 선언해 원하는 어떤 카파 값도 만들 수 있다 — 즉, 아무것도 측정하지 않고 통과시키는 게이트가 된다.
- 세 번째 상태는 관례가 아니라 명시적 유형(type)이다.
UNMEASURED는PASS를 반환하는 동일한 함수에서 함께 반환되므로, 호출자가 그 존재를 잊을 수 없다. 관례는 시간이 지나면 흐려지지만, 유형은 사라지지 않는다.
[OPEN] 두 프로젝트 모두 증명하지 못한 한계. 두 골든 세트 모두 인공적으로 생성되었고, 두 채점자 모두 스텁이다. 감사 벤치의 카파 1.000은 22개 항목에서 나온 값 — 불확실성 구간이 제 역할을 했을 뿐, 완벽한 채점자는 아니다. n = 22에서는 탁월함과 단순한 행운을 구분할 수 없다. 이것이 바로 이번 시즌 내내 두 차례 경고했던, 범위 없는 1.000의 의미다. 정직한 상태: 실행 가능하고, 게이트로 엄격히 관리됨, 실제로 운영 중인 큐에서 실제 해결 결과가 기록된 티켓이 필요하다. 그리고 두 번째 인간 라벨러가 있어야 인간 간 kappa가 상한선을 제공한다. 1.000이 암묵적으로 상한이 되는 상황이 아니라.
같은 맥락, 다섯 갈래의 출구
하나의 중심축에서 독자마다 다른 문이 열린다. 각자 한 가지 결정을 내리고, 한 가지 행동을 실천하라.
| 당신이 | 이 글이 바꾸는 핵심 결정 | 이번 주에 실천할 수 있는 구체적 행동 |
|---|---|---|
| 고등학생 개발자라면 | "The eval passed"는 누가 채점했고, 얼마나 자주 맞았는지 밝히기 전까지는 사실이 아니다. | Colab 실습(2초, API 키 불필요)을 실행한 뒤, 챗봇의 답변 20개를 직접 라벨링하고, 그 답변에 대한 자체 채점 결과와의 kappa를 계산하라. |
| AI 엔지니어라면 | 당신의 에이전트 정확도는 채점자와의 일치도가 상한을 결정한다. 그리고 지금 당신의 채점자는 측정되지 않은 상태다. | 20개 항목을 직접 라벨링하고 kappa를 측정한 뒤, 위 계약의 게이트를 하나의 CI 작업에 추가하라. |
| 창업자라면 | 벤치마크 수치는 세 가지 사실이 한 겉옷을 입고 있는 셈이다. 아부하는 수치는 공짜지만, 정직한 수치는 골든셋 비용이 든다. | 핵심 흐름에서 pass@k와 pass^k를 나란히 요청하라. 팀에 k가 없다면, 그것이 바로 발견이다. |
| 임원이라면 | 신뢰성은 감사의 핵심 질문이다. 전체 항목 중 측정된 비율이 얼마이며, 라벨은 누가 작성했는가? | 다음 품질 리뷰에서 정확도 옆에 "커버리지와 라벨러 간 일치도"를 반드시 포함하라. |
| 투자자라면 | 진짜 경쟁력은 골든셋과 보정된 채점자에 있다. 팀이 임대한 모델이나 돈 주고 산 리더보드 순위가 아니다. | 어떤 에이전트 스타트업이든 인간 레이블과의 kappa, 그리고 pass^k를 나란히 요청하라. 둘 중 하나라도 빠지면 그건 보여주기에 불과하다. |
실전 과제
당신이 직접 운영하는 시스템을 대상으로 20분만 투자하라.
- 실제로 의존하는 AI 출력 하나를 고르라. 예를 들어 요약기, 라우터, 코드 리뷰어, 습관 추적기 등이 있다.
- 실제 출력 20개를 모아 직접 레이블링하라. 시스템이 자체적으로 부여한 점수를 보기 전에 통과 또는 실패로 구분하라.
- 동일한 20개에 대해 시스템이 내린 판정도 받아서 Cohen의 kappa를 계산하라. 산술 6줄이면 충분하며, 노트북의 첫 번째 셀에 있다.
- 20개 중 자신 있게 레이블링하지 못한 개수를 세어라. 그 숫자가 곧 당신의 커버리지 문제다.
- 채점자가 모델이라면, 다섯 항목을 두 가지 순서로 보여주고 판정이 바뀐 횟수를 세어라. 내 실험에서는 100개 중 50개가 뒤집혔다.
2단계가 어렵게 느껴진다면, 이미 가장 중요한 사실을 배운 것이다. 당신 팀에는 정확함에 대해 사람과의 대면을 견디는 정의가 없으며, 나머지 다섯 계층의 어떤 노력도 그 정의를 대신해주지 못한다.
연구 과제
이 과제를 에이전트에게 넘기되, 먼저 예측을 미리 명시하라.
검증 가능한 출력이 있는 작업군 하나를 골라, 두 사람이 독립적으로 레이블링한 100개짜리 골든셋을 구축하라. 보고할 것: 사람 간 kappa(상한선), 모델 판정자의 각 인간 대비 kappa, 그리고 (a) 순서 바꿔 재채점, (b) 20개 보정셋 적용, (c) 둘 다 적용 시 kappa 변화. 그 다음, 인간 레이블과 모델 판정자 각각에 대해 k=1,2,4,8일 때 pass@k와 pass^k를 모두 보고하고, 항목당 채점 비용도 기록하라.
미리 명시: 판정자의 인간 대비 kappa가 두 인간 간 kappa를 넘는지, 그리고 판정자의 오류가 pass^k를 pass@k보다 더 많이 왜곡하는지 여부.
내 예측을 실험 전에 기록한다. 사람 간 kappa가 실제 상한선이 될 것이고, 기대보다 낮을 것이다. 판정자의 편향은 pass^k를 여러 배로 왜곡하지만 pass@k에는 거의 영향을 주지 않을 것이다. 만약 반대 결과가 나오면, 그건 설정의 버그가 아니라 논문감인 불일치다.
최근 변화
이 계층의 최신 동향은 30개 선구적 소스의 주간 동기화에서 추출했다. research-anything (make watch-sync기술적 신호만으로 순위를 매겼으며, 대중성은 고려하지 않았다. 각 항목은 동기화일 기준 초록 페이지에서 직접 수집했다.
동기화일: 2026-09-11.
- arXiv:2609.11067 (2026-09-10) — 노이즈가 편향을 만들어낼 때. 3,822개의 고정관념 관련 응답을 다섯 가지 노이즈 조건에서 분석한 결과, 오타와 잘못된 문장부호는 중립적 사회 편향 판정을 편향된 것으로 바꿀 확률이 그 반대보다 최대 120배 높았다. 이 논문은 보도 시점 기준 하루 전 공개되었으며, 이번 글의 논의를 한층 더 깊게 만든다 — 편향 측정조차 고유의 오차를 가진 계측 도구임을 보여준다.
- arXiv:2608.29463 (2026-08-29) — 벤치마크 오염: 각 대응책을 무력화하는 유형별 분류. 다섯 가지 오염 유형을, 각 유형이 무력화하는 대응책 기준으로 분류했다. 비공개 홀드아웃 세트는 첫 번째 유형만 방어할 수 있다. 두 명의 외부 코더가 이 도구를 41개 문서에 적용한 결과, 변수별 가중 카파 값은 0.00에서 0.35까지 분포했다 — 측정의 신뢰도를 솔직하게 공개하며, 낮은 코더 간 일치도까지 논문에 명시한 사례다.
- arXiv:2608.26623 (2026-08-27) — AgentJudgeBench. 3,808개 사례, 20B부터 프런티어 규모까지 여섯 명의 판정자. 과제가 어려워질수록 정렬도는 1.5배 더 빠르게 저하되며, 정답이 없는 어려운 쿼리에서는 여섯 명 모두가 규모와 무관하게 77~82% 구간에 수렴한다. 구조화된 루브릭은 최대 6.5점까지 성능을 높이지만, chain-of-thought와 판정자 온도는 별다른 효과가 없다.
- arXiv:2608.24314 (2026-08-25) — 음성 에이전트 평가를 위한 LLM 판정자 벤치마킹. 동일한 상호작용을 세 가지 평가 구성에서 반복한 결과, 판정자의 신뢰도는 판정자 자체의 고유 특성이 아니라 메트릭과 평가 구성에 따라 달라지는 것으로 나타났다. 이른바 '보정 논의'가 통신 분야에서 AI 평가로 넘어온 셈이다.
- 기간 외 하루, 그래도 명명:arXiv:2608.11434 (2026-08-11) — MobileJudgeBench, 931개의 인간 주석 궤적: 단순한 기준선 판정자가 종종 목적 특화 파이프라인보다 더 나은 성능을 보인다.
[OPEN] 변하지 않은 점:아직 변화하지 않았다. 즉, 보정된 판정자가 실제로 운영 중인 시스템의 결과를 얼마나 바꾸는지 측정한 논문은 찾지 못했다. 위의 모든 결과는 판정자를 레이블과 비교한 것이지, 판정자가 잘못 판정했을 때 실제로 어떤 결과가 발생하는지까지 다루지는 않는다. 이 지점이 바로 이번 글의 연구 과제가 겨냥한 간극이며, 나는 문헌에서 이 공백을 메우지 못했다.
최종 테스트
스크롤 금지.
- 여섯 개 단계를 순서대로 쓰고, 왜 다섯 편 동안 여섯 번째가 이름 없이 남아 있었는지 설명하라.
- 채점자가 100개 중 79개 항목에서 내 라벨과 일치한다고 해서 충분하지 않다. 단순 일치율이 아니라, 우연 일치까지 보정한 Cohen의 kappa 값을 확인해야 한다. 79% 일치는 동전 던지기와 큰 차이가 없으니, 신뢰할 수 있으려면 kappa가 0.60 이상이어야 한다.
- 보고된 벤치마크 점수는 세 가지의 결합된 사실이다. 바로 에이전트의 행동, 채점자의 인간과의 합치도, 그리고 반복 실험에서 어떤 보고 규칙을 적용했는가이다. 하지만 실제로는 대부분 첫 번째만 보여준다.
- 채점자가 한 방향으로 편향되어 있으면 pass^k(모두 성공)는 pass@k(한 번이라도 성공)보다 훨씬 더 큰 영향을 받는다. pass^k는 모든 시도에서 성공해야 하므로, 편향이 누적되어 결과가 급격히 나빠진다.
- 채점자가 판정할 수 없는 항목은 '측정 불가'로 기록해야 한다. 이를 단순히 성공이나 실패로 처리하면, 실제 정보가 없는 항목이 성과로 집계되어 시스템의 신뢰도를 왜곡한다.
- 모든 입력에 대해 항상 PASS를 반환하는 입력이 대표적인 퇴화 입력이다. 이때 전체 성공률은 극대화되지만, Cohen의 kappa 같은 합치도 지표를 함께 보고하면 이런 퇴화 입력이 쉽게 드러난다.
다음 화 예고 — 그리고 이번 연재의 마지막
나는 골든셋을 직접 손으로, 일요일에 라벨링한다. 채점자는 0.899라는 값으로 돌아온다. 기준선을 넉넉히 넘는다. 벤치를 CI에 연결하고, 실패 테스트가 빨간색에서 초록색으로 바뀌는 과정을 지켜본다. 그날 오후만큼은 모든 문제가 해결된 듯한 착각에 빠진다 — 하지만 이쯤이면, 이 연재가 늘 뭔가 무너질 때 내는 소리다.
그러던 중, 누군가 내 여섯 단계 구조로는 해석할 수 없는 질문을 던진다: 애초에 이 에이전트가 그 행동을 해도 되는 일이었나?
‘제대로 했는가’가 아니다 — 내가 가진 모든 단계는 그 질문에는 답할 수 있다. 진짜 문제는 그 행동이 허용된 것이었는가이다. 누가, 어떤 권한으로, 어디에 기록했는가? 내 kappa 값이 아무리 훌륭해도, 보정된 채점자는 답이 라벨과 일치했는지만 알려줄 뿐, 그 라벨 자체가 목표로 삼을 만한 것이었는지는 전혀 말해주지 않는다.
이것은 새로운 단이 아니라, 경계선이다 — 다음 에피소드가 아니라, 그 다음의 질문이다.거버넌스가 평가 엔지니어링을 넘어선 가장 유력한 다음 후보이다. 누가 골든셋을 바꿀 수 있는가, 기준선이 무시될 때 누가 승인하는가, 에이전트가 행동할 때 어떤 감사 기록이 남는가 등이 모두 여기에 속한다. 그 다음은 경제, 그리고 조직이다. 미래 연재의 후보로, 이번 1화에서처럼 일단 기록만 남기고 논의는 나중에, 약속은 영원히 미루기로 한다.
진짜 결론은 더 간결하다. 여섯 단계, 한 문장씩, 매번 같은 구조로 정리한다: 프롬프트는 명세, 컨텍스트는 예산, 하니스는 봉투, 루프는 심판, 그래프는 일정, 그리고 평가는 진리 함수다. 이 중 어느 것도 마법이 아니다. 여섯 모두는 기록의 대상이고, 마지막 것만이 나머지 다섯이 기록할 가치가 있었는지 판단할 수 있다. 다음에는 여기서 시작하라. 모두가 마지막에야 구축하는 단계이자, 모든 것이 그 위에 서 있던 토대다.
이어 읽을 추천
제7기, 제6편 — Intelligence Engineering Adventures, Season 7 — The Kitchen Ladder, 그리고 이번 기수의 마지막. 시리즈의 모든 주장은 정의, 도출, 근거, 엔지니어링 선택, 미해결 질문 등으로 분류 태그가 붙는다. 비유는 주장을 소개할 수 있지만, 그 자체로 근거가 되지는 않는다. 각 편마다 Colab 무료 티어에서 API 키 없이 실행되는 노트북과, 표준 라이브러리만으로 처음부터 만든 두 가지 애플리케이션(개인용, 기업용)이 함께 제공된다. 다섯 단계 사다리는 Feng 외(arXiv:2608.21156)의 것이며, 내 고안이 아니다. 여섯 번째 단계는 2026-09-05 외부 리뷰어의 제안으로 여기서 처음 이름 붙였고, 제1편에서 공개 후보로 기록됐다. 'what moved' 섹션은 30개 선구적 소스의 실시간 주간 동기화에서 기술적 신호만으로 순위가 매겨진다(청중 도달 범위는 고려하지 않는다). 본 글에는 어떤 고용주나 의뢰인의 자료도 포함되어 있지 않다. — Paul Jialiang Wu · futuremake.io
참고문헌
- Kapoor, S., Stroebl, B., Siegel, Z. S., Nadgir, N., Narayanan, A. (2024). AI Agents That Matter. arXiv:2407.01502, 2024-07-01 제출. — arXiv 초록 페이지에서 영어 원문 인용(2026-09-11 열람): 정확성에만 좁게 집중한 점, 벤치마킹 요구의 혼동, 불충분한 홀드아웃 세트.
- Zheng, L., Chiang, W.-L., Sheng, Y. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. arXiv:2306.05685, v4 2023-12-24 개정. — arXiv 초록 페이지에서 영어 원문 인용: 세 가지 명시된 편향과 80% 초과 일치율 수치.
- Yao, S., Shinn, N., Razavi, P., Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv:2406.12045, 2024-06-17 제출. — arXiv 초록 페이지에서 영어 원문 인용: pass^k, 그리고 리테일에서 pass^8이 25% 미만.
- Liang, P., Bommasani, R., Lee, T. et al. (2022). Holistic Evaluation of Language Models. arXiv:2211.09110, v2 개정 2023-10-01. — 초록에서 17.9%에서 96.0%로의 시나리오 커버리지 변화와 7가지 평가 지표를 확인함.
- Chang, Y., Wang, X., Wang, J. 외 (2023). 대형 언어 모델 평가에 관한 종합 조사. arXiv:2307.03109, v9 개정 2023-12-29. — 초록에서 what/where/how 구조와 "평가를 독립된 학문 분야로 다뤄야 한다"는 논지를 확인함.
- Jimenez, C. E., Yang, J., Wettig, A. 외 (2023). SWE-bench: 언어 모델은 실제 GitHub 이슈를 해결할 수 있는가? arXiv:2310.06770, v3 개정 2024-11-11. — 초록에서 2,294개 과제와 1.96% 수치를 확인함.
- Husain, H. (2024-03-29). Your AI Product Needs Evals. hamel.dev/blog/posts/evals/. — 라이브 포스트에서 직접 인용(2026-09-11 열람): 성공하지 못한 LLM 제품의 공통 근본 원인.
- Anthropic (2026-01-09). Demystifying evals for AI agents. anthropic.com/engineering. — 라이브 포스트에서 직접 인용: eval의 정의와 CI/CD에서의 자동화된 eval.
- OpenAI. Evals. github.com/openai/evals. — 저장소 2026-09-11 열람; 직접 인용 없이 설명.
- Angulo, J., Yeste, V., Espinos-Morato, H. (2026). Benchmark Contamination: A Taxonomy Organized by Defeated Mitigation. arXiv:2608.29463, 2026-08-29 제출. — arXiv 초록 페이지에서 원문 인용: 리더보드는 모델과 점수를 공개한다.
- Verma, A., Saha, A. K., Subramanian, S., Aluru, S. H. (2026). AgentJudgeBench: 에이전트형 툴 호출에서 LLM 판정자를 평가하는 다중 난이도 벤치마크. arXiv:2608.26623, 2026-08-27 제출. — 77–82% 구간과 평가 기준(루브릭) 효과를 확인하기 위해 초록을 열람함.
- Purwar, A., Singh, S., Srivastava, K. (2026). 음성 에이전트 평가를 위한 LLM 판정자 벤치마킹: 신뢰도, 보정, 인간 감독. arXiv:2608.24314, 2026-08-25 제출. — 초록 열람.
- Ryu, D., Lee, J., Hwang, Y., Bak, J. (2026). When Noise Fabricates Bias: LLM-as-a-Judge 편향 측정의 노이즈 취약성. arXiv:2609.11067, 2026-09-10 제출. — 120배 비대칭성 관련 초록 열람.
- Wang, Z., Gu, L., Chi, Z. 외 (2026). 모바일 에이전트 평가를 위한 LLM 판정자 벤치마킹. arXiv:2608.11434, 2026-08-11 제출. — 초록 열람; 본 글의 'what moved' 기간에서 하루 벗어난 논문임을 명시.
- Goodhart, C. A. E. (1984). Problems of Monetary Management: The UK Experience. 수록. Monetary Theory and Practice, Palgrave, London. link.springer.com. — 1975년 논문 재수록; 유료 접근이므로 설명만 제공, 인용문 없음.
- Strathern, M. (1997). 'Improving ratings': audit in the British University system. European Review 5(3), 305–321. doi:10.1017/S1062798700002660. — Goodhart에게 흔히 귀속되는 슬로건의 실제 출처이나, 유료로 접근해야 하므로 인용 대신 설명으로 대체함.
- Landis, J. R., Koch, G. G. (1977). The Measurement of Observer Agreement for Categorical Data. Biometrics 33(1), 159–174. doi:10.2307/2529310. — 관례적 카파 구간의 원 출처이나, 유료로 접근해야 하므로 인용 대신 설명으로 대체함.
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2, 2026-08-26 개정. — 이번 시즌이 기존 5단계 구조에 한 단계를 더해 확장한 근거가 된 논문.
- Dhage, S. (2026). Harness Engineering for Predictable Agentic Systems. arXiv:2608.26197, 2026-08-25. — Episode 1의 핵심 측정값으로, 빈 응답에서 결정성 지표가 1.000으로 나오는 사례로 인용됨.
- Wu, P. J. (2026-08-06). One Opinion Wearing Ten Hats. futuremake.io. — 본인의 공개 저작물: 패널은 채점 함수이며, 채점 함수는 외부 기준에 맞춰 보정되거나 그렇지 않으면 '비보정'으로 명시되어야 한다는 주장.
- Wu, P. J. (2026-08-21). The Rubric That Could Not Fail. futuremake.io. — 내 공개 저작물: 23점 만점에 23점을 받은 것이 오히려 결함이었던 사례와, 정직하게 25/28을 기록하게 만든 적대적 기준에 관한 글이다.
- Wu, P. J. (2026-07-23). Verify Your Verifier. futuremake.io. — 내 공개 저작물: 이번 글의 불변 규칙이 된 하니스 규칙에 관한 글 — 어떤 주장도 인용이 실제로 확인되고, 그 근거가 주장 강도를 뒷받침할 때만 검증된 것으로 간주하며, 그렇지 않으면 입증되지 않은 것으로 본다.
- Wu, P. J. (2026-09-11). Lab 06 — 진리 함수: 판정자 드리프트와 pass^k, with
the-report-cardandthe-audit-bench. gist.github.com/wjlgatech/752a9450…. — Notebook과 Projects 절의 모든 수치는 2026-09-11에 직접 실행한 실험 결과에서 가져왔다.