SERIE AI-NATIVE · PRESENTAR IA AGÉNTICA, PARTE 2 DE 3
Vender agentes esta temporada: acotados, responsables, guiados por evidencia
Resumen de 1 minuto
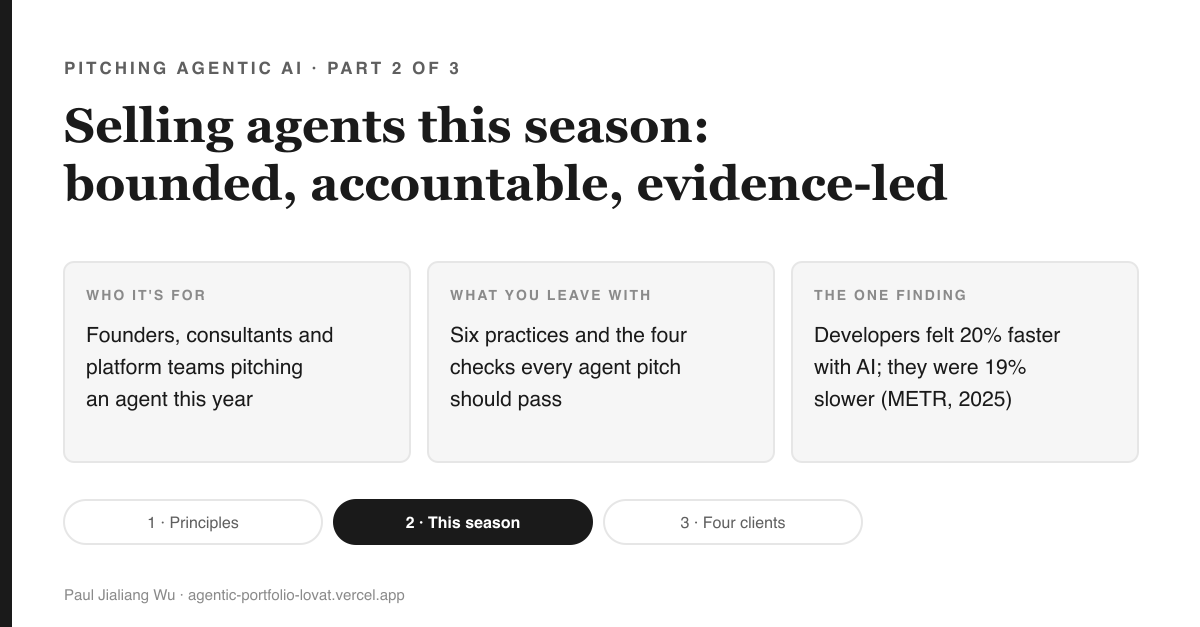
Qué es esto. Parte 2 de la serie: la práctica de esta temporada para presentar agentes de IA, y cuatro comprobaciones que toda propuesta debería superar: específica, dimensionada con honestidad, con un responsable a cargo, medida de antemano.
Por qué importa. En un ensayo aleatorizado de 2025, desarrolladores experimentados fueron un 19% más lentos usando herramientas de IA, y aun así creían haber sido un 20% más rápidos (METR). Una promesa genérica de productividad es la afirmación que la evidencia respalda menos.
Qué puedes hacer después de leer esto. Pasa tus cuatro líneas por las cuatro comprobaciones y luego escribe una frase para la persona que puede decir que no: qué puede tocar el agente y quién lo aprueba.
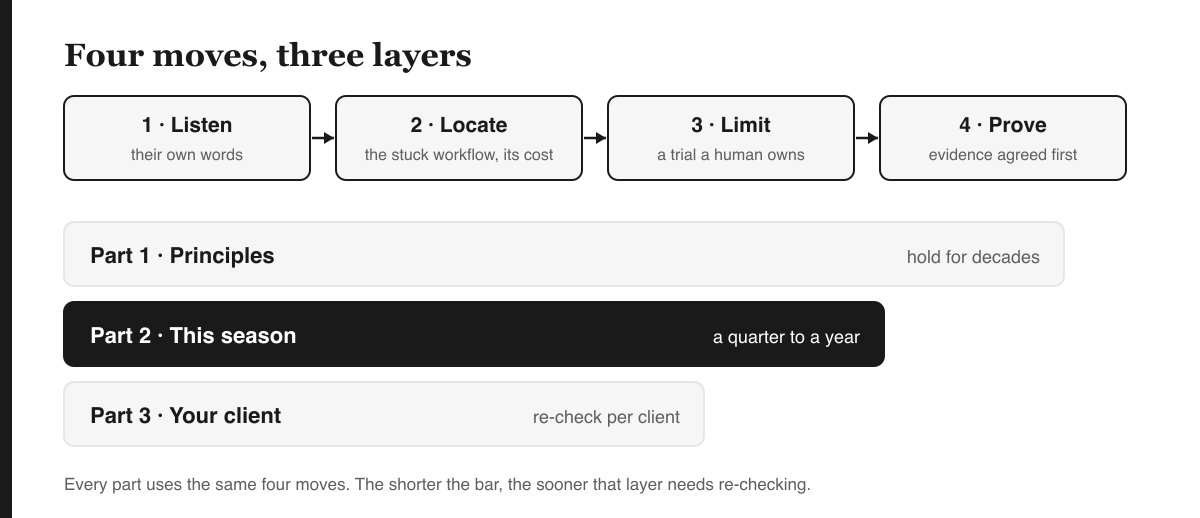
Pitching Agentic AI — la espina de la serie
- Principios que sobreviven a cualquier presentación episodio 1
- Vender agentes esta temporada este episodio
- Cuatro clientes, cuatro primeros flujos de trabajo episodio 3
Cómo leer las etiquetas: EVIDENCE tiene fuente, DESIGN es una práctica recomendada, OPEN todavía no está probada, y LENS es mi propia convicción.
Los pilotos de IA empresarial suelen estancarse, y cómo se delimitan explica buena parte de ese porqué. Seis prácticas para 2025–26, construidas alrededor de una sola idea: elige un flujo de trabajo atascado, y deja que una medida emparejada, acordada de antemano, haga la venta por ti. La sorpresa: los mejores ensayos sobre herramientas de IA para programar no coinciden entre sí.
Qué cubre este episodio: cómo presentar un agente de IA en este momento
Los principios de la Parte 1 apenas cambian. Esta capa cambia más o menos cada año: cómo compran los compradores, qué dice la evidencia en este momento y qué preguntan sobre gobernanza. Es para cualquiera que esté presentando un agente a una empresa este año, ya sea el fundador de una startup, un consultor o un equipo interno de plataforma. Trabajo en Accenture, que aparece en uno de los estudios más abajo; lo aclaro cuando corresponde. Todo lo que sigue es mi propia síntesis a partir de fuentes públicas.
Apuesta primero
En un ensayo aleatorizado de 2025, desarrolladores experimentados de código abierto trabajaron en tareas reales dentro de sus propios repositorios, con y sin herramientas de IA. Antes de empezar, predijeron que la IA los haría un 24% más rápidos aproximadamente. Con IA, sus tareas tardaron:
- A. Alrededor de un 20% menos de tiempo.
- B. Más o menos el mismo tiempo.
- C. Un 19% más de tiempo.
Práctica 1: califica antes de ofrecer
EVIDENCE Las ventas empresariales formalizaron esto hace mucho tiempo. MEDDIC, una lista de verificación que los profesionales remontan a PTC en los años noventa, pide métricas, un comprador económico, criterios de decisión, un proceso de decisión, el problema del cliente y un patrocinador interno. La historia de su origen es saber popular del oficio y no está verificada en detalle, pero sobrevive por una razón sencilla: un trato sin responsable y sin una medida acordada rara vez se cierra, por buena que sea la demo.
DESIGN Para una prueba de agente, añado cuatro preguntas propias. ¿Hay un responsable designado para el resultado? ¿Puede el equipo dar acceso y contexto? ¿Hay un revisor con tiempo para juzgar el resultado? ¿Es el trabajo repetible lo suficiente como para acotarlo, con una forma de verificarlo? Si falta alguna, es motivo para pausar y resolverla, no para seguir adelante.
Práctica 2: elige un flujo de trabajo bajo presión
DESIGN El trabajo de ingeniería estancado suele verse como una de cuatro cosas. Las llamo las cuatro Erres:
| El trabajo estancado se ve como | Síntoma típico | Una primera tarea acotada | |---|---|---| | Esperar | revisiones y aprobaciones se acumulan | primera revisión contra la propia lista de verificación del equipo | | Rehacer | retrabajo, pruebas inestables, pipelines que se vuelven a correr | diagnóstico de ejecuciones fallidas de CI para un servicio | | Reaprender | contexto perdido entre personas, código antiguo que nadie conoce | explicar y documentar un módulo heredado, solo lectura | | Reexplicar | traspasos, documentación desactualizada, preguntas repetidas | redactar un manual de procedimiento a partir del historial de un incidente |
Elige una fila, para un equipo. Ni tan acotado como el autocompletado, ni tan amplio como la automatización a nivel de toda la empresa, que no es más que la diapositiva 7 con presupuesto.
Práctica 3: habla con cada persona que puede decir que sí, o que no
DESIGN El mismo flujo de trabajo estancado significa algo distinto para cada una de cuatro personas:
- El responsable del presupuesto (CTO, VP de ingeniería): capacidad, calidad, confianza en el lanzamiento.
- El responsable de la plataforma: consistencia, experiencia del desarrollador, menos investigación repetida.
- El responsable de las fechas (producto): menos compromisos incumplidos, lanzamientos más predecibles.
- La persona que puede decir que no (seguridad, riesgo, calidad): qué puede tocar el agente, quién aprueba, qué queda registrado.
La mayoría de las propuestas se dirigen a las primeras tres. En los tratos que he visto estancarse, solía ser la cuarta persona la que nunca recibió una sola frase.
Práctica 4: reivindica solo lo que la evidencia respalda
EVIDENCE Sobre la apuesta: la respuesta es C. En el ensayo aleatorizado de METR de 2025 (16 desarrolladores experimentados, 246 tareas en sus propios repositorios), permitir herramientas de IA hizo que las tareas tomaran un 19% más de tiempo, y los desarrolladores, después, seguían creyendo que la IA los había hecho aproximadamente un 20% más rápidos (Becker et al., METR, 2025). METR dijo después que una repetición del experimento arrojó solo una señal débil, porque muchos desarrolladores ya no estaban dispuestos a trabajar sin IA, y que ahora cree que es probable que los desarrolladores estén ganando más velocidad que antes (METR, Uplift update, feb. 2026).
EVIDENCE El otro lado: experimentos de campo en tres empresas, incluida Accenture (mi empleador), con 4.867 desarrolladores, encontraron alrededor de un 26% más de tareas completadas (pull requests, no "productividad") con una herramienta de autocompletado de código con IA, con mayores ganancias para los desarrolladores menos experimentados (Cui et al., The Effects of Generative AI on High-Skilled Work, 2024–25). La encuesta DORA 2025 de Google, con unos 5.000 profesionales, encontró que el uso de IA se asocia con mayor rendimiento, pero también con menor estabilidad en las entregas: la IA amplifica lo que ya existe (DORA 2025 announcement).
DESIGN Estos resultados no se contradicen entre sí una vez que se leen según el contexto y la época: autocompletado de código para una población amplia en 2022–23, desarrolladores experimentados en bases de código maduras con herramientas de principios de 2025, y sistemas de entrega completos. Por eso "productividad del desarrollador" es la promesa equivocada, y una afirmación específica de un flujo de trabajo con una medida acordada es la honesta.
Práctica 5: emparejar una señal de velocidad con una señal de calidad
EVIDENCE Que un piloto llegue a producción depende en gran medida de cómo se construya. El estudio de 2025 de MIT NANDA, basado en entrevistas, encuestas e implementaciones públicas, reportó que "external partnerships with learning-capable, customized tools reached deployment ~67% of the time, compared to ~33% for internally built tools" (Traducción: las asociaciones externas con herramientas personalizadas capaces de aprender alcanzaron el despliegue ~67% de las veces, frente a ~33% para las herramientas construidas internamente), y el propio informe señala que las cifras son autoinformadas (MIT NANDA, The GenAI Divide, 2025; una copia ampliamente difundida del informe). Su a menudo citado "95%" cuenta organizaciones que obtienen retorno cero, no pilotos fallidos.
EVIDENCE Los proveedores están moviendo sus precios hacia los resultados: Intercom cobra $0,99 por resolución con su agente Fin (Intercom pricing), y Salesforce cobra por Agentforce según conversación o acción (Agentforce pricing). Cada proveedor define "resultado" a su manera.
DESIGN Esta es la jugada de Comprobar, llevada hasta el final. Acuerda una señal de velocidad y una señal de calidad juntas, con el umbral y quién las revisa: el tiempo de respuesta de la revisión junto con los defectos que se escapan, el tiempo de documentación junto con las pruebas aceptadas sin cambios. La velocidad sola se puede manipular. Las revisiones se vuelven más rápidas volviéndose más superficiales, y todos lo celebran hasta la revisión del incidente.
Práctica 6: deja que la forma de la prueba responda la gobernanza
EVIDENCE Los compradores ahora llegan con una lista de verificación de gobernanza. La EU AI Act exige obligaciones aplicables a los modelos de IA de propósito general desde agosto de 2025 (EU AI Act implementation timeline), y el AI Risk Management Framework del NIST es la referencia común en Estados Unidos (NIST AI RMF).
DESIGN Una prueba acotada responde la mayoría de las preguntas de gobernanza por su propia forma. Di qué puede tocar el agente, quién aprueba cada salida, qué queda registrado y cuándo un especialista revisará la configuración y los controles. Si la respuesta a "¿qué puede tocar?" necesita un párrafo, la prueba es demasiado grande.
Cuatro verificaciones antes de presentar tu propuesta
- Específica: un flujo de trabajo, un equipo.
- Dimensionada con honestidad: "podría valer la pena evaluarlo", no una transformación prometida.
- A cargo de una persona: los ingenieros conservan la responsabilidad sobre la calidad y las aprobaciones.
- Medida de antemano: una señal de velocidad y una de calidad, con un umbral, acordadas antes de empezar.
Cómo podría fallar esto
- La evidencia está cambiando. METR revisó su propio panorama en cuestión de meses. Cualquier cifra aquí puede estar desactualizada cuando la leas, así que verifica la fecha antes de citarla.
- La calificación puede convertirse en una excusa. "Todavía no está listo" a veces es cierto y a veces es un vendedor evitando una cuenta difícil. Anota qué pregunta falló y cuándo volverás a hacerla.
- La cuarta persona sigue diciendo que no. Es una pregunta abierta qué tan rápido las empresas terminarán de definir sus políticas de IA; un piloto limitado ayuda, pero no elimina la espera.
- Las cuatro Erres son mi lente, no una ley. Ordenan el trabajo estancado que he visto; el de tu cliente puede no encajar, y vale la pena saberlo desde temprano.
Tu tarea de esta semana
Toma las cuatro líneas que escribiste en la parte 1. Pásalas por las cuatro comprobaciones. Luego escribe una oración para la persona que puede decir que no: qué puede tocar el agente y quién lo aprueba. Si no puedes escribirla, no estás listo para proponer un piloto.
Siguiente
La parte 3 adapta todo esto para cuatro industrias donde los errores salen más caros: servicios financieros, ciencias de la vida, manufactura industrial, y tecnología y telecomunicaciones. Cada una recibe el problema, el responsable, las reglas y un primer flujo de trabajo que encaja.
Fuentes
- Becker, J., et al. "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity." METR, arXiv:2507.09089, July 2025. (Traducción: «Midiendo el impacto de la IA de principios de 2025 en la productividad de desarrolladores experimentados de código abierto».)
- METR. "Uplift update." 24 February 2026. (Traducción: «Actualización de mejora».)
- Cui, Z., Demirer, M., Jaffe, S., Musolff, L., Peng, S., Salz, T. "The Effects of Generative AI on High Skilled Work: Evidence from Three Field Experiments with Software Developers." SSRN 4945566 (2024; revised 2025). (Traducción: «Los efectos de la IA generativa en el trabajo altamente calificado: evidencia de tres experimentos de campo con desarrolladores de software».)
- Google Cloud. "Announcing the 2025 DORA report." 23 September 2025. (Traducción: «Anunciando el informe DORA 2025».)
- MIT NANDA. "The GenAI Divide: State of AI in Business 2025." July 2025. (Traducción: «La brecha de la IA generativa: el estado de la IA en los negocios 2025».)
- Intercom, página de precios; Salesforce, página de precios de Agentforce. Ambas revisadas en octubre de 2026; los precios cambian con frecuencia.
- Cronología de implementación de la EU AI Act (artificialintelligenceact.eu); NIST AI Risk Management Framework 1.0, enero de 2023.
- Procedencia: motivado por una sesión de capacitación sobre agentes de codificación a la que asistió el autor en 2026; las prácticas, la tabla y las comprobaciones son síntesis propia del autor a partir de las fuentes públicas citadas arriba.