AI-Native 시리즈 · 에이전트 엔지니어링 · 루프 엔지니어링 실전
거짓말하지 않는 AI PR 리뷰
주장별 증거, 침묵 대신 "unmeasured", 그리고 자동 머지를 위한 경로 제한. 휴먼 리뷰가 병목이 된 레포지토리에서, 모델에게 머지 버튼을 넘기려는 이와 이를 요청한 공동 창업자를 위해 쓴 빌드 보고서다.
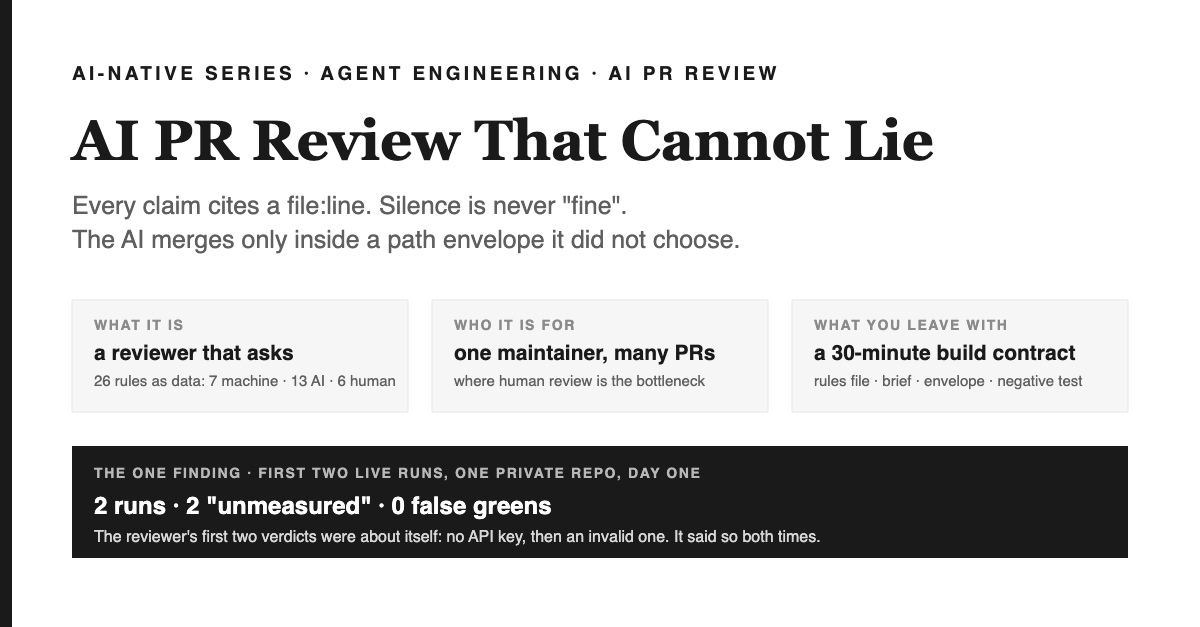
1분 요약 — 이 글을 읽고 얻어갈 것
무엇인가. 제조 품질관리 코드베이스에서AI PR 리뷰에 대한 빌드 보고서다. 한 명의 메인테이너가 모든 PR을 머지했고, 어떤 PR도 리뷰를 받은 적이 없었다. 모델은 각 풀 리퀘스트를 읽고 하나의 브리프를 게시한다. 스스로의 판단으로 승인할 수 없고, 파일과 라인 번호 없이 주장을 할 수 없으며, 실행에 실패했을 때 침묵할 수도 없다.
왜 이게 중요한가. 엔지니어 입장에서는, AI 리뷰어가 근거 없는 지적을 지어내거나, 실패했을 때 조용히 넘어간다면 차라리 리뷰어가 없는 편이 낫다. 그런 도구는 팀 전체가 무시하는 법을 배우게 만든다. 창업자에게 "자동 머지"란 모델의 품질 문제가 아니라, 어디까지 영향이 미칠지(블라스트 레디우스)를 데이터 파일에 명확히 박아두는 결정이다. 이 설계는 그 영향 범위를 모델이 손댈 수 없는 데이터 파일로 고정한다. 학생에게는, 게이트와 장식의 차이를 가르는 단 하나의 습관—초록불을 신뢰하기 전에 일부러 빨간불을 내보는 습관—을 실제로 구현한 사례다.
이 글을 읽고 나면 할 수 있는 일. 30분이면 이 구조를 그대로 따라 만들 수 있다. 3단계(기계, AI, 사람)로 나뉜 규칙 파일, 증거 필터가 적용된 8개 섹션의 브리프, 거부 우선(deny-wins) 방식의 경로 범위, 자동 머지를 위한 5개 AND 조건, 그리고 실제 적용 전에 반드시 돌려보는 결함 유발 테스트까지. 30분 만에 구축하기가 바로 그 계약서이고, day-one 섹션은 잘못된 키로도 그 계약이 어떻게 지켜지는지 보여준다.
이 보고서의 범위와, 왜 AI PR 리뷰에는 다른 설계가 필요한가
이 글은 일주일간의 작업을 정리한 기록이다. 내가 함께 일하는 팀은 "사람이 하는 PR 리뷰"가 반복 속도의 유일한 병목이라고 판단했고, 나에게 두 가지를 같은 날 맡겼다. 저장소에 자동 리뷰어를 배포할 것, 그리고 그 리뷰어가 집행하는 리뷰 기준을 문서화할 것. 이 저장소는 공장 품질관리시스템(QMS)으로, 모든 기록이 나중에 고객 감사를 위한 증거로 소환될 수 있다. 그래서 리뷰의 무게가 특별하게 커진다. 머지된 버그는 단순한 버그가 아니라, 허위 기록이 된다.
설계의 핵심 질문은 "모델이 코드를 리뷰할 수 있나"가 아니다. 모델은 이미 쓸 만큼 코드를 리뷰한다. 진짜 질문은, AI PR 리뷰가 열 번째 PR 이후에도 팀의 신뢰를 받으려면 반드시 금지해야 할 것이 무엇인가다. 내 답은 네 가지 금지와 하나의 경로 제한이고, 이 글 전체가 그 다섯 가지와 그 근거에 대한 이야기다:
- 리뷰어는
file:line파일:라인 근거 없는 주장을 할 수 없다. 근거 없는 주장은 모두 버리고, 그 개수를 브리프에 명시한다. - 리뷰어는 침묵할 수 없다. 키가 없거나, 모델이 거부하거나, API 오류가 나면—각각 "unmeasured"와 "this is not 'no problem'"라는 코멘트가 반드시 게시된다.
- 리뷰어는 이미 스크립트가 결정한 사항을 다시 판단하지 않는다. 테넌트 분리, 시크릿, 마이그레이션, 외래키, 이중언어 문서, 테스트, 골든 케이스 라이브러리는 계산한 스크립트의 결과를 그대로 브리프에 첨부한다.
- 리뷰어는 사람 판단 전용 목록을 이유 없이 비워둘 수 없다. "사람이 판단할 것이 없음"이라는 결과에는 반드시 이유가 따라야 하며, 그렇지 않으면 "리뷰어가 실행되지 않았다"로 읽힌다.
- 리뷰어는 자신이 선택하지 않은 경로 범위 안에서만, 그리고 다섯 개 AND 조건 중 하나로서만 머지를 트리거할 수 있다.
이 글의 독자는 한 명의 메인테이너와 여러 에이전트를 운영하는 AI 엔지니어, "자동 머지"가 어디까지 영향을 미칠지 결정해야 하는 창업자, 그리고 게이트가 단순 설치물이 아니라 어떻게 정직하게 작동하는지 보고 싶은 학생이다. 비유는 문제 설명 뒤에 등장한다. 한 분야의 한 그림—음식이 나가기 전 세 번의 검증을 거치는 레스토랑 주방—으로 설명한다.
아무것도 만들기 전에 측정한 병목
리뷰어를 제안하기 전에 저장소의 실제 수치를 먼저 확인했다. "리뷰가 느리다"와 "리뷰가 아예 없다"는 전혀 다른 해결책이 필요하기 때문이다. 머지된 PR 24개, 모두 같은 사람이 작성. 23개는 작성자가 직접 머지. 내가 샘플링한 8개 PR에는 리뷰 기록이 0. 외부 기여자가 올린 오픈 PR 9개 모두 리뷰 0, 가장 오래된 것은 16일째 대기. 기록상 미디언 머지 시간 6분은 빠른 리뷰가 아니라, 작성자가 자기 PR을 바로 머지한 결과였다.
설계에 영향을 준 사실이 두 가지 더 있다. 지난달 CI가 11일간 조용히 실패했는데, 모든 잡이 2초 만에 0스텝으로 죽었다. 계정의 Actions 시간이 다 떨어졌기 때문이었고, 아무도 눈치채지 못했다. 왜냐하면 스텝 없는 빨간불은 멀리서 보면 실패한 빨간불과 구분이 안 되기 때문이다. 그리고 저장소는 무료 프라이빗 플랜이어서 브랜치 보호가 전혀 없었다. 초록불이든 빨간불이든 누구나 머지할 수 있었고, 그걸 막는 유일한 장치는 기억뿐이었다.
Google이 자사 실무를 분석한 연구에서는 900만 건의 리뷰 로그를 분석했다 [5]; 한 번도 실행된 적 없는 프로세스는 그런 로그도, 그런 학습도 남기지 않는다. 실제 상황은, 한 번도 실행된 적 없는 리뷰 프로세스에 외부 PR 9개가 한 사람을 통해 들어오려는 참이었고, 집행 장치도 없었다. 가끔 근거 없는 지적을 만들어내거나, 가끔 조용히 실패하는 리뷰어가 투입된다면, 체크하는 습관이 없는 팀에선 아무도 눈치채지 못한다. 그래서 금지 조항이 프롬프트보다 먼저 온다.
비유: 레스토랑 주방의 세 번 검증
이 설계를 관통하는 이미지는 주방이다. 그것도 '레스토랑을 운영한다'는 단계의 주방이다. 제대로 된 주방에서 한 접시가 손님에게 나가기까지는 세 번의 관문을 거친다. 이 관문들은 엄격함의 정도가 아니라, 그 역할 자체가 다르다.
| 주방에서 | 저장소에서 |
|---|---|
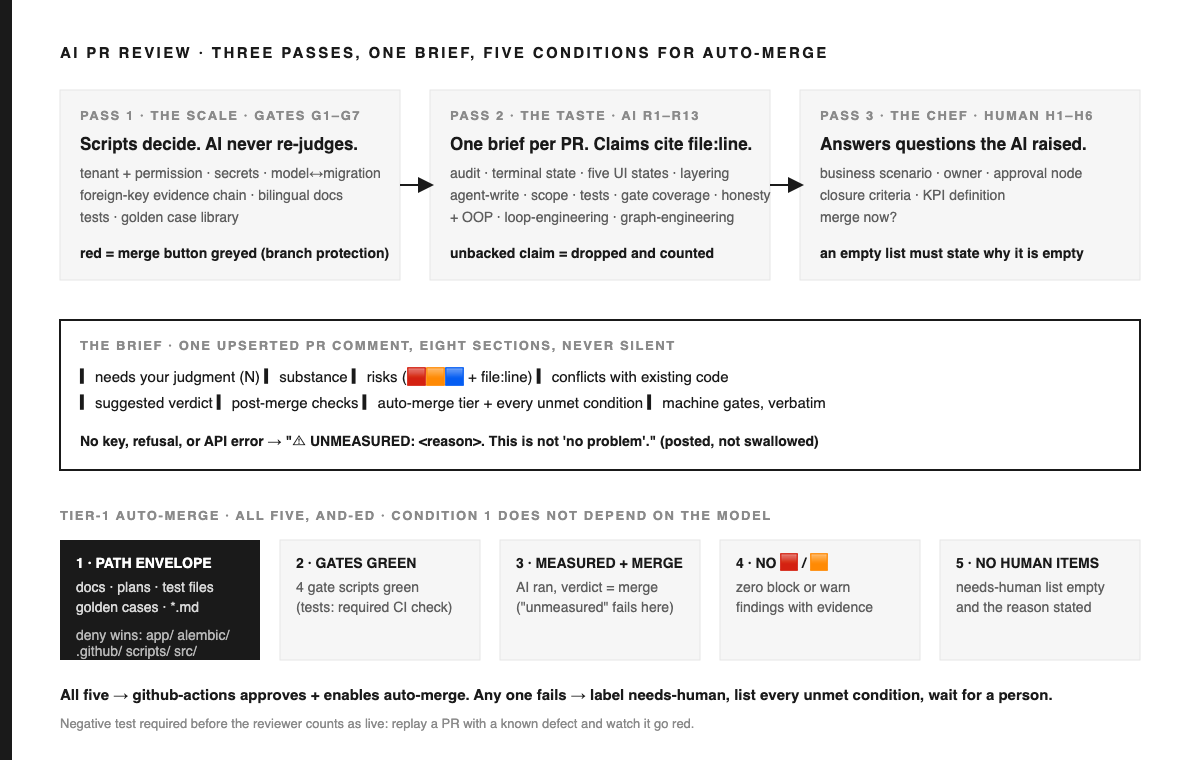
| 저울, 온도계, 주문표 확인.저울은 의견이 없다. 무게가 맞지 않으면, 누가 만들었든 그 접시는 절대 나가지 않는다. | 기계 게이트 1번부터 7번까지.이미 존재하는 자동화 스크립트들: 테넌트와 권한 AST 검사, 시크릿 형태 스캔, 모델-마이그레이션 연결, 외래키 증거 체인, 이중언어 문서 매칭, 테스트, 골든 케이스 라이브러리. 브랜치 보호가 걸려 있으면, 빨간색이 머지 버튼을 비활성화한다. |
| 수셰프가 소스를 맛보고 쪽지를 남긴다: "세 번째 국자에 소금이 많음; 오늘 밤 이대로 내보낼지는 당신의 몫." 이 쪽지는 기분이 아니라 정확히 어느 국자인지 짚는다. | AI 사전 리뷰 1번부터 13번까지.PR마다 브리프가 하나씩 붙는다. 모든 지적 사항은 반드시 근거를 명시한다.file:line사람만이 답할 수 있는 질문을 던지고, AI는 스스로 집행할 수 없는 판정을 제안한다. |
| 셰프는 쪽지를 읽고, 그 한 숟갈을 맛본 뒤 내보낼지 말지 결정한다. | 사람만 판단하는 항목 1번부터 6번까지.비즈니스 시나리오, 책임자, 승인 단계, 종료 기준, KPI 정의, 즉시 머지 여부. 코드 오너는 브리프에서 제기된 항목에만 답한다. |
| 차가운 스타터와 드레싱수셰프가 이미 맛본 것은 셰프 없이도 나간다. 잘못된 드레싱은 환불이 아니라 다시 만들면 그만이기 때문이다. | 1단계 자동 머지.문서, 계획, 테스트 파일, 골든 케이스 등은 경로 기준으로 블라스트 반경이 낮다. 네 가지 추가 조건까지 충족되면, 봇이 승인하고 자동 머지를 활성화한다. |
| 뜨거운 요리는 반드시 셰프를 거친다.언제나 그렇다. 수셰프가 아무리 확신해도 스테이크는 '보내라'고 하지 않는다. | 애플리케이션 코드, 마이그레이션, CI, 스크립트, 프론트엔드 소스는 절대 자동 머지 범위에 포함되지 않는다. AI의 평가는 참고일 뿐, 머지의 트리거가 아니다. |
주방이 이렇게 돌아가는 이유가 바로 리뷰어도 이렇게 설계된 이유다. 수셰프의 쪽지가 접시를 내보내는 기준이 되는 순간, 요리사들은 쪽지에 맞춰 요리하기 시작한다. AI의 판정이 머지 조건이 되는 순간, 기여자들은 AI를 만족시키는 PR을 쓰기 시작한다. 쪽지는 쪽지로, 저울은 저울로 남겨두는 것—이것이 양쪽 모두의 정직함을 지키는 방법이다.
리뷰어가 절대 해서는 안 되는 네 가지 금지 사항
1. 파일과 줄 번호 없는 주장은 무효
모델은 JSON 스키마로 제약된 구조화된 출력을 반환한다.[4]각 항목에는 규칙 id, 심각도, 주장, 그리고evidence 배열이 포함된다. 렌더링 전에 필터가 모든 항목을 순회하며,path:line 경로가 PR에서 변경된 파일이거나 해당 커밋 시점에 리포지토리에 존재하는 경우에만 증거 문자열을 남긴다. 증거가 하나도 남지 않은 항목은 제거되고, 카운터가 올라간다. 브리프 마지막에는 "파일:줄 증거 없는 주장 N개가 삭제됨"이라는 문장이 붙는다.
여기서 중요한 점이 두 가지 있다. 첫째, 경로는 PR에서 수정하지 않은 파일을 가리킬 수도 있다. "기존 코드와 충돌" 같은 항목은 바로 그런 오래된 파일에 증거가 남아 있기 때문이다. 증거를 diff로만 제한하면 가장 가치 있는 범주가 사라진다. 둘째, 이 카운트는 숨기지 않고 출력한다. 리뷰어가 자기 출력의 절반을 조용히 버린다면, 그 보정 상태를 사용자가 반드시 알아야 한다.
시스템 프롬프트는 이렇게 못 박는다. "증거 없는 주장은 시스템이 버리니, 만들어내기보다 적게 말하라." 이 필터가 그 문장을 선언이 아니라 사실로 만든다.
2. 'unmeasured'는 반드시 게시되는 상태이며, 침묵은 허용되지 않는다
첫 번째 브리프 버전은 API 키가 없을 때 기계 게이트 결과만 출력하고 나머지는 아무것도 없었다. 마치 이견 없는 리뷰어처럼 보였는데, 이것이 리뷰어가 낼 수 있는 가장 위험한 출력이다. 외부에서는 "문제 없음"과 "실행 안 됨"이 똑같은 코멘트로 보이기 때문이다.
이 문제의 해결책은 건너뛸 수 없는 분기다. 자격 증명이 없거나, 모델이 거부 사유로 중단하거나, API에서 예외가 발생하거나, 구조화된 출력이 파싱에 실패하면, 브리프는 "unmeasured"라는 제목의 섹션을 만들고 정확한 원인을 적는다. 이어서 "this is not 'no problem'"라는 문장, 기계 게이트 결과, 그리고 모든 human-only 항목이 이제 사람의 판단을 필요로 한다는 안내가 붙는다. 워크플로우는 이 상태도 그대로 게시한다. 각 문구는 단위 테스트로 고정되어 있어, 리팩터링이 조용히 침묵 버전을 복구하지 못한다.
3. 기계 게이트는 결과만 첨부하고, 재판정하지 않는다
게이트는 총 일곱 개(G1~G7)가 있다. 테넌트 필터링과 권한 의존성 확인을 위한 라우터 AST 패스, 추가된 라인에 대해 위치만 보고 값을 출력하지 않는 시크릿-셰이프 스캐너, 모델-마이그레이션 페어링, 모든*_id 컬럼에 대한 외래키 게이트, 이중언어 문서 페어링, 테스트 슈트, 그리고 결정적 모듈이 표준 출력을 반드시 재현해야 하는 골든 케이스 라이브러리다. 리뷰어는 이 중 여섯 개를 결정하는 네 개의 스크립트를 직접 실행한다. 제출 게이트 스크립트가 시크릿, 마이그레이션 페어링, 이중언어 문서를 한 번에 처리하기 때문이다. 일곱 번째인 테스트 슈트는 별도의 CI 잡에서 실행되며, 리뷰어가 반복하지 않는다. 따라서 브리프에는 "machine gates" 아래 네 줄의 스크립트 결과가 출력되고, 이 네 줄이 G1~G5와 G7을 커버한다. 리뷰어는 마지막 여섯 줄의 결과로 통과/실패를 기록하고, 모델에게는 "이건 이미 결정된 것이니 다시 판단하지 말라"는 지침과 함께 넘긴다.
이렇게 하는 이유는 모델이 틀릴까 봐서가 아니다. 결정적 체크에 대한 이중 판단은 노이즈일 뿐이고, 브리프에 노이즈가 쌓이면 사람들은 읽기를 멈춘다. 마이크로소프트의 현대 코드 리뷰 현장 연구에서도, 리뷰어들은 결함 찾기보다 이해에 더 많은 노력을 쏟는다고 밝혔고, 초록에 이렇게 썼다:
"Our study reveals that while finding defects remains the main motivation for review, reviews are less about defects than expected and instead provide additional benefits such as knowledge transfer, increased team awareness, and creation of alternative solutions to problems."(번역: 본 연구는 결함 발견이 리뷰의 주요 동기임에도, 실제 리뷰는 예상보다 결함 자체보다는 지식 이전, 팀 인식 제고, 문제에 대한 대안 창출 등 추가적인 이점을 더 많이 제공함을 보여준다.)
— Bacchelli and Bird, ICSE 2013, author's copy[6]
사람 리뷰어가 주로 이해를 쌓는다면, AI 브리프가 저울 수치를 반복하는 것은 이미 스크립트가 결론 내린 한 가지에 독자의 주의를 소모시키는 셈이다. 모델의 주의력은 스크립트가 닿지 못하는 곳에 써야 한다. 예를 들어, 종료 액션이 감사 기록을 남기는지, 생성 엔드포인트가 터미널 상태에 도달할 수 있는지, 라우터가 비즈니스 로직을 수행하는지, PR 설명의 주장에 증거가 붙어 있는지 등이다.
4. 비어 있는 human-only 목록은 반드시 이유를 밝혀야 한다
브리프의 첫 번째 섹션은 "needs your judgment"이며, 코드 오너가 반드시 읽어야 하는 유일한 부분이다. 이 섹션이 비어 있으면, 모델은 반드시 그 이유를 동반 필드에 채워야 하고, 렌더러는 "empty; reason: …" 형태로 출력한다. 그렇지 않으면, 빈 섹션은 모델이 해당 질문을 아예 고려하지 않은 것과 구분이 안 된다. 이는 두 번째 금지 원칙을 더 세밀하게 적용한 것으로, 부재가 의미를 가지는 일은 절대 허용하지 않는다.
규칙은 데이터로 관리하며, 실제 규칙이 된 세 가지 원칙
26개의 규칙은 오직 하나의 JSON 파일에만 존재한다. 프롬프트에도, 문서에도 복사본이 없다. 각 규칙에는 id, 티어, 제목, 체크할 내용, 결정 주체(게이트 또는 사람), 그리고 출처가 명시된다. 문서 페이지의 표는 이 파일에서--render-rules 명령어로 생성되고,--check-docCI에서 이 명령어를 실행하면, 문서의 표와 파일에서 렌더링한 표가 한 글자라도 다르면 빌드가 실패한다. 프롬프트에도 같은 표가 그대로 전달된다. 세 곳에서 쓰지만, 소스는 하나라서 불일치가 생길 일이 없다.
7개 규칙은 기계 판정용으로, 각 규칙마다 어떤 스크립트가 책임지는지 명확히 적혀 있다. 테스트에서는 이 스크립트들이 실제로 존재하는지 검증한다. 과거 이 저장소에는 문서에만 있고 실제로는 구현되지 않은 시크릿 스캐너가 있었기 때문이다. 6개는 사람 판정용으로, 프로젝트의 15개 모듈 체크리스트에서 가져왔다. 여기에는 '이게 실제로 어떤 공장 문제를 해결하는가'처럼 diff만으로는 답할 수 없는 항목들이 포함된다. 13개는 AI 판정용이다. 이 중 10개는 프로젝트의 엔지니어링 원칙에서 실제로 검증 가능한 잔여물이다. 예를 들어, 주요 액션에 대한 감사 기록, 생성 엔드포인트에서 도달할 수 없는 터미널 상태, 5가지 UI 상태, 라우터는 오케스트레이션만 담당, 모든 AI가 접근 가능한 쓰기는 사람이 서명, 단일 책임, 구현 로그 존재, 순수 로직 변경에 대한 테스트, 게이트 커버리지, 그리고 설명과 증거의 일치 등이 있다.
마지막 세 가지 규칙은 공동 창업자가 '우리의 OOP, 루프 엔지니어링, 그래프 엔지니어링 원칙에 따라 리뷰해 달라'고 요청해서 추가했다. 대화에만 존재하는 원칙은 규칙이 아니므로, 아래와 같이 명문화했다.
| 규칙 | 리뷰어가 확인하는 내용 |
|---|---|
| R11 OOP | 새 클래스나 함수에는 하나의 책임만 둘 것. 기존 도메인과 클로즈드 루프 계층은 복사하지 말고 재사용할 것. 비즈니스 규칙은 데이터베이스 없이 테스트 가능한 순수 함수로 작성할 것. 라우터는 오케스트레이션만 담당할 것. |
| R12 루프 엔지니어링 | 새 게이트, 규칙, 자동화는 반드시 의도적으로 실패(빨간불)를 낼 수 있는 방법과 함께 배포할 것. 상태 기계는 터미널 상태와 롤백을 가져야 한다. 어떤 판정도 한 번의 명령으로 재실행할 수 있어야 한다. 'unmeasured'는 'passed'와 별도로 집계한다. |
| R13 그래프 엔지니어링 | 모든 새로운 *_id는 외래 키를 선언해야 한다. 모듈 간 효과(공급업체 시정조치에 대한 불만, SPC 위반에서 프로세스 이슈로, 반품에서 근본 원인으로)는 인라인으로 작성하지 않고 반드시 클로즈드 루프 훅을 통해 전달해야 한다. 모든 기록은 원본 문서와 책임자까지 추적 가능해야 한다. |
R12는 이 글 자체에 적용된 규칙이기도 하다. 그래서 다음 두 섹션이 존재한다.
엔벨로프: 신뢰도가 아니라 경로가 결정한다
팀의 요청은 기준을 충족하는 PR은 사람 개입 없이 머지되게 하라는 것이었다. 이전 설계에서는 AI가 절대 머지 조건이 되어서는 안 된다고 했다. 둘 다 일리가 있지만, 해결책은 그 사이의 타협이 아니라 완전히 다른 변수에 있다. 'AI의 판정이 머지를 유발해야 하는가'라는 질문은 어느 쪽이든 나쁜 답을 낳는다. '어디까지가 잘못된 머지가 리메이크(재작업)로 끝나고, 어디부터가 환불(심각한 손실)로 이어지는가'라는 질문에는 데이터로 답할 수 있다.
엔벨로프는 규칙 파일에 정의된 두 개의 경로 프리픽스 리스트다. 허용되는 경로: 문서, 계획, 골든 케이스 파일, 테스트 디렉터리, 그리고 .md로 끝나는 모든 파일. 거부(deny)는 허용(allow)보다 우선한다: 워크플로 디렉터리, 스크립트 디렉터리, 애플리케이션 패키지, 마이그레이션, 프론트엔드 소스, Makefile, 그리고 두 개의 agent-guide 파일. 워크플로 디렉터리 아래의 마크다운 파일도 거부된다. 애플리케이션 패키지 아래의 테스트 파일도 거부된다. 이 리스트는 모델이 선택하는 것이 아니라, 모델의 답변 이후에 적용된다.
Tier-1에서는 다섯 가지 조건이 모두 충족되어야 한다. 모든 변경 경로가 엔벨로프 안에 있을 것, 모든 게이트 스크립트가 통과(그린)일 것(브리프의 네 줄; G6인 테스트 슈트는 GitHub의 auto-merge가 자체적으로 대기하는 필수 상태 체크), AI 리뷰가 머지 판정으로 측정될 것, block 또는 warn 심각도의 판정이 0개일 것(세 번째 레벨인 info는 브리프에만 표시되고 티어에는 영향 없음), 그리고 휴먼 전용 리스트가 비어 있을 것. 다섯 가지 모두 충족되면 워크플로가 Actions 계정으로 PR을 승인하고 GitHub의 auto-merge를 활성화한다. 필수 체크가 끝나면 자동으로 머지된다. 하나라도 실패하면 PR에 'needs human' 라벨이 붙고, 브리프에는 충족되지 않은 모든 조건이 나열된다(첫 번째 조건만 표시하지 않음). 이 마지막 포인트는 단위 테스트에서 나왔다. 첫 구현은 첫 실패에서 바로 반환했기 때문에, 기여자는 '경로가 엔벨로프 밖'을 고치고 다시 실행해야만 warn 레벨 판정이 있다는 사실을 알 수 있었다. 세 가지 이유가 있으면 세 가지 모두 출력해야 한다.
GitHub의 두 가지 설정이 봇의 승인을 유효하게 만든다. 저장소에서 Actions가 pull request를 승인할 수 있도록 허용해야 하고 [3], 그리고 브랜치 보호 [1]는 승인자가 코드 오너일 필요가 없어야 한다. Actions 계정은 코드 오너가 아니기 때문이다. auto-merge 자체는 GitHub의 기능 [2]이고, 워크플로는 단지 이를 활성화할 뿐이다. code-owners 파일은 여전히 리뷰 요청을 사람에게 라우팅한다. 보호 스크립트는 코드 오너 요구 조건을 끈 상태에서 하나의 필수 승인으로 기본 설정되어 있고, 적용 후 두 저장소 설정을 모두 출력한다. 무료 플랜에서는 auto-merge 설정이 조용히 무시되기 때문에, 읽어들이지 않는 스크립트는 거짓말하는 스크립트다.
첫날: 리뷰어의 첫 두 판정은 자기 자신에 대한 것이었다
워크플로가 PR로 배포되었고, 그 PR이 리뷰어가 처음으로 리뷰한 대상이었다. 저장소에는 아직 API 키가 없었다. 브리프에는 이렇게 적혔다. "unmeasured: ANTHROPIC_API_KEY missing (repository secret not configured). This is not 'no problem'." 그 아래에는 네 개의 게이트 스크립트가 모두 통과 상태였고, 티어 라인에는 'needs human'이 표시됐다. 변경된 경로에 워크플로와 스크립트 디렉터리가 포함되어 있었고, AI 리뷰가 측정되지 않았기 때문이다.
공동 창업자가 시크릿을 추가했다. 다음 PR, 즉 경로 범위(envelope)를 추가하는 PR이 두 번째로 리뷰 대상이 되었다. 브리프에는 이렇게 적혀 있었다: "unmeasured: AuthenticationError 401, invalid x-api-key." 같은 등급, 같은 두 가지 이유에 더해 세 번째 이유가 추가됐다. 플랫폼에 전달된 키가 실제로는 플랫폼에서 허용하지 않는 키였던 것이다.
이것을 당혹스러운 실수로 남기지 않고, 설계가 의도한 대로 부하를 받은 첫날의 결과로 기록한다. 만약 리뷰어가 두 번 모두 조용히 넘어갔다면, 겉보기엔 검토된 것처럼 보이지만 실제로는 검토되지 않은 PR 두 개가 남았을 것이다. 하지만 실제로는 두 PR 모두 AI가 실행되지 않았다는 점, 그 이유, 그리고 그것이 인간에게 어떤 의미인지 명확하게 남겼다. 이 메커니즘은 두 PR 모두 자동으로 머지하지 않았다. 두 PR 모두 경로 범위 밖이었고, 두 번째 조건도 충족하지 못했다. 잘못된 초록(거짓 승인)은 0개다. 범위는 두 번의 실행, 하나의 저장소, 하루다.
같은 날, 한 단계 아래에서 또 다른 조용한 실패가 있었다. 브랜치 보호는 프라이빗 저장소에서 유료 기능이고, 이미 업그레이드를 구매한 상태였다. 그런데 API는 유료 업그레이드임에도 10분 내내 403을 반환했고, 오토머지 설정은 다시 false로 돌아갔다. 보호 스크립트는 이런 경우 업그레이드 URL과 함께 비정상 종료한다. 시치미 떼지 않는다. 계정 단위의 원인은 이 글을 쓰는 시점에도 진단 중이며, 이것이 마지막 조건의 솔직한 상태다. 이 내용이 각주가 아니라 본문에 있는 이유는 브리프가 "unmeasured"를 명시적으로 게시하는 것과 같다.
패턴, 안티패턴, 그리고 첫 번째 원칙
유효했던 패턴 증거를 스키마 필드로 두고, 실제 존재하는지로 필터링하며, 드롭된 개수를 출력한다. 실패 상태는 반드시 별도 섹션으로 표시되고, 결코 '없음'으로 대체되지 않는다. 결정적 검사는 해당 스크립트에서 직접 첨부하고, 모델이 재해석하지 않는다. 규칙은 하나의 데이터 파일에만 존재하며, 동일한 함수로 프롬프트와 문서에 렌더링되고, CI에서 드리프트 체크가 이루어진다. 블라스트 반경은 경로 프리픽스와 deny-wins 방식으로 표현되며, 모델의 응답 이후 적용된다. 충족되지 않은 모든 조건이 나열된다. 첫 번째 조건만 보여주지 않는다.
이 패턴들이 대체한 안티패턴 승인만 하는 리뷰어. "문제 없음"을 의미하기 위해 섹션을 생략하는 브리프. 인용 대신 신뢰도 점수를 사용하는 것. 프롬프트에만 존재하고 문서에 또 다른 사본이 있는 규칙. 자격 증명이 없을 때 조용히 건너뛰는 것. 세 가지 이유가 모두 참일 때 한 가지만 보고하는 조기 반환. 이런 것들은 모두 그럴듯한 초안처럼 보이지만, 열 번째 PR쯤에는 리뷰어를 무시하기 쉽게 만든다.
첫 번째 원칙, 한 문장으로 리뷰 신호는 그 부재와 실패가 모두 드러나고, 주장들이 신뢰 없이 검증될 수 있을 때만 읽을 가치가 있다. 이 글의 나머지 모든 내용은 그 문장을 머지 버튼에 적용한 것이다.
30분 만에 구축하기
이것은 코드가 아니라 계약이다. 코드는 저장소마다 다르지만, 계약은 그대로 옮길 수 있다. 30분은 이 표를 새 저장소에 복사하는 데 필요한 예산이고, 실제로 측정한 시간은 아니다. 여기의 셸은 한 번에 작성했고, 테스트와 두 문서, 그리고 첫날 실행이 나머지 하루를 채웠다.
| 요소 | 명세 |
|---|---|
| 입력 | PR의 머지 기준점 대비 diff. 위험도 순(애플리케이션 코드 우선)으로 정렬되고, 문자 수로 제한된다. 누락된 파일은 모두 브리프에 이름이 명시된다. PR 제목과 본문. 각 기계 게이트의 통과/실패 및 마지막 6줄 출력. 규칙 파일에서 렌더링된 규칙 테이블. |
| 출력 | 구조화된 객체:needs_human[] 규칙, 질문, 이유 포함;needs_human_empty_reason; substance; risks[] 그리고conflicts[] 규칙, 심각도({block, warn, info}), 주장, evidence[] 포함;verdict {merge, hold, request_changes} 중 하나;verdict_reason; post_merge_checks[]; global_notes[]. 8개 섹션(판단 필요, 실질, 위험, 충돌, 판정, 머지 후 체크, 오토머지 등급, 기계 게이트)으로 구성된 하나의 마크다운 코멘트로 렌더링된다. 숨겨진 마커가 있어 재실행 시 덧붙이지 않고 수정한다. |
| 불변 조건 | 모든 파인딩은 최소 하나 이상의 evidence 문자열이 path:line 와 일치해야 하며, 해당 경로가 실제로 존재해야 한다. 브리프는 실패한 경우까지 포함해 매번 게시된다. 기계 게이트 결과는 원문 그대로 첨부된다. 휴먼 리스트가 비어 있을 때는 반드시 그 이유가 함께 적힌다. |
| 중단 규칙 | 모델은 PR 이벤트마다 단 한 번만 호출한다. 거부나 파싱 실패가 발생해도 재시도 루프는 없으며, 이런 경우는 "unmeasured"로 처리된다. 오류가 나도 작업은 계속되어, 리뷰어 장애가 머지를 막지 않고 그대로 드러난다. |
| 최소 스키마 | 하나의 규칙 파일:{id, level ∈ {block, ai, human}, title, check, gate, source} (기계 계층은 파일에서 block 로 표기되고, 머지 버튼에 미치는 효과 뒤에 위치한다) 그리고 auto_merge: {allow_prefixes, allow_suffixes, deny_prefixes}. 이것이 전체 구성의 전부다. |
| CI 기준선 | 자동 머지는 다섯 가지 조건이 모두 충족될 때만 실행된다. doc-drift 체크(--check-doc)는 필수 정적 게이트다. 리뷰어의 자체 작업은 필수 체크가 아니다. |
| 일부러 뺀 것들 | 재시도 없음, 두 번째 모델 판정 없음, 신뢰도 점수 없음(파인딩은 증거가 있으면 남고 없으면 버려진다), 규칙별 가중치 없음, 과거 PR에서의 학습 없음. 각각은 첫 버전이 영리함을 얻는 대신 감사 가능성을 잃는 자리다. |
| 결함 삽입 테스트 | 실제 적용 전에는, 결함이 심어진 PR을 재실행한다. 이 저장소에서는 create 엔드포인트가 closed 상태를 직접 받지 못하게 한 수정이 그 후보이다. 해당 코드 파일 세 개를 되돌리면, 라우터를 가리키는 block 레벨 R2 파인딩이 반드시 나와야 한다. 이게 빨간불이 되지 않으면, 라이브로 간주하지 않는다. 이 테스트는 유효한 키를 대기 중이다. |
# The whole loop, from a PR event
diff, omitted   = collect_diff(merge_base, changed_files)      # risk-ordered, capped, omissions listed
gates           = run_machine_gates(base)                       # scripts decide; last 6 lines kept
review          = call_model(meta, files, diff, gates, rules)   # structured output, one call, no retry
review, dropped = filter_findings(review, files)                # path:line or it is gone; count kept
tier, reasons   = classify_tier(brief, envelope)                # five conditions, all reasons listed
brief           = render_brief(...)                             # never silent; unmeasured is a section
post_comment(pr, brief); apply_tier(pr, tier)                   # upsert; approve + auto-merge only on tier-1
같은 맥락, 다섯 가지 관점
| 독자 | 딱 하나의 결정 | 딱 하나의 행동 |
|---|---|---|
| 학생 | 게이트는 직접 빨간불이 켜지는 걸 보기 전까진 진짜 게이트가 아니다. | 당신이 의존하는 체커가 있다면, 일부러 체크 대상을 망가뜨려 실제로 실패하는지 확인하라. 실패하지 않으면, 그건 장식품일 뿐이다. |
| 엔지니어 | 증거는 프롬프트에서 요청하는 게 아니라, 스키마로 강제하는 제약이다. | evidence[] 필드를 리뷰어의 출력에 추가하고, 존재 여부로 필터링한 뒤, 드롭된 개수를 출력하라.path:line |
| 창업자라면 | 자동 머지는 블라스트 반경에 대한 결정이다. 반경을 데이터 파일에 명확히 기록하라. | 프롬프트를 쓰기 전에 허용·거부 경로 목록부터 만들고, 거부가 항상 우선하도록 설계하라. |
| 경영진이라면 | "리뷰가 존재한다"와 "리뷰가 실제로 실행되었다"는 전혀 다른 주장이다. 실행된 쪽을 반드시 측정하라. | 리뷰 기록이 0인 PR의 개수, 그리고 "unmeasured"를 보고한 리뷰어 실행 횟수를 요청하라. |
| 투자자라면 | 일부러 심은 결함에서 리뷰어가 빨간불을 내는 팀은 진짜 리뷰 프로세스를 가진 팀이고, 초록불만 보여주는 팀은 그저 스크린샷만 있는 팀이다. | 네거티브 테스트 결과를 직접 보여달라고 요구하라. |
무엇이 측정되었고, 무엇이 아직 측정되지 않았는가
- 측정된 것. 14개의 단위 테스트가 증거 필터, unmeasured 렌더링, envelope의 deny-wins 논리, 5가지 조건의 티어 로직과 누적 사유, 그리고 문서 드리프트 체크를 고정한다. 실제 PR 두 건의 라이브 실행에서 두 번 모두 "unmeasured" 브리프가 나왔고, 무음 출력은 없었다. 두 PR 모두 명시된 이유로 needs-human으로 분류되었다.
- 아직 측정되지 않은 것. 네거티브 테스트(의도적으로 심은 결함이 block 수준의 finding을 내는 것)는 PR로 열려 있고, 유효한 키가 등록되면 실행된다. 빨간불이 들어오기 전까지 리뷰어는 설치만 되었을 뿐, 자체 규칙상 라이브가 아니다. 티어-1의 긍정 경로(문서만 변경된 PR이 봇에 의해 승인·병합되는 것)는 브랜치 보호에 막혀 있고, 이는 계정 플랜 이슈로 인해 차단되어 있다. 실제 코드에서 AI finding의 정밀도에 대한 수치는 아직 없다. 증거 필터는 바닥선일 뿐, 측정값은 아니다.
- 비유적 설명. 주방이라는 모델. 구조만 일대일로 대응될 뿐, 실제 데이터는 아니다.
이어 읽을 거리
다음 시리즈의 일부AI-Native Series · 에이전트 엔지니어링. 이 글에 등장하는 수치는 해당 문맥에 한정된다. 주방은 하나의 비유일 뿐, 실제 계측값이 아니다. 규칙 파일, 리뷰어, 워크플로, 보호 스크립트, 그리고 여기서 설명한 테스트들은 모두 비공개 저장소에 존재한다. 위에서 모든 구조를 빠짐없이 재현했으니, 접근 권한이 없어도 본문의 내용을 온전히 따라갈 수 있다.
참고문헌
- GitHub Docs. 보호 브랜치에 대하여. docs.github.com — 필수 상태 검사, 필수 리뷰, 그리고 비공개 저장소에서 보호 기능의 플랜별 제공 여부.
- GitHub Docs. 풀 리퀘스트 자동 병합하기. docs.github.com — 1단계 자동 병합이 의존하는 동작.
- GitHub Docs. 저장소의 GitHub Actions 설정 관리. docs.github.com — 워크플로가 풀 리퀘스트를 승인할 수 있도록 하는 설정.
- Anthropic. 구조화된 출력. docs.anthropic.com — 증거 필터가 작동하는 스키마 제약 응답.
- Sadowski, C., Söderberg, E., Church, L., Sipko, M., Bacchelli, A. (2018). Modern Code Review: A Case Study at Google. ICSE-SEIP, DOI 10.1145/3183519.3183525. research.google · author's copy (PDF) — 본문에서 직접 인용하지 않고 설명함: 12건의 인터뷰, 44명 대상 설문조사, 900만 건의 코드 리뷰 기록을 분석함.
- Bacchelli, A., Bird, C. (2013). Expectations, Outcomes, and Challenges of Modern Code Review. ICSE 2013. author's copy (PDF) — 위 인용문은 이 사본의 초록에서 발췌했으며, PDF와 단어 하나까지 대조함; IEEE 공식판은 서체 등에서 차이가 있을 수 있음.